

Python遍历目录与批量处理pcap文件实战
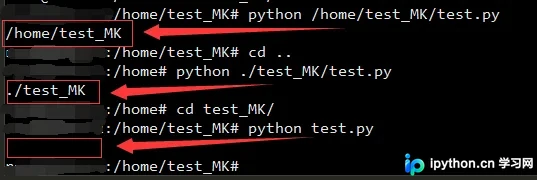
本文介绍如何使用Python遍历指定目录并批量处理同类文件。通过os.path模块获取当前路径、列出文件及区分目录与文件。以pcap文件为例,演示如何过滤特定后缀名,并利用dpkt库解析数据包的五元组信息(源/目的IP及端口)。文章提供完整代码示例,涵盖路径获取、文件过滤、数据包解析及命令行参数处理,帮助开发者实现自动化文件处理流程。
2026-10-13
12

本文介绍如何使用Python遍历指定目录并批量处理同类文件。通过os.path模块获取当前路径、列出文件及区分目录与文件。以pcap文件为例,演示如何过滤特定后缀名,并利用dpkt库解析数据包的五元组信息(源/目的IP及端口)。文章提供完整代码示例,涵盖路径获取、文件过滤、数据包解析及命令行参数处理,帮助开发者实现自动化文件处理流程。
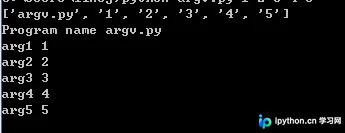
本文介绍如何在 Python 脚本中通过命令行传入参数。核心方法利用 sys 模块获取 sys.argv 列表,其中索引 0 为脚本名,后续索引依次对应传入的参数值。通过遍历列表即可处理多个参数,适用于各类需要外部配置的场景。
本文详细讲解如何在Django项目中配置连接Oracle数据库,包括在settings.py中设置DATABASE参数,以及如何利用ORM创建数据模型。内容涵盖从基础配置到处理外键关系、多对多关系的具体代码示例,帮助开发者快速实现Django与Oracle的交互。
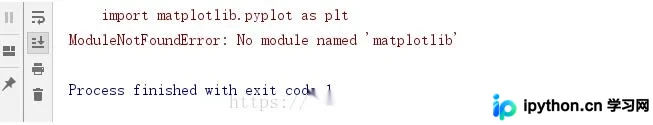
本文解决PyCharm中已下载matplotlib包但运行代码仍提示找不到模块的问题。通过检查项目解释器路径,并在Edit Configuration中将Python interpreter路径设置为当前文件默认路径,即可修复ModuleNotFoundError错误。
本文详细解析Python中模块和包的导入机制,对比import与from...import两种方式的语法差异、调用方式及适用场景。重点说明__init__.py文件在包导入中的作用,以及如何在不同层级间正确引用函数与变量,帮助开发者避免常见的导入错误。
本文提供基于Python的批量处理文件与文件夹的完整代码示例。通过os.walk遍历目录,结合shutil实现文件的批量移动至新建子文件夹,以及根据特定关键词批量删除同名文件夹的功能。代码包含详细注释,适用于需要自动化整理大量分散文件的场景,可直接替换路径参数运行。
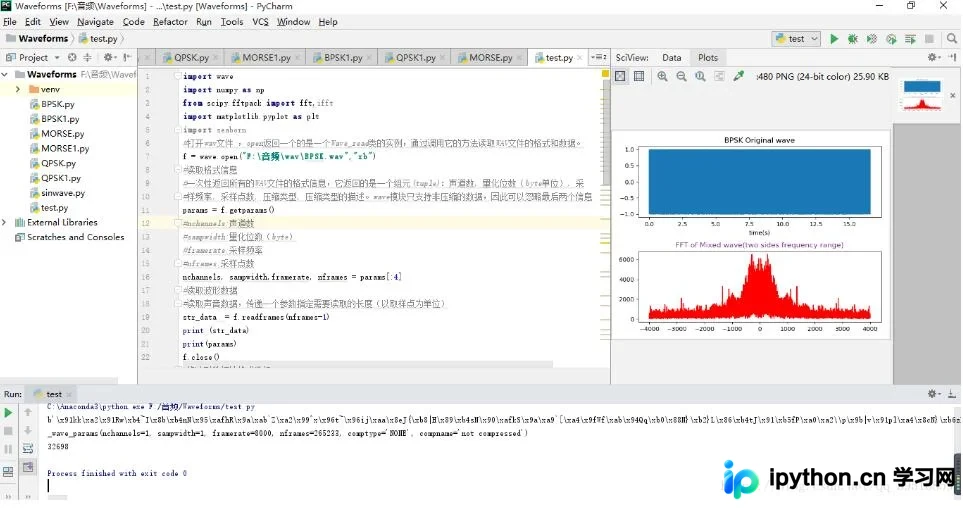
本文介绍在PyCharm中运行Python绘图程序时,因启用“Python Scientific”模式导致Figure窗口无法弹出的解决方法。通过进入Settings取消该选项勾选,即可恢复正常绘图显示,适用于重新安装Anaconda3及PyCharm后的环境配置问题。
本文深入解析Python类中__getitem__和__getattr__两个核心魔术方法的实现原理。__getitem__允许对象像字典一样通过方括号访问属性,而__getattr__则在属性查找失败时触发。文章结合具体代码示例,详细说明了属性取值、赋值及删除时的内部调用顺序与行为差异,帮助开发者理解对象属性访问机制。
本文介绍如何使用Python生成符合特定规则的16位贷款卡号。该卡号前三位为数字或大写字母,中间十位为数字,后两位为基于前十四位加权求和计算的校验码。文章详细解析了权重分配、字母转数字及补零逻辑,并提供完整可运行的Python代码示例,适用于Web系统测试中一次性卡号的需求场景。
本文详细解析Python中pickle模块的基本用法,涵盖数据序列化和反序列化操作。重点介绍pickle.dump()和pickle.load()函数的参数细节,包括协议版本(0、1、2及-1)的区别与选择,以及文件对象的打开模式要求。通过完整代码示例展示如何将Python对象永久存储至文件并重新加载,适用于需要持久化程序运行状态的场景。
本文深入解析OpenCV中的投影变换(透视变换),通过车牌识别案例说明其必要性。详细讲解投影变换矩阵的8个未知数计算方法,对比其与仿射变换的区别,并提供基于Python 3.7.4和OpenCV 4.1的完整代码示例,展示如何利用[[wp:a6]]和[[wp:a7]]函数实现图像校正。
本文深入解析Python中的三种核心数据序列化模块:json、pickle和shelve。详细对比它们的数据支持范围、跨语言兼容性以及文件读写模式差异,重点讲解Python 2与3在编码处理上的不同,并提供dumps/loads与dump/load的具体代码示例,帮助开发者根据场景选择最合适的持久化方案。