

Python跨目录Import导入方法详解:同级、子目录与上级目录
本文详细解析Python中跨目录import的三种常见场景:同级目录直接调用、子目录通过包路径导入,以及上级目录利用sys.path追加路径的方法。文章通过具体代码示例和目录结构图,演示了如何处理不同层级间的模块引用,特别强调了在上级目录调用时需创建__init__.py文件及配置sys.path的关键步骤,帮助开发者解决Python项目中的模块导入难题。
2026-10-13
12

本文详细解析Python中跨目录import的三种常见场景:同级目录直接调用、子目录通过包路径导入,以及上级目录利用sys.path追加路径的方法。文章通过具体代码示例和目录结构图,演示了如何处理不同层级间的模块引用,特别强调了在上级目录调用时需创建__init__.py文件及配置sys.path的关键步骤,帮助开发者解决Python项目中的模块导入难题。
本文详解TensorFlow中如何处理长度不一的变长数据(如语音、视频或NLP样本)。通过对比直接padding写入与使用padded_batch方法,重点解析padded_batch的参数配置及tf.VarLenFeature配合sparse_tensor_to_dense的使用,结合MNIST示例展示完整代码实现。
本文深入解析 Python 内置函数 super() 的核心用法与底层原理。通过单继承与多重继承(MRO)的完整代码示例,展示如何避免硬编码基类名称并正确传递参数。重点剖析钻石继承结构下的方法解析顺序,帮助开发者理解 super() 在复杂类层次中的执行流程。
本文详解Python中future模块的核心作用,即在不升级解释器版本的前提下,提前引入新版本特性。通过print函数语法变更及除法运算规则两个具体案例,演示如何通过在代码头部添加__future__导入语句,解决Python 2与Python 3之间的语法差异,实现代码的跨版本兼容测试。
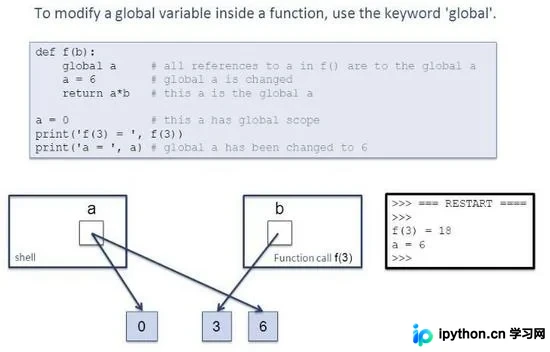
本文详细解析Python中global和nonlocal关键字的区别与应用。global用于在函数内修改全局变量,需显式声明;nonlocal用于在嵌套函数中修改外层函数变量,作用于闭包。通过代码示例说明未声明导致的UnboundLocalError及正确用法,帮助开发者掌握变量作用域规则。
本文深入解析Python中Condition条件变量的工作原理,阐述其与锁的关联机制及wait、notify等核心方法的行为。通过完整的生产者-消费者代码示例,演示如何利用Condition实现线程间的协调与通信,帮助开发者掌握多线程编程中的同步技巧。
本文详细讲解在Django项目中如何正确配置并调用本地的CSS和JavaScript文件。通过创建static目录、修改settings.py中的STATICFILES_DIRS以及在前端HTML中正确引用路径,解决静态资源加载问题。
本文深入解析Python标准库logging模块的核心用法。从基础日志级别(debug、info、warning等)的适用场景出发,详细演示如何通过basicConfig将日志写入文件。进一步探讨在包含多个模块的复杂项目中,如何合理组织日志记录器,确保主程序与库文件日志清晰分离且正确输出,为开发者提供实用的日志管理方案。
本文详细介绍 TensorFlow 2.0 中张量的合并与分割操作。通过 tf.concat 实现沿指定轴合并张量,利用 tf.stack 创建新维度进行数据堆叠,并借助 tf.unstack 和 tf.split 执行解堆叠与分割。文章结合具体代码示例,解析各函数的参数设置、形状变化及适用场景,帮助开发者高效处理多维数据。
本文深入解析Python中实现定时任务的两种主流方案。第一种基于threading模块的Timer类,适用于多线程环境下的周期性或单次延时执行;第二种通过封装time模块构建自定义Timer类,提供更灵活的计时控制与异常处理机制。文章结合具体代码示例,对比两者在启动、停止及资源管理上的差异,帮助开发者根据实际场景选择最优方案。
本文针对TensorFlow在遍历图片进行风格迁移时内存持续增长的问题,分析了因在循环中重复调用tf计算导致计算图节点累积的根源。通过对比错误与正确代码示例,指出应将所有计算操作定义在模型构建阶段,利用Placeholder统一输入,避免在迭代过程中动态添加新节点,从而有效防止内存溢出。
本文介绍了在TensorFlow中获取张量(Tensor)具体维数的方法。通过示例展示了如何使用shape和get_shape属性查看张量的形状,并提取具体维度的数值。同时介绍了将TensorShape转换为列表以方便索引取值的方法,以及与整数进行比较的操作。