Django模型类中save()方法的应用与注意事项
本文探讨Django模型类中使用save()方法处理动态生成字段的技巧。通过重写save()方法,可在保存前自动计算并填充如折扣、应付金额等关联字段,确保数据一致性。重点强调多字段依赖时的执行顺序,以及避免直接修改外键关联数据导致的记录变更风险。结合views.py与forms.py示例,展示如何正确保存数据至数据库。
2026-10-13
11

本文探讨Django模型类中使用save()方法处理动态生成字段的技巧。通过重写save()方法,可在保存前自动计算并填充如折扣、应付金额等关联字段,确保数据一致性。重点强调多字段依赖时的执行顺序,以及避免直接修改外键关联数据导致的记录变更风险。结合views.py与forms.py示例,展示如何正确保存数据至数据库。
本文详解在 Django 中修改已存在 Model 的标准操作步骤,包括清理迁移文件、重置数据库记录及重新生成迁移。同时深入解析 Model 的 save 方法机制,指出即使字段未变更,save 操作仍会将内存数据写回数据库,可能导致其他进程或子函数的修改被意外覆盖,提供相关代码示例与注意事项。
本文介绍Django中F表达式在更新数据库字段时的应用。相比传统加载内存方式,F表达式直接生成SQL语句,显著提升大量数据更新性能。文章涵盖单对象与批量更新的代码示例,并重点强调更新后调用refresh_from_db()获取最新字段值的重要性,避免数据不一致问题。
本文详解Django中利用F对象实现跨模型字段聚合查询的方法,解决子表与父表数据关联筛选问题。同时介绍在Django Admin后台通过TabularInline实现父表对子表的直接编辑功能,提升管理效率。涵盖list_display自定义字段显示及排序配置,提供完整代码示例与注意事项。
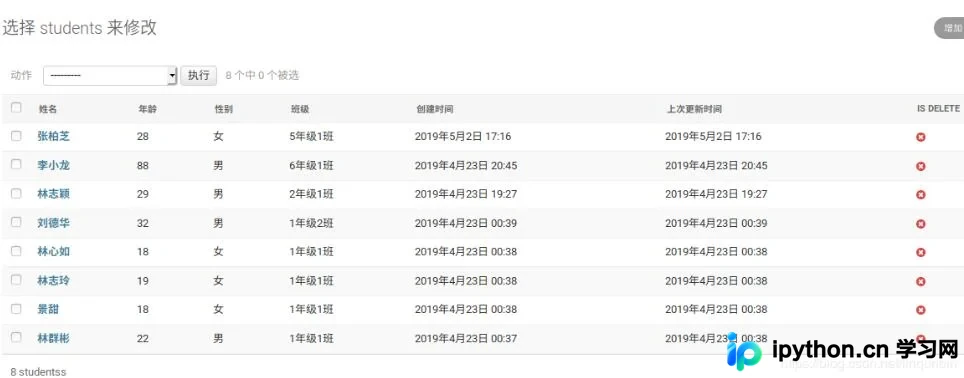
本文介绍在Django中合并两个QuerySet的两种常用方法:使用竖线运算符|直接拼接,以及通过itertools.chain进行链式处理。同时补充了QuerySet的集合运算与条件筛选操作,帮助开发者高效处理数据库查询结果。
本文详细讲解在 Python 中安装 Impyla 连接 Impala 数据库的完整步骤。直接 pip install impyla 往往失败,需按顺序安装 six、bit_array、thriftpy、thrift_sasl 等依赖。重点包含 thrift_sasl 模块中 _send_message 函数的代码修改补丁,解决 Python 3 兼容性问题,确保连接稳定。
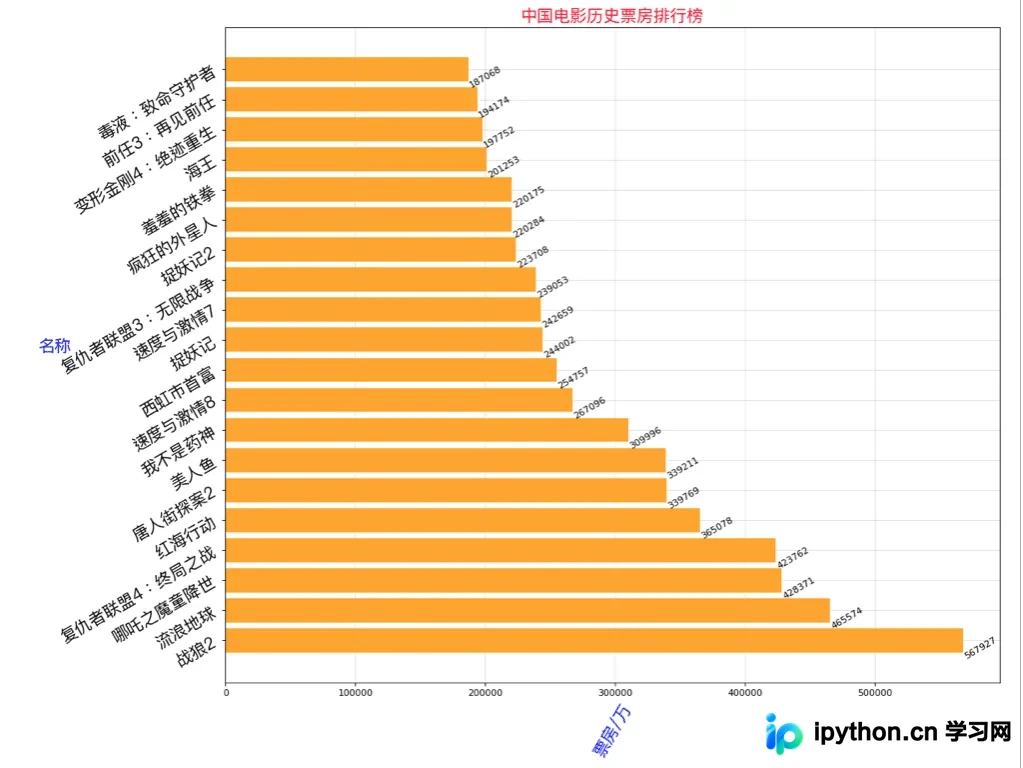
本文通过Python实现电影历史票房数据的抓取与可视化展示。利用requests库请求指定API获取JSON数据,结合matplotlib库绘制横向条形图。代码采用面向对象设计,封装了请求、解析及绘图逻辑,可直接运行查看结果,适合Python初学者参考学习。
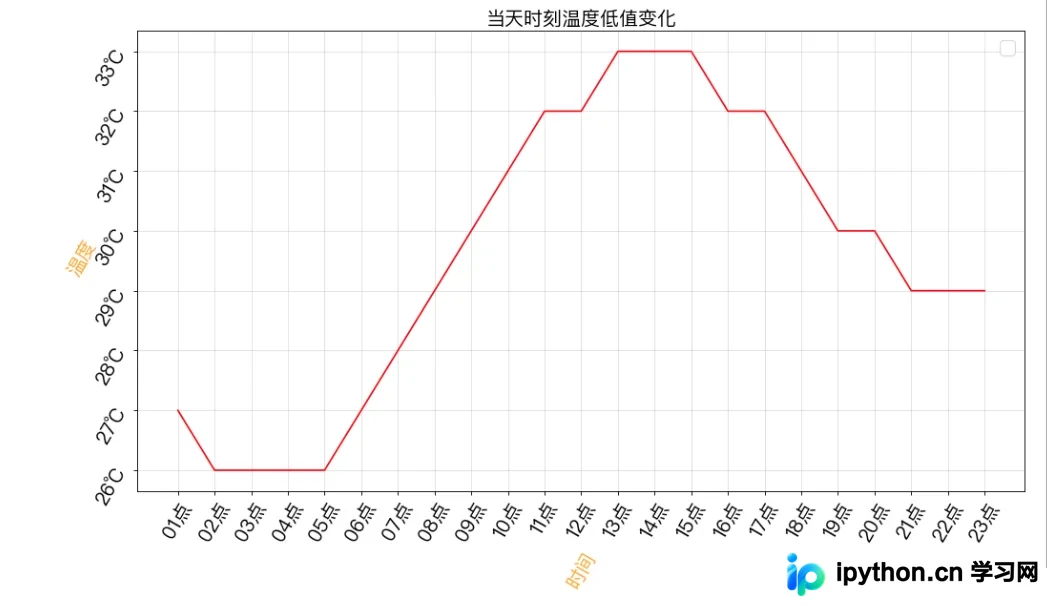
本文介绍使用Python爬虫技术抓取杭州今日24小时温度数据的方法。通过requests库发起请求,利用正则表达式解析HTML页面中的温度数值,并结合面向对象编程封装逻辑。最后使用Matplotlib库将提取的小时温度数据绘制为散点图或折线图,直观展示温度变化趋势。
本文介绍PyCharm专业版中Database和HTTP Client两大核心功能,帮助后端开发者在IDE内完成数据库可视化管理与RESTful API调试。通过集成Database功能替代Navicat进行MySQL连接与数据操作,利用HTTP Client创建.http文件实现接口自动化测试,从而减少软件切换,提升开发效率。
本文介绍如何在Django中配置多个数据库连接,并通过django.db.connections对象指定使用特定数据库执行原生SQL语句。内容涵盖settings配置、连接获取及实际操作示例,适用于需要同时访问多个数据源的开发场景。
本文详细解析Django项目中静态资源的配置方法,涵盖STATIC_URL与STATICFILES_DIRS的设置差异、模板中静态文件的两种加载方式({% load static %}与内置注册)、常见错误排查及浏览器缓存清除技巧,帮助开发者高效管理CSS、JS及图片等静态资源。
本文通过Python代码实例,对北京积分落户数据进行了多维度深入分析。利用Pandas库进行数据清洗与处理,重点从公司规模、申请人年龄分布及百家姓三个维度统计落户人数与分数指标。同时,结合Matplotlib对分数段占比进行可视化展示,并总结了groupby与cut在离散与连续数据分析中的核心应用技巧。