解决Django Haystack全文检索结果为空的问题
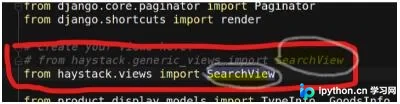
本文针对Django Haystack全文检索返回空结果的问题,重点解析两个常见陷阱:一是搜索表单的输入框name属性必须严格设置为q,否则无法触发检索;二是自定义视图时需区分generic_views与views模块中SearchView类的差异,前者返回page_obj后者返回page,且数据均位于object属性下。正确配置URL和视图可解决检索失败问题。
2026-10-13
10

本文针对Django Haystack全文检索返回空结果的问题,重点解析两个常见陷阱:一是搜索表单的输入框name属性必须严格设置为q,否则无法触发检索;二是自定义视图时需区分generic_views与views模块中SearchView类的差异,前者返回page_obj后者返回page,且数据均位于object属性下。正确配置URL和视图可解决检索失败问题。
本文详细介绍 Jupyter Notebook 的安装、启动及核心操作。涵盖 Anaconda 与 pip 安装方法,解析 Notebook 架构与内核机制,演示代码与 Markdown 单元格使用,并深入讲解 Magic 命令及常用快捷键,帮助数据爱好者高效进行数据挖掘与建模。
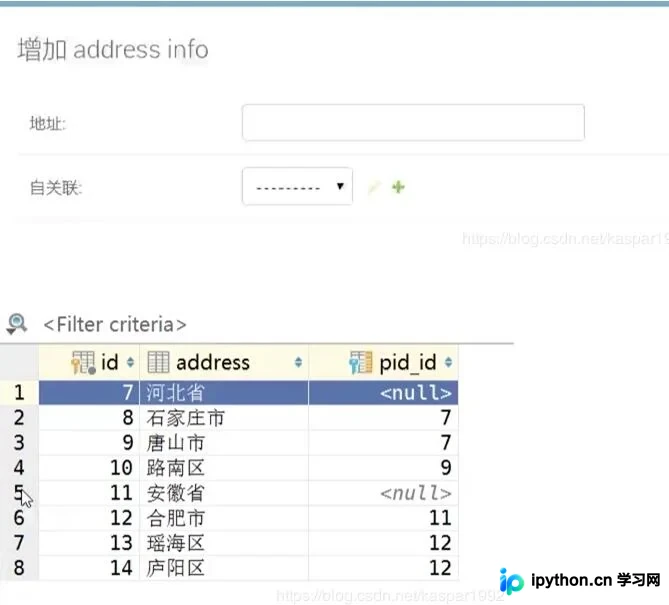
本文介绍如何利用Django的自关联特性实现省市县三级联动查询。通过建立包含pid外键的AddressInfo模型,配合后端URL路由与JSON接口,以及前端jQuery动态加载下拉框选项,完整展示从数据库设计到前端交互的实现过程。
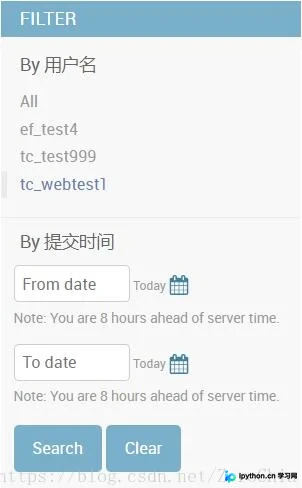
本文详细介绍如何在 Django Admin 中使用 DateRangeFilter 插件实现自定义时间区间筛选功能。涵盖插件安装、INSTALLED_APPS 配置、admin.py 中的字段注册方法及注意事项,适用于 Django 1.4 及以上版本,帮助开发者突破默认时间筛选限制,提升后台管理效率。
本文详细介绍如何在Django项目中创建和使用自定义Filter。通过建立templatetags目录、定义register实例及编写过滤函数,实现如get_range等自定义逻辑。文章涵盖代码示例、模板加载方法及Admin筛选器重写的补充知识,帮助开发者灵活扩展Django模板功能。
本文详细解析Django ORM中values和annotate函数的核心用法。通过实际案例演示如何利用values筛选指定字段,结合annotate实现类似SQL的GROUP BY统计功能,从而高效识别并清洗数据库中的重复数据。同时,对比传统遍历计数与annotate聚合查询的性能差异,展示如何在多表关联场景中优化查询效率,避免N+1查询问题,提升Web应用性能。
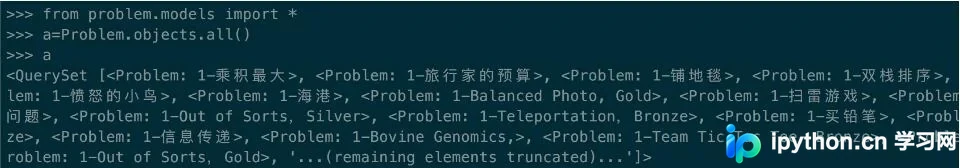
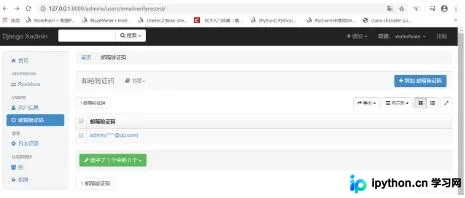
本文详细解析Django中如何重载__str__方法以优化模型显示,并通过自定义Manager类实现数据过滤。通过EmailVerifyRecord和StuBK_banji两个实例,展示了在后台管理及前端选择场景中,如何精简显示字段及过滤特定数据,提升开发效率与用户体验。
本文介绍如何在Django项目中通过自定义模板标签获取模型字段的verbose_name。首先创建templatetags模块及verbose_name.py文件,利用@register.simple_tag定义get_verbose_field_name函数,并在模板中加载使用。同时补充说明了Form中label与verbose_name的区别,前者用于显示,后者仅为说明。
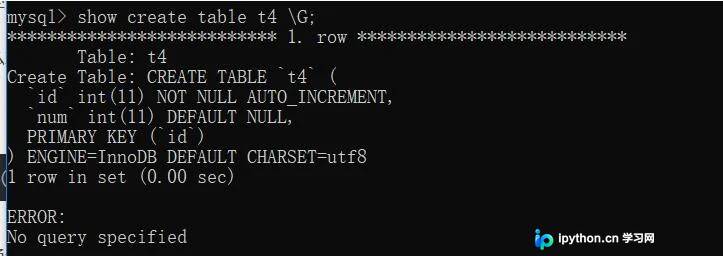
本文详细讲解如何在MySQL中查看并修改自增字段AUTO_INCREMENT的起始值,通过建表、插入数据及清空记录的操作演示其机制。同时补充Django开发中常见的AttributeError及abstract属性配置错误,提供具体的代码修正方案,帮助开发者避开这些常见坑点。
本文详解pandas中explode函数的用法,该函数可将包含列表或元组的列展开为多行。文章提供了两种手动实现列内字典/列表拆分的方法,包括使用pd.Series转换和concat拼接,并附带完整代码示例与结果展示,帮助开发者高效处理复杂数据结构。
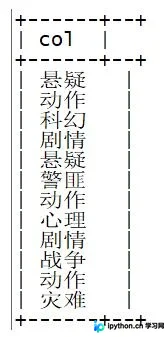
本文介绍如何在Python中实现Hive中类似lateral view explode的功能,将包含多个标签的字符串拆分为多行数据。通过具体示例展示Hive SQL与Python代码的实现方式,并补充相关理论知识,帮助读者理解列转行的数据处理方法。
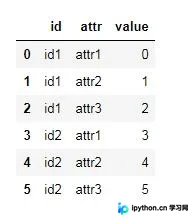
本文介绍如何在Python中使用Pandas库实现数据框的长格式与宽格式相互转换。通过stack和unstack方法,可将键值对形式的堆叠数据重塑为宽表,反之亦然。文章提供完整代码示例,涵盖从CSV读取、PeriodIndex构建到最终pivot和unstack操作的全过程,帮助开发者处理数据库交互中的常见数据结构转换需求。