

Django Admin 实现外键过滤的方法
本文介绍在 Django Admin 中实现外键数据按当前登录用户过滤的方法。主要涵盖两处场景:在列表页限制可见数据,以及在新增或编辑表单中动态过滤关联外键选项。通过重写 get_queryset、save_model 以及 render_change_form 等方法,结合 get_changeform_initial_data 传递初始参数,可有效实现基于用户权限的数据隔离与过滤。
2026-10-14
11

本文介绍在 Django Admin 中实现外键数据按当前登录用户过滤的方法。主要涵盖两处场景:在列表页限制可见数据,以及在新增或编辑表单中动态过滤关联外键选项。通过重写 get_queryset、save_model 以及 render_change_form 等方法,结合 get_changeform_initial_data 传递初始参数,可有效实现基于用户权限的数据隔离与过滤。
本文详细介绍如何在同一服务器上使用virtualenv为多个Python项目创建独立的运行环境,解决依赖冲突问题。涵盖安装方法、环境创建、激活退出、全局库继承、路径修改及uwsgi集成配置,帮助开发者高效管理Python版本与第三方库。
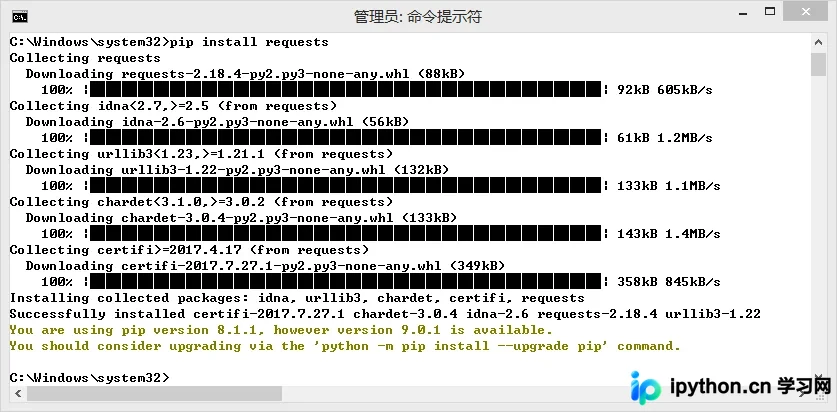
本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
本文梳理了从ASCII到UTF-8的字符编码发展史,重点解析Python2与Python3在字符串处理上的核心差异。通过具体代码示例,展示了Python2中字节串与Unicode互转的decode/encode流程,以及Python3中字符串直接编码为字节串的新机制,帮助开发者理解不同版本下的编码转换逻辑。
本文介绍Python在信息学竞赛中的辅助作用,重点涵盖安装配置、基本语法、数据类型、输入输出及文件操作。文章指出Python虽不适合核心算法实现,但在编写数据生成器和简单小程序时具有语法简洁的优势,并提供了随机数生成与文件读写的具体示例。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。
本文详解Python中的序列化与反序列化概念,阐述其将对象状态转换为可存储或传输格式的目的。重点介绍使用Pickle和JSON模块进行数据处理的代码示例,涵盖自定义对象持久化、跨环境传递及程序维护性提升等核心应用场景。
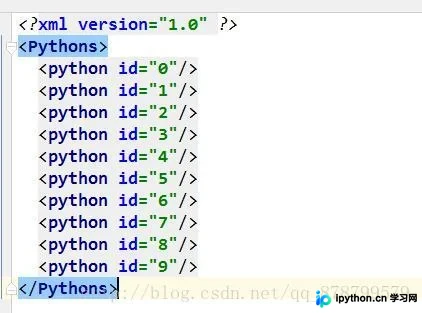
本文详细介绍如何使用 Python 标准库 xml.dom.minidom 进行 XML 文件的生成与读取。通过具体代码示例,演示如何创建带有属性的节点结构并写入文件,以及如何解析现有 XML 文件并提取特定标签的属性值。包含完整的生成与读取代码片段及运行结果分析,帮助开发者快速掌握 Python 处理 XML 数据的核心方法。
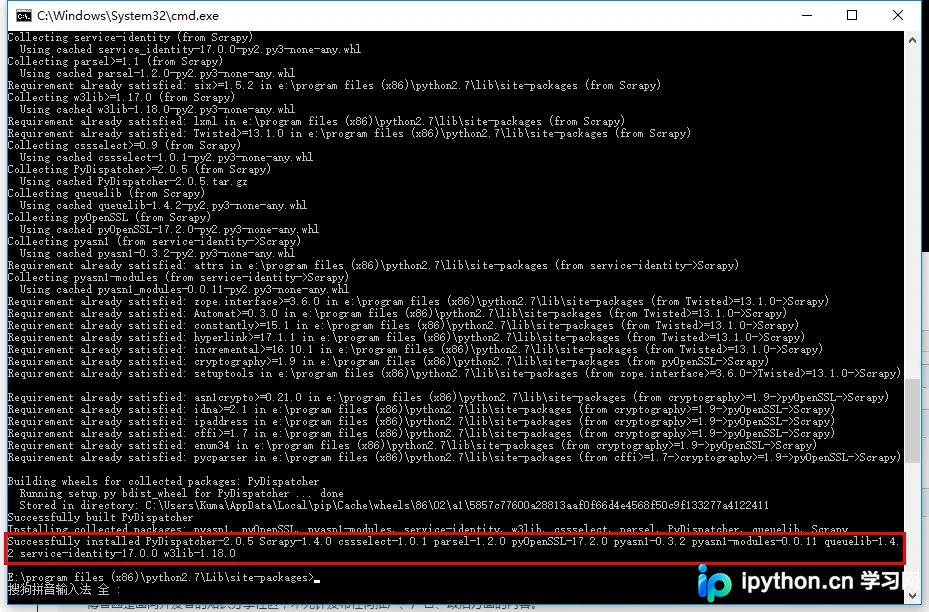
本文详细介绍 Python 中 Scrapy 框架的安装方法。首先通过 pip install Scrapy 进行常规安装,若遇到 lxml、Twisted 或 cryptography 等依赖库安装失败的情况,提供使用 wheel 工具及预编译 whl 文件的详细解决步骤,包括如何获取支持标签及下载对应版本的 whl 文件进行本地安装。
本文总结Python中字符串与十六进制、二进制、八进制之间的转换方法,涵盖decode('hex')、hex()、binascii库及int()函数的使用。结合CTF赛题实例,提供二进制、ASCII、十六进制转字符串的Python脚本工具,帮助安全研究人员高效处理编码转换任务。
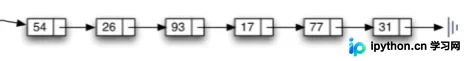
本文深入解析Python中的链表数据结构,对比其与顺序表的存储差异。重点阐述链表如何通过节点链接实现灵活的动态内存管理,解决顺序表扩容时的数据搬迁问题。文章涵盖链表定义、节点结构及核心优势,为理解复杂数据结构基础提供清晰指引。
本文详细介绍在Windows环境下为Python安装Paramiko和PyCrypto模块的步骤。由于Paramiko依赖PyCrypto,需先安装后者。文章提供了预编译版本的下载链接及pip命令行安装方法,并包含验证安装成功的代码示例,帮助用户快速配置SSH环境。