

pandas重新生成索引的方法
本文介绍在pandas数据处理中,筛选数据导致索引从非零值开始(如600多)时的解决方案。通过对比reindex引入NaN值的局限性,重点讲解使用set_index(drop=True)方法重新生成从0开始的连续索引,并强调需重新赋值以生效。
2026-10-14
6

本文介绍在pandas数据处理中,筛选数据导致索引从非零值开始(如600多)时的解决方案。通过对比reindex引入NaN值的局限性,重点讲解使用set_index(drop=True)方法重新生成从0开始的连续索引,并强调需重新赋值以生效。
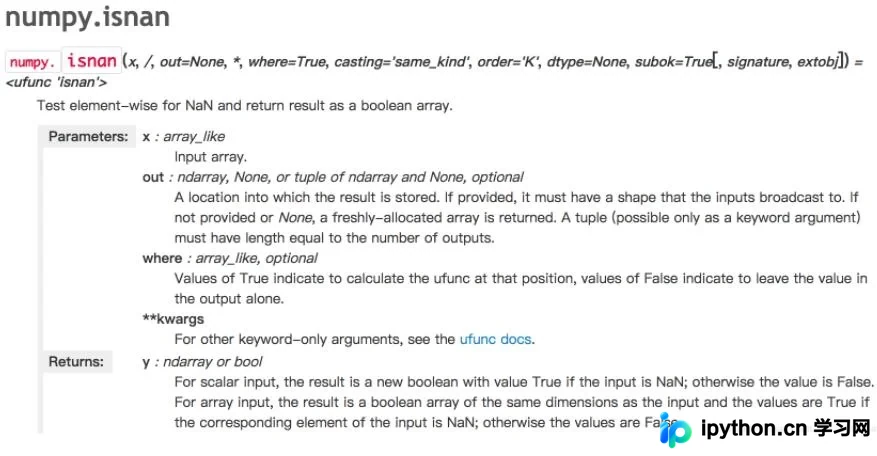
本文介绍在 Python 中使用 Numpy 查找数组中 np.nan 值的方法。通过 numpy.isnan 函数定位 NaN 元素及其索引,并针对 Pandas 读取数据时可能出现的 TypeError 问题,推荐使用 pandas.isnull 进行空值判断,确保数据处理流程的稳定性。
在使用pandas DataFrame的fillna方法时,若未设置inplace=True,填充操作不会修改原数据框,导致看似填充失败。本文通过对比直接打印结果与修改原数据两种方式,详细解析inplace参数的作用,确保数据变更持久保存。
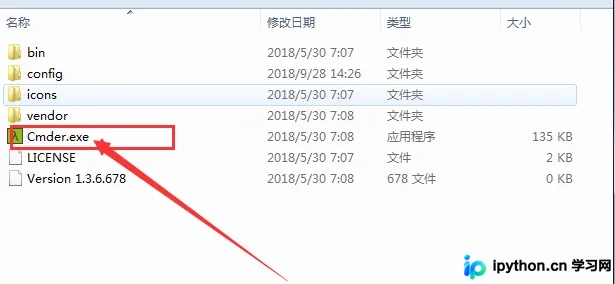
本文详细介绍如何在Windows下的Cmder终端中创建Python虚拟环境,并通过pip安装IPython。同时演示了如何进入MySQL服务器目录,使用命令行工具连接数据库,为Python开发环境配置提供参考。
本文深入解析 Python 3.x 中迭代器的工作原理,阐述 iter 函数如何生成带有 next 指针的迭代对象。重点说明 Python 3 中 next() 函数已更替为 __next__() 方法,并通过文件读取与字符串遍历两个实例,演示 for 循环底层调用迭代器及显式调用 next 函数的具体过程与 StopIteration 异常处理机制。
本文详细解析Python中计算斐波那契数列的三种主要方法。首先介绍基础递归实现及其高空间复杂度与递归深度限制问题;其次展示使用循环替代递归的迭代方案,显著降低空间开销并优化至O(n)时间复杂度;最后深入探讨基于矩阵求幂和位运算的高级算法,虽然需构建矩阵,但在处理超大索引n时能实现O(log n)的高效计算。
本文详细解析Python中实现单例模式的四种常见方法。通过多次实例化指向同一对象的原理,分别介绍了基于类方法、装饰器、元类以及模块级变量的具体代码实现。每种方式均附带完整示例,帮助开发者根据实际需求选择最合适的单例实现方案。
本文介绍使用Python将Excel数据转换为XML格式的具体实现方法。通过xlrd读取Excel文件,利用xml.dom.minidom构建XML结构,并提供了完整的转换代码示例。文中还列出了在线XML处理工具供参考,适用于需要批量处理表格数据并生成XML文件的开发场景。
本文总结了Flask开发中的关键知识点,涵盖路由装饰器的灵活使用、蓝本(Blueprint)对app对象的引用、Jinja2模板的继承与宏机制,以及表单提交中的POST请求重定向和数据库会话管理。旨在帮助开发者快速掌握Flask基础并避免常见陷阱。
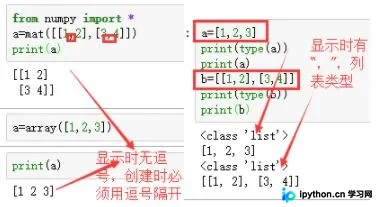
本文详细介绍Python中基于NumPy库的矩阵创建方法,包括从数组转换、生成全1矩阵、随机整数及均匀/正态分布矩阵。同时解析矩阵点乘、乘法、求逆与转置等核心运算操作,并对比random与rand函数的区别及随机种子设置,帮助开发者掌握NumPy矩阵处理技巧。
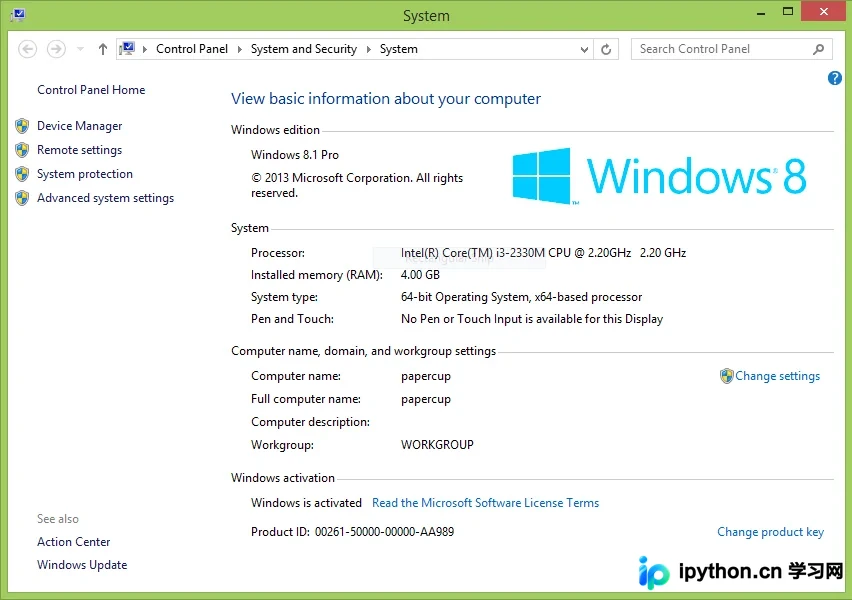
本文详细讲解在 Windows 8.1 64位系统中安装 Python 3.4 的完整步骤。内容涵盖从官网下载64位安装包、避免中文路径的规范安装、配置系统环境变量以支持CMD直接调用,以及使用Pip进行包管理。针对数学计算库如NumPy和SciPy安装失败的情况,提供了通过Unofficial Windows Binaries网站下载.whl文件的高级解决方案,帮助开发者快速搭建Python开发环境。
本文详细介绍Python中列表生成式与生成器的使用方法。通过具体代码示例,讲解如何利用列表生成式快速创建列表并添加筛选条件,以及如何通过修改括号或yield关键字创建生成器以节省内存。