

Python列表遍历的5种常用方法及文件遍历技巧
本文总结了Python中遍历列表的五种主要方法,包括基础的for循环、while循环、索引访问、iter()迭代器以及enumerate()枚举器,并详细解析了各方法的代码示例与运行结果。此外,文章还扩展介绍了在验证码识别等场景下,利用os模块进行文件遍历的三种实现方式,涵盖listdir、path.walk及os.walk的使用差异与注意事项。
2026-10-14
9

本文总结了Python中遍历列表的五种主要方法,包括基础的for循环、while循环、索引访问、iter()迭代器以及enumerate()枚举器,并详细解析了各方法的代码示例与运行结果。此外,文章还扩展介绍了在验证码识别等场景下,利用os模块进行文件遍历的三种实现方式,涵盖listdir、path.walk及os.walk的使用差异与注意事项。
本文介绍在Python中如何获取变量的类型、内存地址以及所占字节大小。通过内置函数type()、id()和sys模块的getsizeof(),可以分别获取变量的数据类型、十进制内存地址及内存占用字节数。
本文详细介绍 pandas.cut 函数的核心用途与参数配置。通过解析 bins 的三种形式、right 边界控制、labels 标签映射及 retbins 返回值等关键参数,结合年龄分组实战案例,展示如何实现数据离散化、自定义区间分割及结果可视化,帮助开发者高效处理连续数据的分类问题。
本文介绍如何使用Python pandas库创建DataFrame,并通过指定列名列表调整列的显示顺序。同时演示如何将默认从0开始的索引(index)修改为从1开始,适用于需要特定数据展示格式的场景。
本文深入对比Python中in、find、index及__contains__四种子串查找方式的性能。测试表明in运算符速度最快,因其直接调用C层函数而避免虚拟机开销;find与index核心逻辑一致,但index在查找失败时抛出异常的机制导致其性能略低。文章从CPython源码层面解析了操作符与属性调用的底层差异,建议在实际开发中优先使用in运算符以获得最佳可读性与执行效率。
本文详细介绍在Linux服务器环境下搭建Python多版本管理、配置Jupyter Notebook远程访问以及集成PySpark进行Web端Spark开发的完整流程。内容涵盖使用pythonbrew管理Python版本、生成SSL证书与密码以安全远程连接Jupyter,以及配置环境变量启动pyspark-jupyter,助力数据分析师实现高效、优雅的远程编程体验。
本文深入解析 Python 3.6 引入的 f-string(格式化字符串常量)。文章涵盖其基本语法、表达式求值、引号与大括号处理规则,以及宽度、精度、对齐、千位分隔符等高级格式化功能。通过对比传统 %-formatting 和 str.format(),展示 f-string 在简洁性与性能上的优势,并提供 lambda 表达式和多行字符串等实用技巧。
本文详解如何利用Python将区域访客数据转化为72624维度的三维矩阵。通过字典映射实现日期到周、天、时刻的离散化转换,结合Pandas读取文本并解析时间戳,最终统计各时段到访人数。核心代码展示了如何高效处理海量日志数据,适用于大数据分析与模型训练前的预处理阶段。
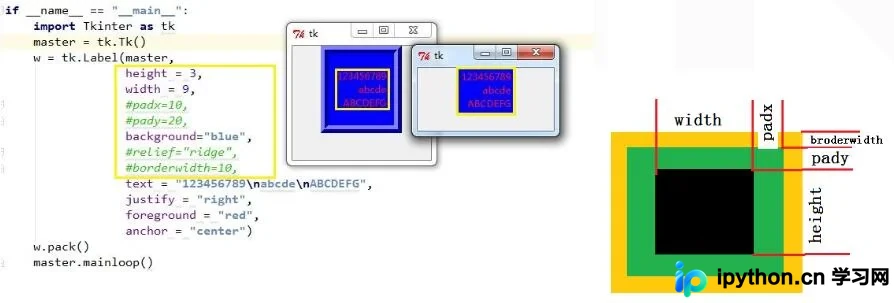
本文深入解析Python Tkinter库中Label组件的核心用法。详细阐述背景区域(内容、填充、边框)与前景元素(文本、图像)的自定义参数,包括字体、对齐、颜色及动态变量绑定。通过代码示例展示如何组合使用compound、anchor等属性实现复杂的界面布局,帮助开发者掌握Tkinter基础UI构建技巧。
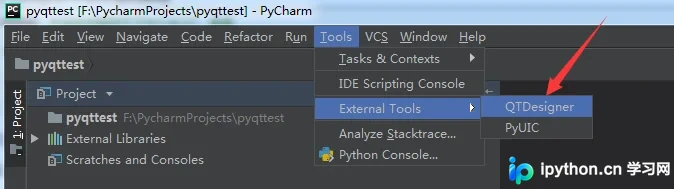
本文详细演示如何在PyCharm中配置并使用Qt Designer和PyUIC进行Python图形界面开发。内容涵盖通过Qt Designer拖拽组件设计UI、绑定信号与槽函数、利用PyUIC将.ui文件转换为.py代码,以及采用继承方式分离界面与逻辑代码的最佳实践,确保界面调整时不影响业务逻辑。
本文详细介绍Ansible在Linux环境下的安装与基础配置流程。通过yum源快速部署主控端,利用hosts文件定义目标主机,并使用ping模块验证连通性。针对SSH密码输入繁琐的问题,深入解析使用ssh-keygen生成密钥及ssh-copy-id分发公钥的方法,实现高效的无密码批量管理。
本文详细介绍在Python中将任意字符串转换为16、32及64进制的方法。通过binascii模块实现16进制编码,利用递归算法处理32进制,并自定义Base64字符集完成64进制转换。同时提供Java BigInteger类的对应实现,涵盖编码与解码逻辑,适用于数据压缩、ID生成等场景。