

Python实现访客数据时间离散化与三维矩阵构建实战

本文详解如何利用Python将区域访客数据转化为72624维度的三维矩阵。通过字典映射实现日期到周、天、时刻的离散化转换,结合Pandas读取文本并解析时间戳,最终统计各时段到访人数。核心代码展示了如何高效处理海量日志数据,适用于大数据分析与模型训练前的预处理阶段。
Python访客数据处理概述
近期实践中发现,制约Python应用能力及代码阅读效率的关键瓶颈,往往在于对数据的处理技巧。
编程的核心本质即数据处理。无论是文本还是图像,关键在于利用Python进行读取、分割等操作,将其转化为N维矩阵,进而输入至现有模型中,最终输出结果矩阵或向量。
面对众多模型与代码束手无策,根源在于未掌握数据处理的“核心工具”,无法对海量数据进行精细化拆解。本文将以一段他人代码为例,深入剖析文本数据处理的技术细节,旨在深化对该领域的理解与应用能力。
问题描述与目标
1)问题描述
数据源为某区域连续181天的访客记录,格式包含两列:第一列为访客名称,第二列为该访客在181天内的到访时刻。
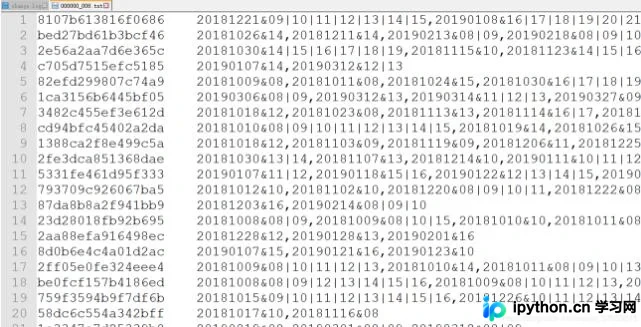
目标是对访客数据进行统计,并将时间维度离散化,最终构建一个尺寸为72624的三维矩阵,处理粒度涵盖天、周及小时。具体而言,矩阵中的每个元素代表特定“周X、第几周、几点”的到访人数。例如,索引[1,5,19]=100表示第5周的周一晚上7点(19时)的到访人数为100人。
技术难点分析
2)难点
此处主要指代个人在实现过程中遇到的技术难点。
2.1)如何实现按行统计
2.2)如何进行时间离散化,即将数据存储为以天、周、时刻为维度的矩阵
代码实现详解
3)代码实现
时间离散化字典构建
import time
import numpy as np
import sys
import datetime
import pandas as pd
import os
#用字典查询代替类型转换,可以减少一部分计算时间
date2position = {}
datestr2dateint = {}
str2int = {}
for i in range(182):
 date = datetime.date(day=1, month=10, year=2018)+datetime.timedelta(days=i)
 #print(i,":",date)
 date_int = int(date.__str__().replace("-", ""))
 date2position[date_int] = [i%7, i//7]
 datestr2dateint[str(date_int)] = date_int
#print(datestr2dateint)
#
for i in range(24):
 str2int[str(i).zfill(2)] = i
f=open("D:\BaiDuBigData19-URFC-master\\UrbanRegionFunctionClassification-master\data\\train_visit\\000000_008.txt")
#table = pd.read_csv(f, header=None,error_bad_lines=False)
table = pd.read_csv(f, header=None,sep='\t')

#print(table.shape)
#print(table.ix[1])
strings = table[1]
#print(strings)
init = np.zeros((7, 26, 24))
for string in strings:
 temp = []
 for item in string.split(','):
 temp.append([item[0:8], item[9:].split("|")])
 for date, visit_lst in temp:
 # x - 第几周
 # y - 第几天
 # z - 几点钟
 # value - 到访的总人数
 # print(visit_lst)
 print(date)
 x, y = date2position[datestr2dateint[date]]
 for visit in visit_lst: # 统计到访的总人数
  init[x][y][str2int[visit]] += 1
 #print(init[x][y][str2int[visit]])```
3.1)创建字典以进行时间离散化,旨在优化计算效率
代码中构建了三个字典,具体实现及打印结果如下所示:
date2position = {}
datestr2dateint = {}
str2int = {}
for i in range(182):
 date = datetime.date(day=1, month=10, year=2018)+datetime.timedelta(days=i)
 #print(i,":",date)
 date_int = int(date.__str__().replace("-", ""))
 date2position[date_int] = [i%7, i//7]
 datestr2dateint[str(date_int)] = date_int
for i in range(24):
 str2int[str(i).zfill(2)] = i
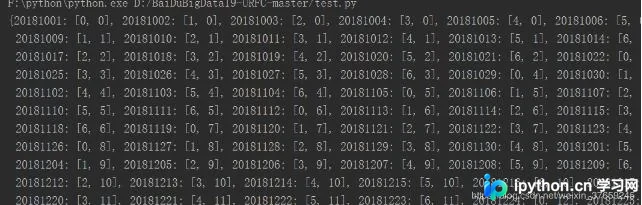
打印date2position的结果:
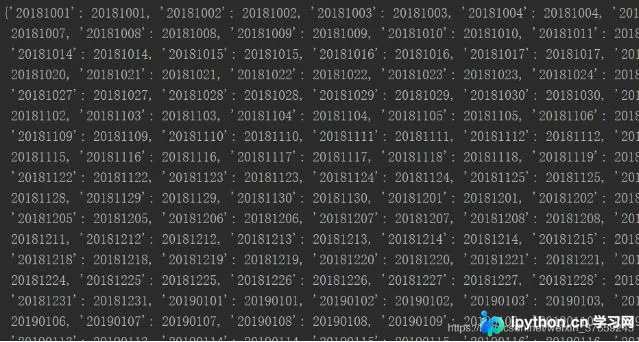
打印datestr2dateint的结果:
打印str2int的结果:

从输出可见,datestr2dateint负责将字符串格式的日期转换为整数格式。而date2position则计算每个具体日期对应的结构,即代表第几周与第几天。str2int则映射一天中的24个时刻。
3.2)读取文件,按行获取字符串数据
鉴于文本文件的分隔符为\t(用于区分用户名与到访信息),因此采用相应方法读取。
数据读取与预处理
f=open("D:\BaiDuBigData19-URFC-master\\UrbanRegionFunctionClassification-master\data\\train_visit\\000000_008.txt")
#table = pd.read_csv(f, header=None,error_bad_lines=False)
table = pd.read_csv(f, header=None,sep='\t')
随后通过strings变量提取到访信息,即表格的第二列数据:
strings = table[1]3.3)字符串切分处理
首先,strings变量的内容如下:
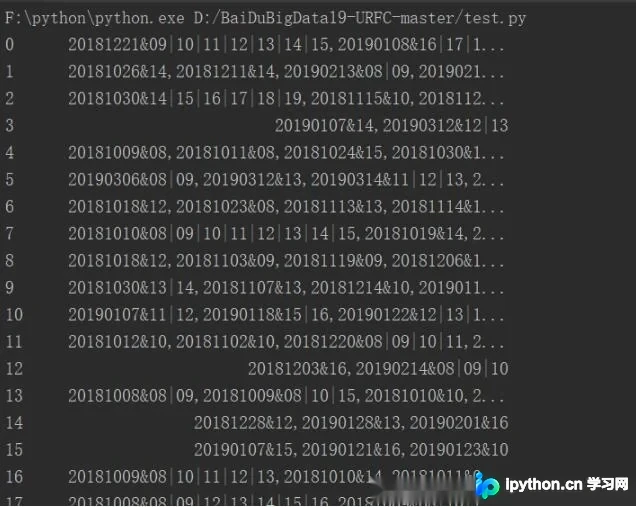
观察可知,每一行string代表一个用户的完整到访记录,需进行循环读取。由于不同日期的到访记录由“,”分隔,因此需要使用特定方法处理。
字符串切分与矩阵统计
for string in strings:
 temp = []
 for item in string.split(','):
通过上述处理,item变量即可分离出每一个日期的到访记录:
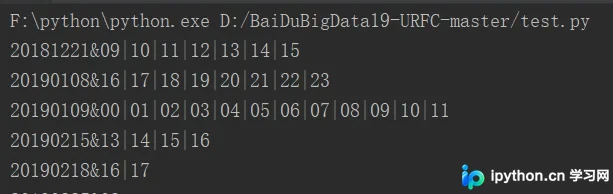
接着,使用temp列表存储每行的日期与时刻信息。例如,第一个item为“20181221&09|10|11|12|13|14|15”。其中,日期部分为item[0:8],时刻之间由分隔符“|”隔开,可通过item[9:].split("|")获取。
temp.append([item[0:8], item[9:].split("|")])打印temp变量的结果如下:
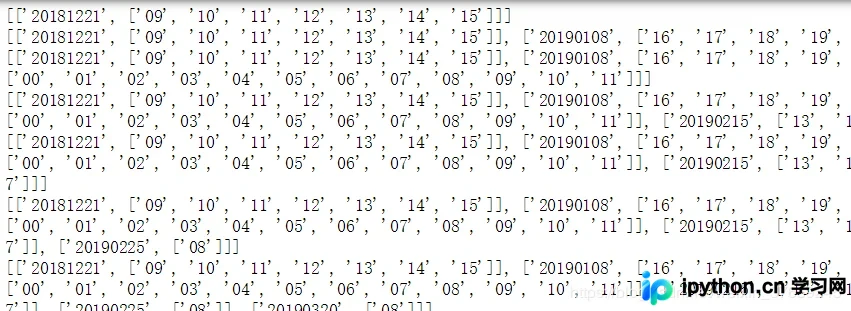
因此,需使用两个数据分别存储日期与时刻。首先,利用前述转换函数构建一个72624维的矩阵(包含周、天、时刻维度);随后,基于该矩阵统计每个位置对应的访客数量。
for date, visit_lst in temp:
 # x - 第几周
 # y - 第几天
 # z - 几点钟
 # value - 到访的总人数
 # print(visit_lst)
 #print(date)
 x, y = date2position[datestr2dateint[date]]
 for visit in visit_lst: # 统计到访的总人数
  init[x][y][str2int[visit]] += 1
这段代码虽然简短,却是实现时间离散化的核心精髓所在。
以上为本文全部内容,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









