

Python使用openpyxl按目录拆分Excel工作簿
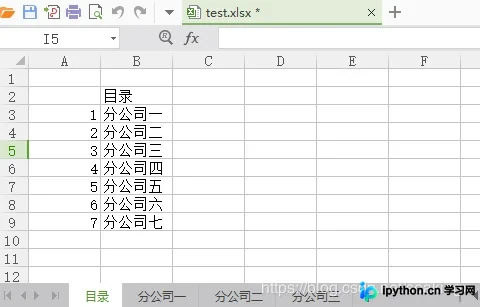
本文介绍如何使用Python的openpyxl库,根据Excel文件中的目录信息,将包含多个工作簿的工作簿拆分为独立的单个文件。通过遍历目录表并逐个复制单元格数据,实现自动化拆分,适用于需要批量处理Excel文件的场景。
2026-10-13
6

本文介绍如何使用Python的openpyxl库,根据Excel文件中的目录信息,将包含多个工作簿的工作簿拆分为独立的单个文件。通过遍历目录表并逐个复制单元格数据,实现自动化拆分,适用于需要批量处理Excel文件的场景。
本文详解Python Pandas中处理Excel数据缺失值的两种核心方法:dropna用于删除全空行或列,fillna用于填充特定值或前向/后向填充。通过读取含空行的Excel文件,演示如何忽略前导空行、检测空值、删除无效数据列及行,并将分数列空值填为0,姓名列使用前向填充。最终保存清洗后的数据,提供从读取到保存的完整清洗流程。
本文详解如何使用 Python3 的 pandas 库读取、修改并保存 Excel 文件。通过实例演示了安装依赖、读取指定 Sheet、新增列(处理 Series 长度一致性)、以及调用 to_excel 方法保存结果的关键步骤,帮助开发者快速掌握基础数据操作。
本文详细介绍Python中openpyxl模块读取Excel文件的方法。涵盖加载工作簿、获取工作表、读取单元格值、处理行列数据及切片操作等核心功能,帮助开发者高效处理Excel数据。
本文提供Python实现的智联招聘爬虫代码实例。通过输入职位关键字,程序自动抓取职位名称、薪资及工作经验等数据,并利用openpyxl库将结果写入Excel文件。代码包含完整的请求头设置、分页逻辑及数据解析过程,适合用于快速获取招聘平台公开信息。
本文介绍在Python3.6与Selenium2.53.6环境下,利用xlrd库读取Excel文件进行自动化测试的方法。通过封装ExcelUtil类,实现从指定Sheet获取数据并转换为字典列表,结合DDT框架实现数据驱动测试,适用于Web自动化场景。
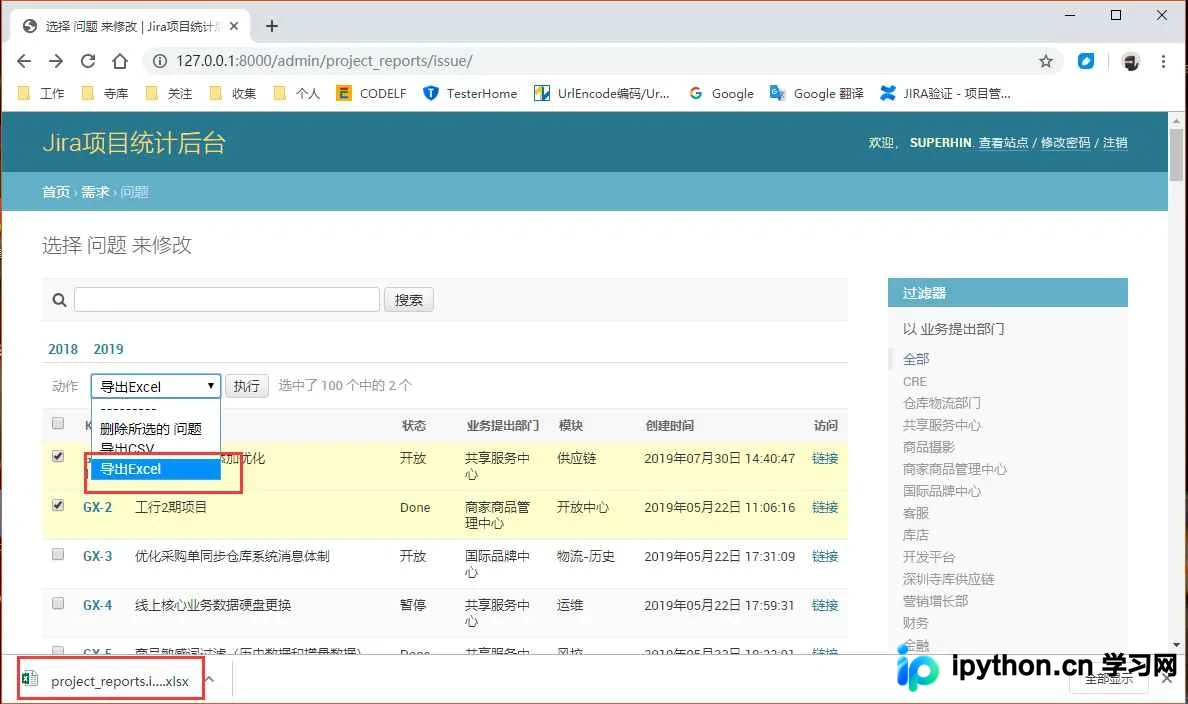
本文介绍如何在 Django Admin 中为模型列表添加 Excel 数据导出功能。通过定义 actions 并实现具体的导出方法,利用 openpyxl 库生成 .xlsx 文件。此外,提供了将导出逻辑封装为 Mixin 类的完整代码示例,以便在多个模型中复用该功能。
本文介绍在 Python 2.7 中使用 xlwt 模块导出 Excel 时,如何设置单元格的自定义背景颜色。针对 xlwt 仅支持预定义调色板的问题,提供了将十六进制颜色(如 #8a8eef)转换为 xlwt 支持的颜色名称的方法,并详细展示了通过 XFStyle 和 Pattern 对象逐步构建样式的代码实现。
本文介绍使用Python3结合xlrd库读取Excel中的姓名与代号,自动批量创建对应文件夹,并遍历指定目录将包含姓名关键词的文件移动至新文件夹的方法。通过os和shutil模块实现文件查找与移动,适用于大量文件整理场景,提供完整代码及关键函数说明。
本文详细介绍如何使用Python的pandas库合并Excel文件中的多个工作表。通过读取指定文件夹下的Excel文件,分别提取不同工作表的数据,并对特殊工作表进行索引截取处理,最终将结果保存为新的Excel文件。
本文提供一段Python代码,用于批量将Excel文件中的多个Sheet页转换为CSV格式。通过xlrd和pandas库,自动处理包含空格字段的复杂表格,并按指定规则清洗数据。该脚本适用于需要高效处理大量Excel数据的场景,避免手工转换的低效与错误。
本文演示了如何使用Python将Excel数据高效导入SQL Server数据库。通过结合xlrd读取Excel文件与pymssql建立数据库连接,实现了批量插入操作。示例中处理一万多条数据耗时仅1秒左右,代码逻辑清晰,适合需要快速迁移数据的场景参考。