Pandas 解析 Excel 时 MemoryError 的成因与优化办法
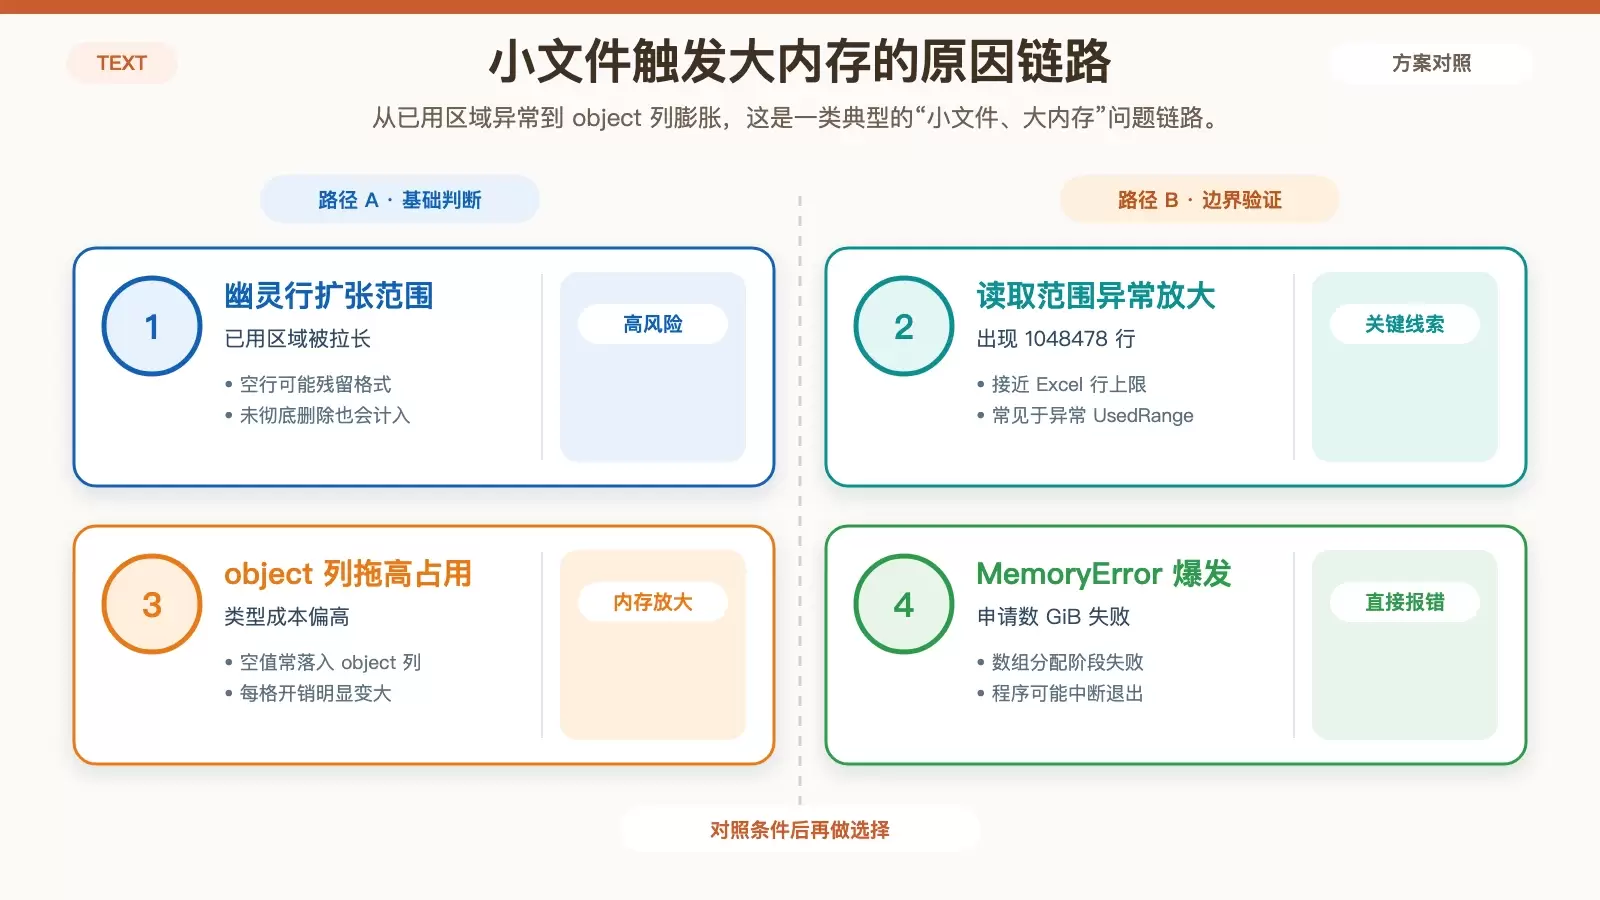
Pandas 读取 Excel 时出现 MemoryError,并不一定意味着文件真的很大。很多情况下,问题出在 Excel 的“已用区域”被异常拉长,配合 object 类型列和未及时释放对象,最终触发数 GiB 级内存申请。本文结合报错特征、成因和可直接落地的处理方式,整理出一套更稳妥的 Excel 解析思路。
2026-08-25
326

Pandas 读取 Excel 时出现 MemoryError,并不一定意味着文件真的很大。很多情况下,问题出在 Excel 的“已用区域”被异常拉长,配合 object 类型列和未及时释放对象,最终触发数 GiB 级内存申请。本文结合报错特征、成因和可直接落地的处理方式,整理出一套更稳妥的 Excel 解析思路。
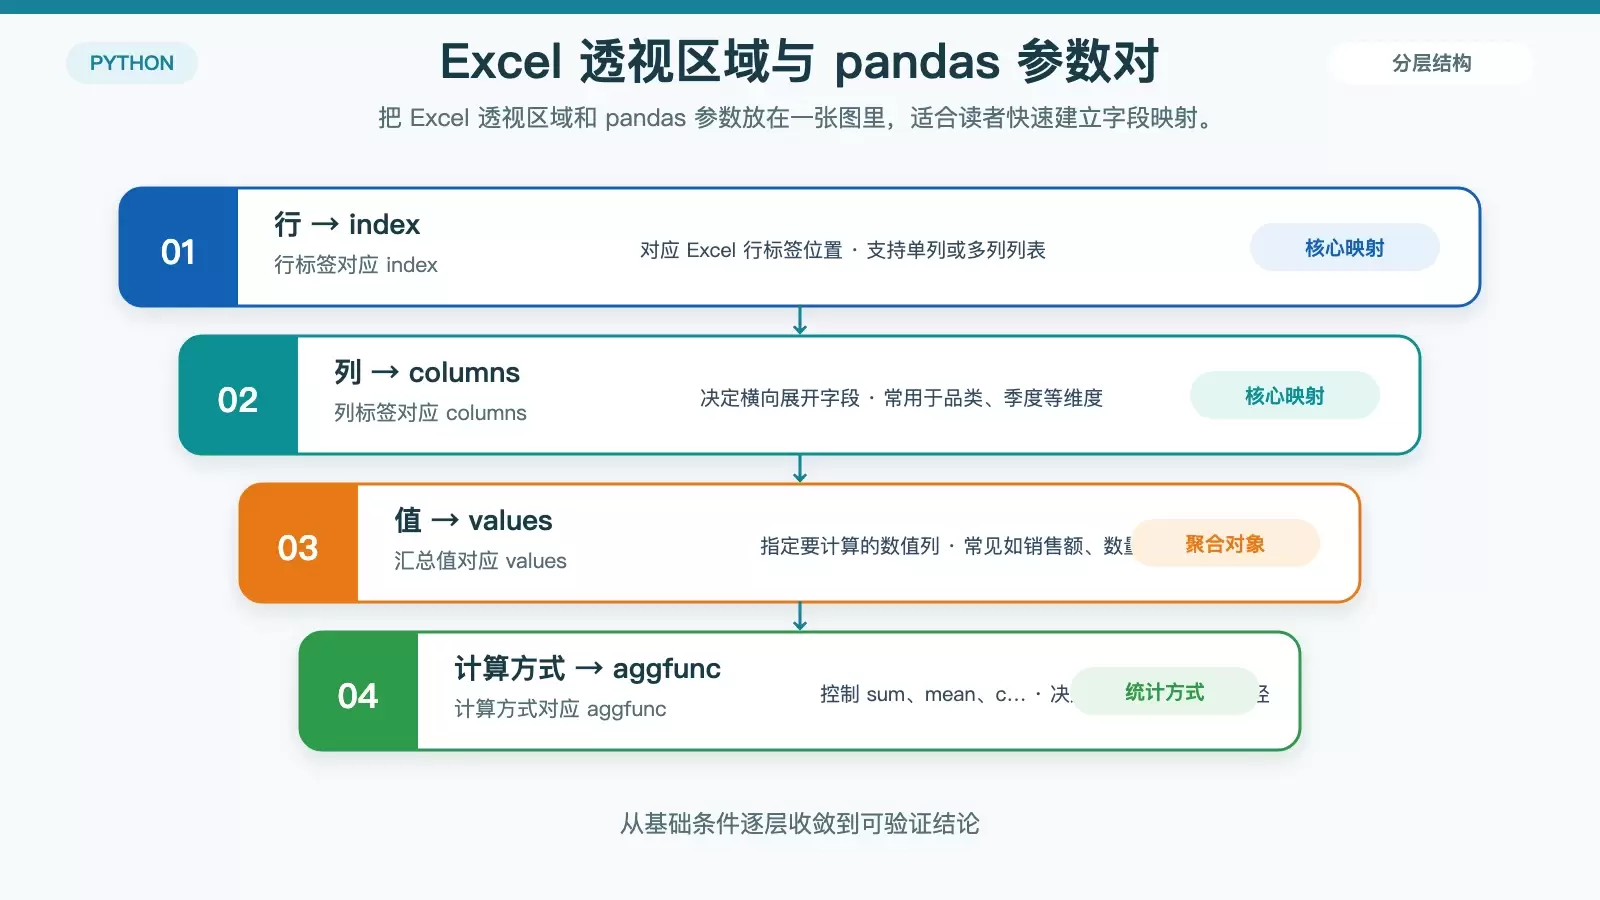
这篇文章从 Excel 用户最熟悉的数据透视表思路切入,拆解 pandas `pivot_table` 的常用参数、层级汇总和多统计值写法,再延伸到批量处理多个文件、多个 Sheet 与多报表导出的实战流程,适合拿来替代重复的手工拖拽。
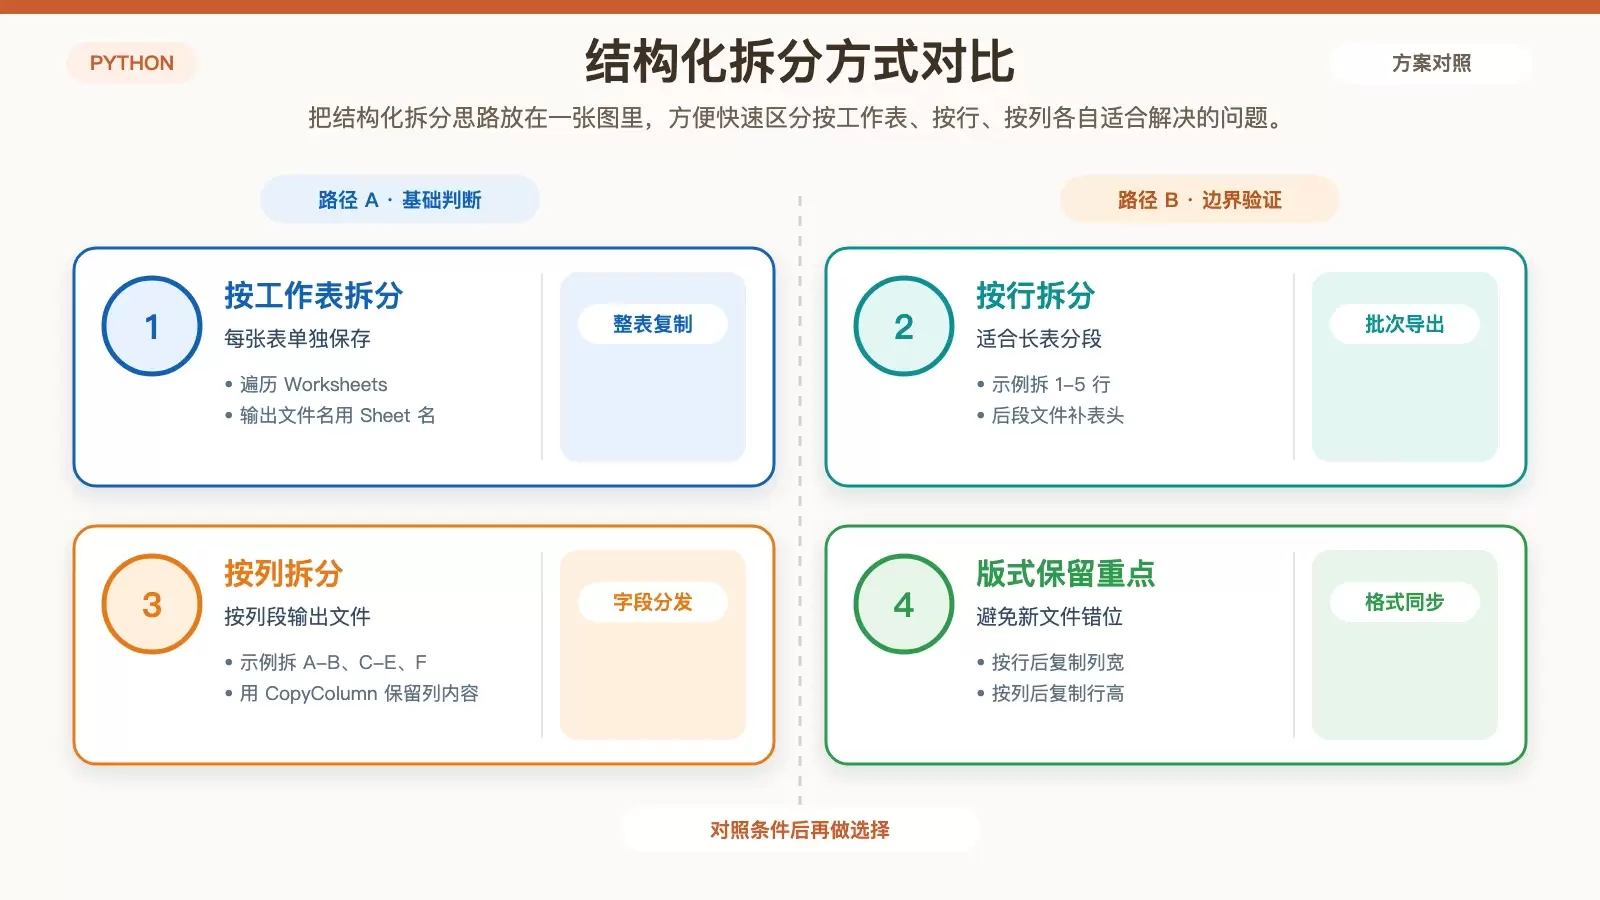
这篇文章围绕 Python 中常见的 Excel 拆分需求,整理了基于 Spire.XLS for Python 的四种实现思路:按工作表、按行、按列,以及按字段条件分类输出。文中保留安装方式、核心对象和完整示例代码,并补出适用场景与实现要点,便于直接对照业务需求选型。
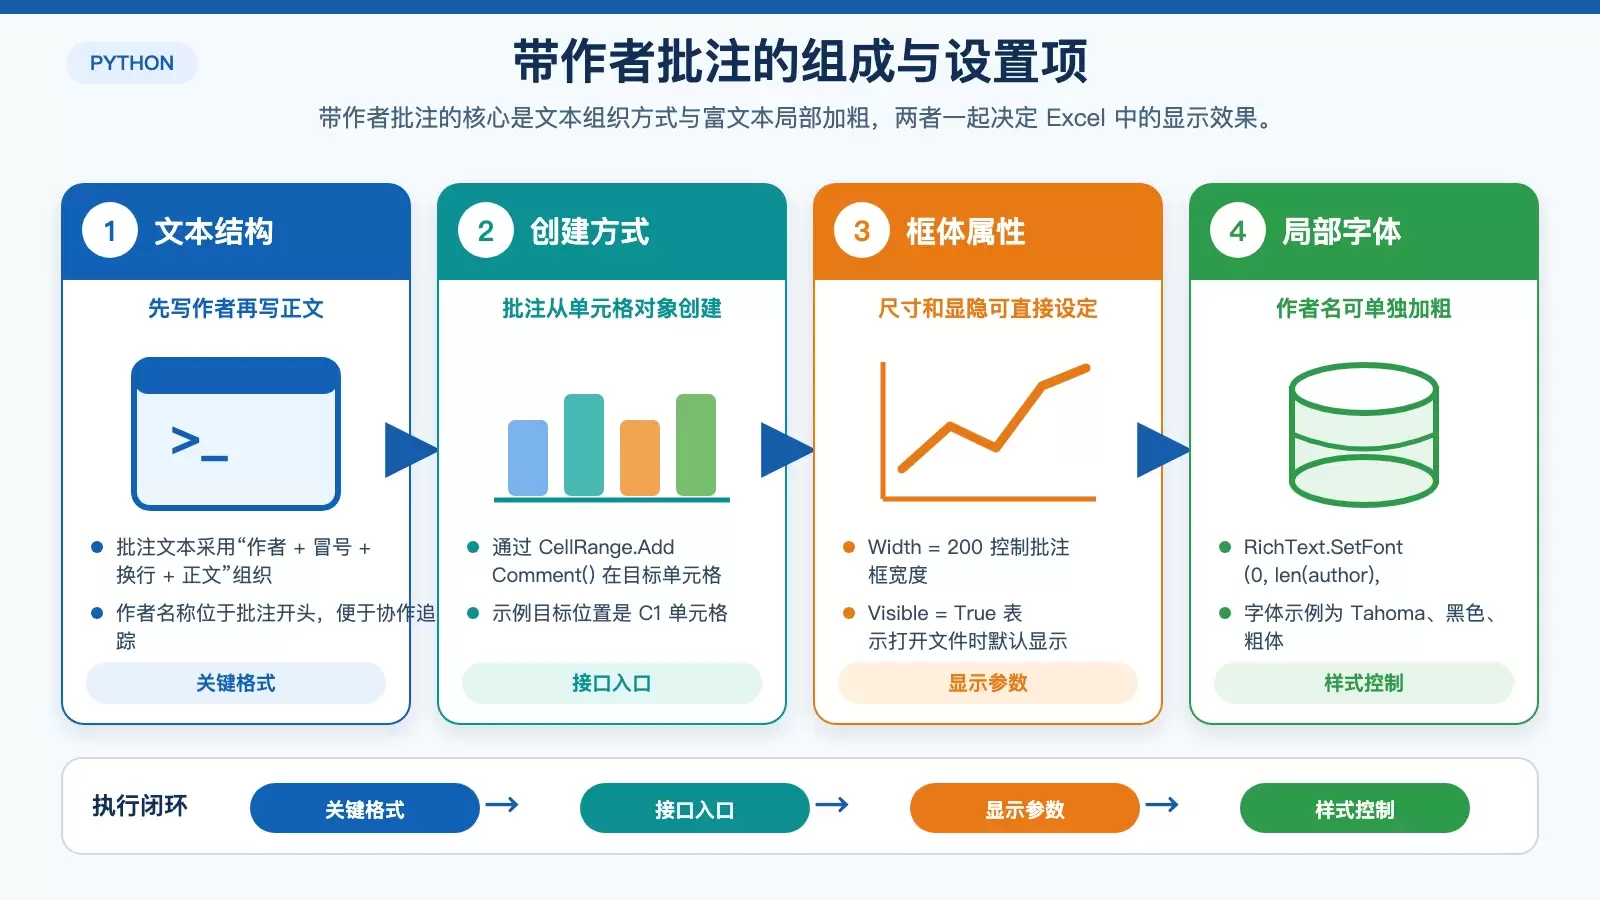
这篇文章用 Spire.XLS for Python 梳理了 Excel 批注的常见自动化操作,包括添加作者批注、设置富文本和外观、批量读取,以及修改和删除。文中保留了关键代码与接口说明,也补充了批量处理时最容易踩到的索引问题。
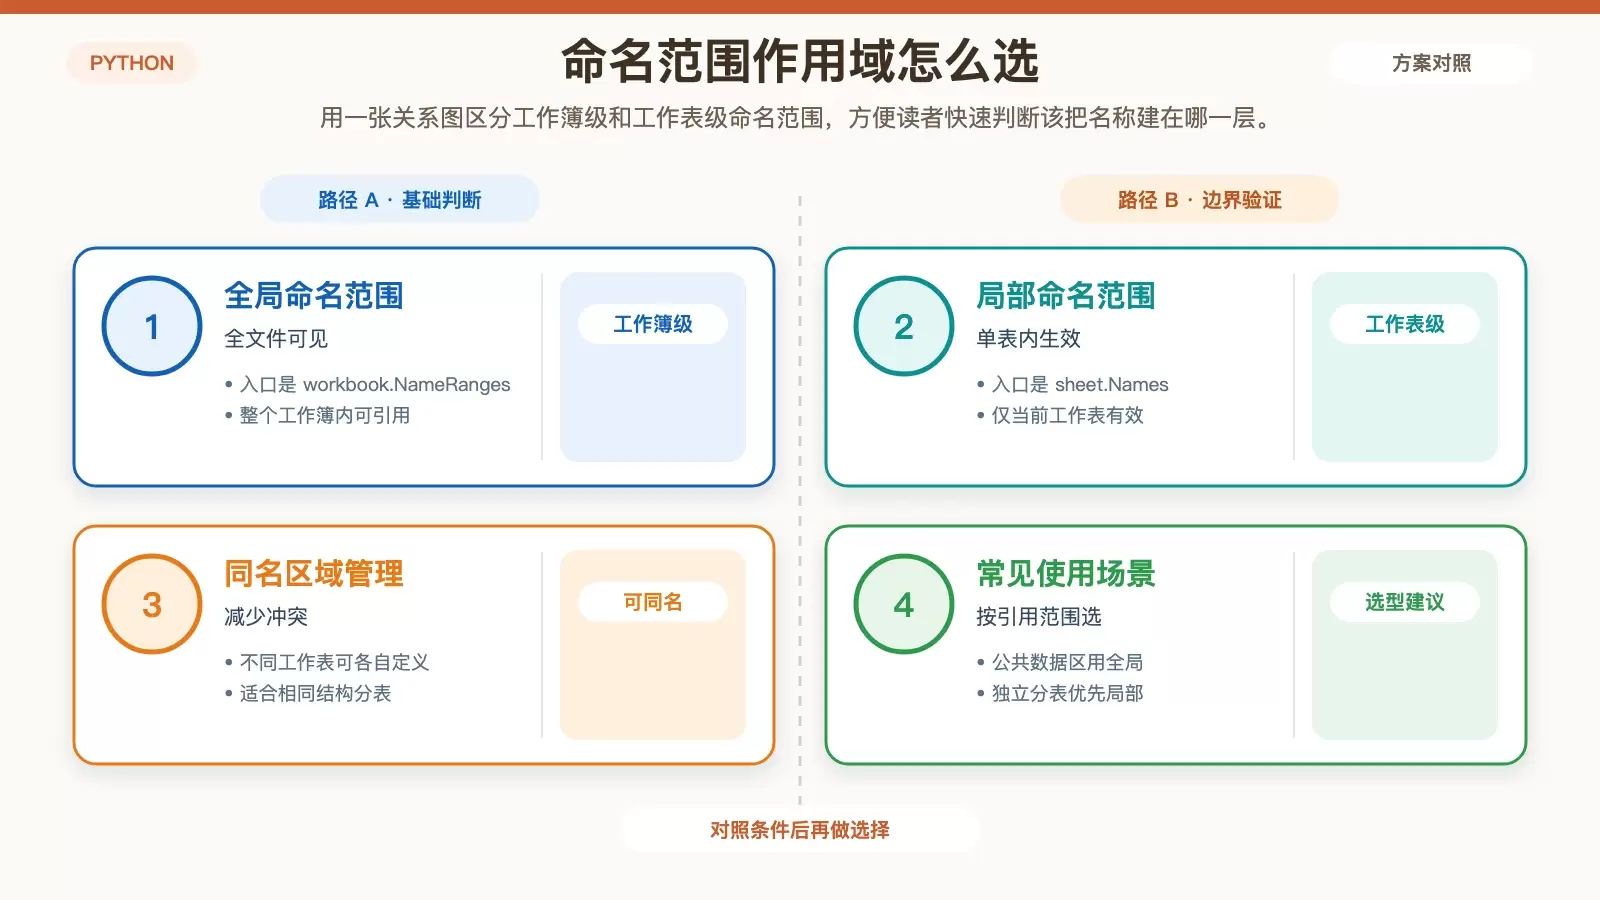
命名范围能把 Excel 里难记的 A1:D10 变成可读的业务名称,适合公式复用和自动化脚本维护。本文用 Spire.XLS for Python 梳理创建、查询、重命名、样式处理、公式引用与删除等常见操作,并说明工作簿级与工作表级作用域该怎么选。
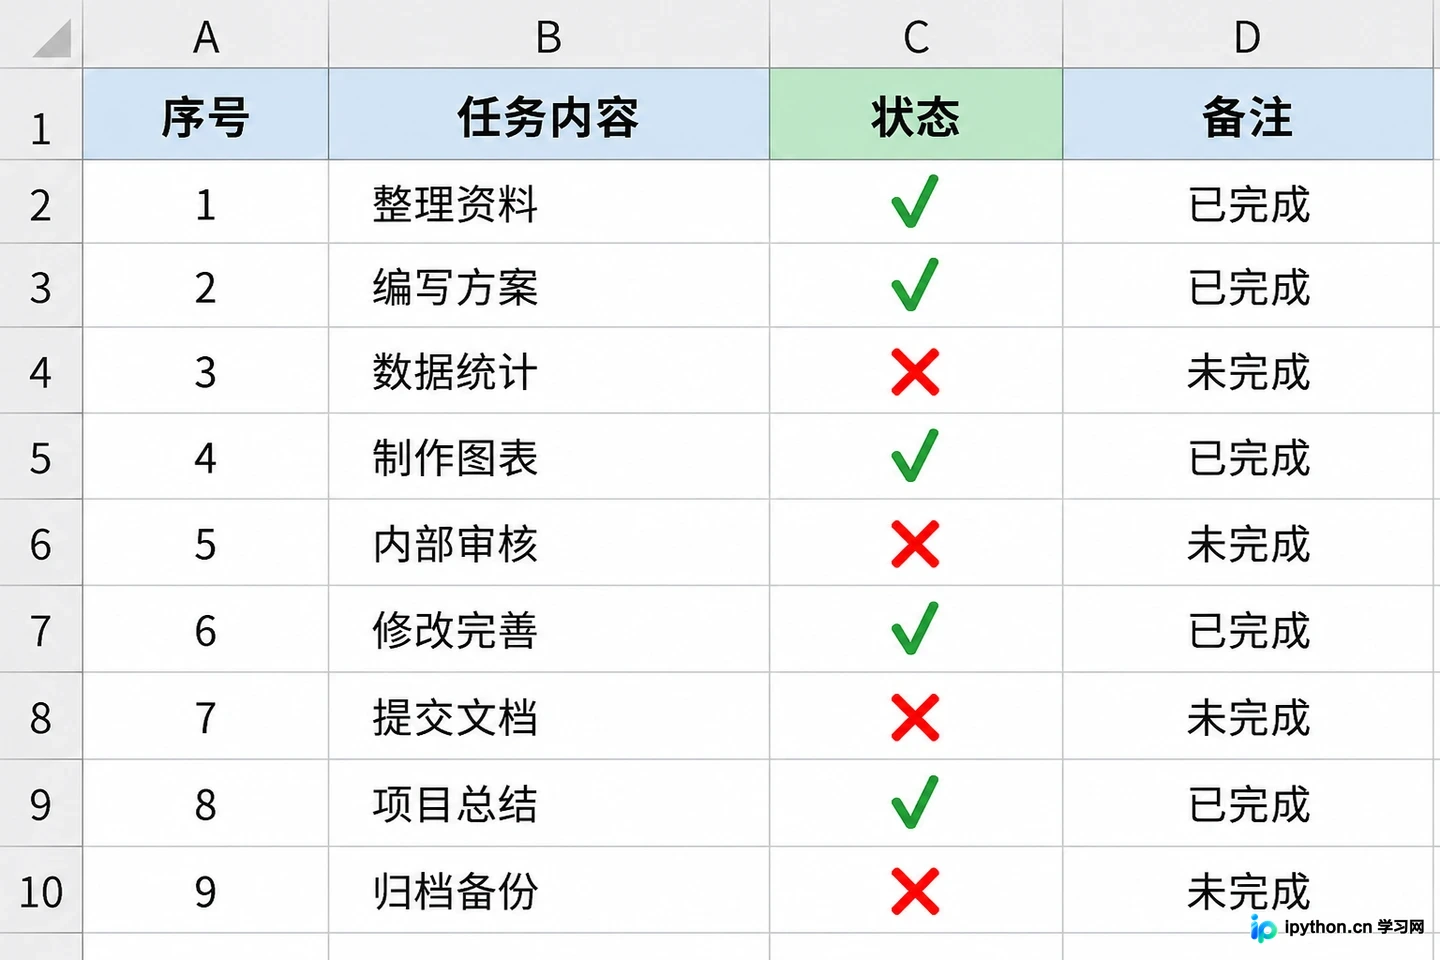
本文介绍在Excel中实现打勾√和打叉×标记的三种方法:直接输入、插入符号以及创建下拉选择列表。通过数据验证功能制作下拉菜单,可确保多人协作时格式统一;配合条件格式还能实现自动变色,提升表格的可读性和统计效率。
本文详细介绍Python中openpyxl模块的使用方法,涵盖创建新Excel文件、读取现有xlsx工作簿、管理工作表(增删改查)以及单元格数据的定位与赋值。重点说明openpyxl仅支持.xlsx格式的读写限制,并提供完整的代码示例与操作参数说明。
本文详解在Python中读取Word文档内嵌Excel文件的两种方案。第一种利用Windows COM接口调用宏,依赖Office或WPS环境;第二种通过解析Word ZIP结构中的OLE二进制文件,结合olefile与openpyxl实现跨平台快速读取。
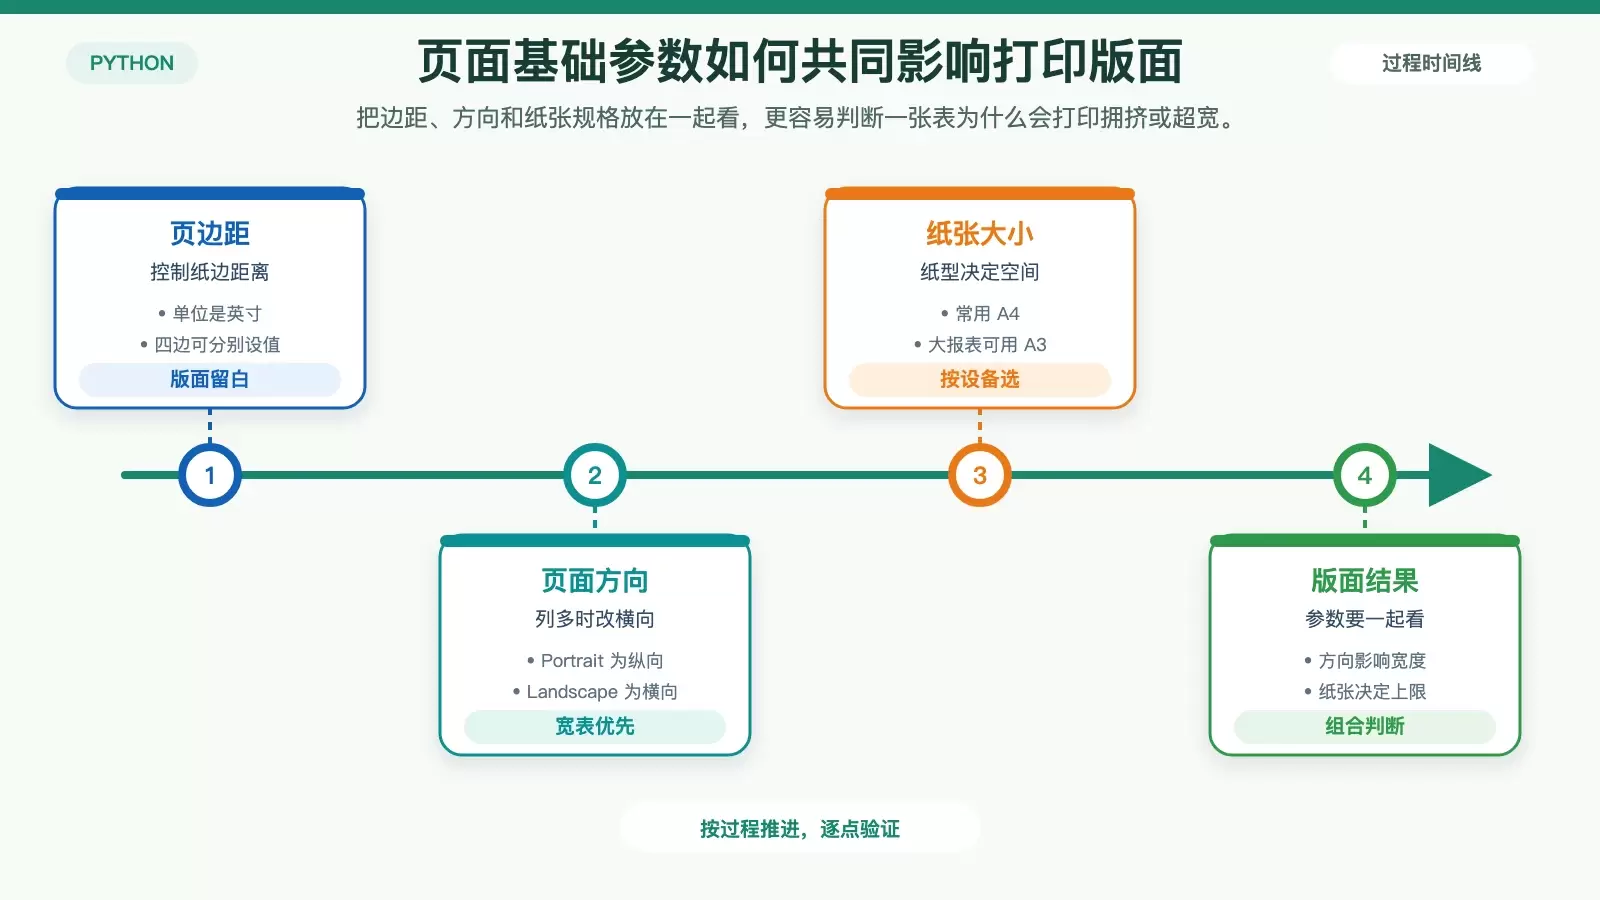
用 Python 生成 Excel 时,只把数据写进去往往不够,真正到打印预览阶段,边距、方向、表头重复和缩放才决定成品是否可用。本文基于 Spire.XLS for Python,梳理几项最常用的页面设置,并给出可直接套用的综合示例。
本文详细介绍了在C#中将DataTable数据导出为Excel文件的两种常见实现方案。第一种基于商业组件Aspose.Cells,支持直接保存并自定义单元格样式、边框及对齐方式,适合对格式有较高要求的场景;第二种基于开源库NPOI(HSSF),通过遍历处理数据行并按65536行限制分Sheet存储,适用于需要兼容旧版.xls格式的批量数据处理。两者均提供了完整的代码示例以供参考。
本文详细介绍Python中openpyxl模块读取Excel文件的方法。涵盖加载工作簿、获取工作表、读取单元格值、处理行列数据及切片操作等核心功能,帮助开发者高效处理Excel数据。
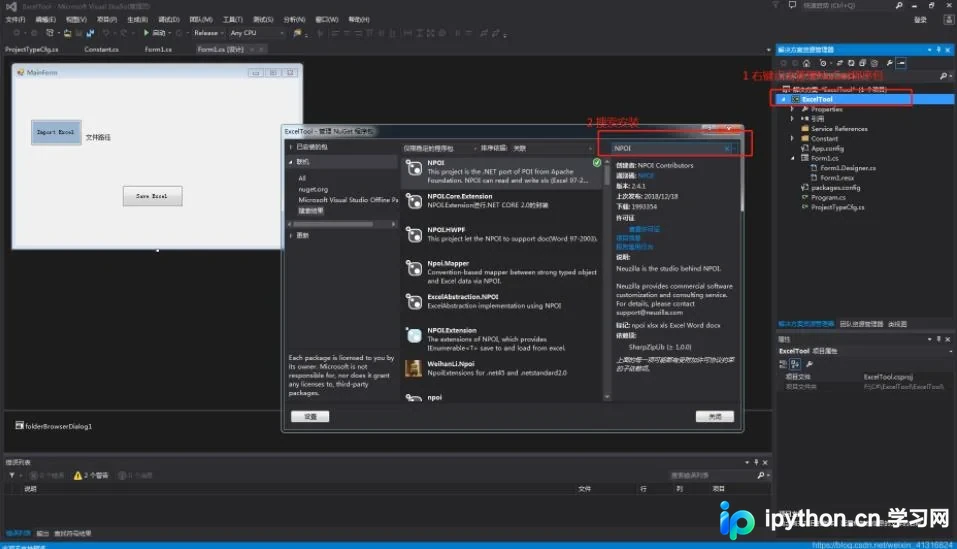
本文详解在C#项目中通过NuGet引入NPOI库管理Excel文件的方法。涵盖从创建项目引用到核心代码实现的完整流程,包括打开工作簿、逐行遍历单元格获取数据,以及修改单元格值并保存文件的具体操作。适用于需要在非Office环境下高效处理Excel数据的.NET开发者。