

pandas DataFrame检测重复值与去重方法详解
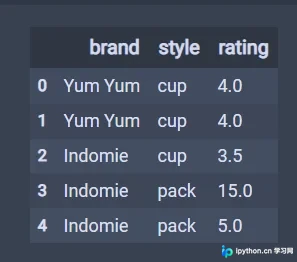
本文详细介绍pandas中DataFrame检测重复值的方法,包括duplicated函数的subset、keep参数用法及示例,以及如何通过布尔索引查询和统计重复记录个数。
2026-10-14
7

本文详细介绍pandas中DataFrame检测重复值的方法,包括duplicated函数的subset、keep参数用法及示例,以及如何通过布尔索引查询和统计重复记录个数。
本文系统讲解Python面向对象编程核心概念,涵盖类的定义、初始化函数__init__及self参数作用。详细区分公有、私有及受保护变量的访问规则,深入解析实例方法、静态方法与类方法的调用差异,并介绍常用特殊方法如构造函数与析构函数,帮助开发者掌握Python类的高级用法。
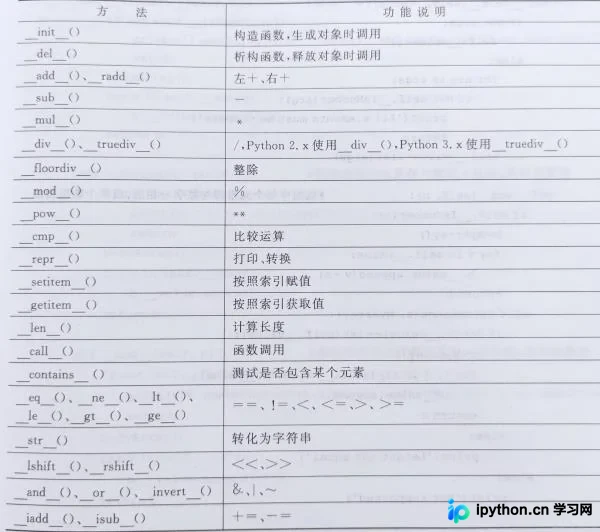
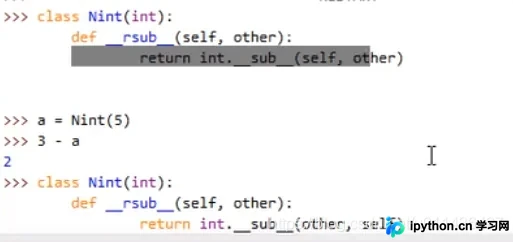
本文系统总结Python中常用的魔法方法,涵盖算术运算符(如__add__、__sub__)的重写技巧,重点解析反运算机制(如__radd__)在操作数顺序不同时的调用逻辑,以及增量赋值(__iadd__)和一元操作符(__neg__、__abs__)的具体实现。通过代码示例说明如何避免无限递归并正确重载运算符。
本文详细介绍如何使用Python结合pymysql库实现一个简易的学生选课系统。文章涵盖实验环境配置、First_run.py数据库初始化脚本及second_run.py核心业务逻辑代码,解析student_login、course等表结构,并展示系统运行效果与不足,为Python数据库应用提供实战参考。
本文详细解析Django模板中常用的数据过滤器,包括add、cut、date、default等。通过对比源码与示例代码,深入理解各过滤器的处理逻辑、参数传递方式及边界情况,帮助开发者更高效地处理模板数据。
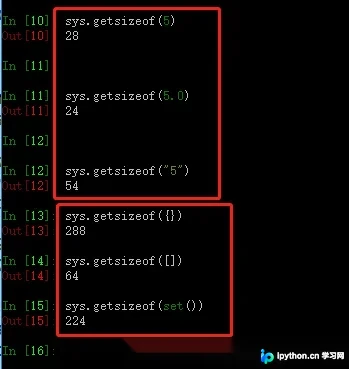
本文深入解析Python中sys.getsizeof函数的用法及其底层原理。通过对比C++与Java,揭示Python中一切皆对象的特性导致int、float等类型占用内存远大于传统认知。文章结合代码示例,展示如何查看不同数据类型的实际内存开销,并解释Python解析器将代码映射为C结构体时的额外存储开销,帮助用户更精准地理解Python内存管理机制。
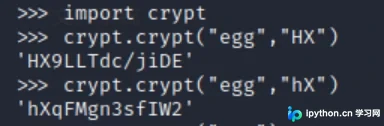
本文详细介绍如何使用Python脚本结合crypt模块对Linux系统进行密码破解测试。通过解析/etc/shadow文件中的加密格式,提取盐值(salt)与哈希算法ID,利用字典文件进行暴力匹配。文章涵盖Python字符串split()方法的深入应用及代码实现细节,旨在帮助安全研究人员理解口令验证机制。
本文介绍在 Python 中获取目录文件列表并进行自然排序的多种方法。包括使用 os.listdir 结合 lambda 表达式进行自定义排序,利用 natsort 库实现自然排序,以及按文件修改时间排序的技巧。文章提供了具体的代码示例,帮助开发者高效处理批量文件操作。
本文介绍如何使用Python的crypt模块模拟Linux密码加密机制,通过读取/etc/shadow文件提取盐值和哈希值,结合密码字典进行暴力破解。文章详细解析了SHA-512等哈希算法格式,并提供了完整的Python脚本代码及运行示例,适用于Kali Linux环境下的安全测试。
本文深入解析 Python 装饰器的核心机制与应用场景,涵盖日志记录、权限校验等切面需求。详细讲解 @ 语法糖的使用、带参/无参函数的自适应处理、functools.wraps 对元数据的保留,以及通过类实现优雅的多层装饰器模式,帮助开发者掌握高阶函数编程技巧。
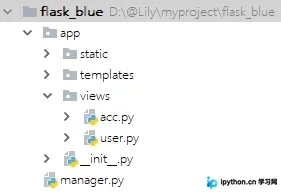
本文详细解析了Flask官方推荐的目录结构,包括蓝图(Blueprint)的注册与应用工厂模式。接着介绍了如何集成Flask-SQLAlchemy进行数据库操作,利用Flask-Script实现命令行启动与自定义脚本,并通过Flask-Migrate完成数据库迁移。涵盖从项目搭建到数据库管理的完整流程,适合Flask初学者参考。
本文深入解析Python函数参数传递机制,重点区分可变与不可变对象在传参时的行为差异。通过代码示例说明整型、元组等不可变对象无法在函数内修改原值,而列表、字典等可变对象可被修改。掌握此原理有助于避免常见的变量作用域陷阱,编写更健壮的Python代码。