Debian 中 Python 如何处理异常
在 Debian 上写 Python 时,异常处理机制与其他操作系统并无差异,核心仍是 `try`、`except`、`else` 与 `finally`。本文结合一个除零示例,说明各代码块何时执行、该如何分工,以及为什么这套写法足以覆盖大多数常见报错场景。
2026-08-24
247

在 Debian 上写 Python 时,异常处理机制与其他操作系统并无差异,核心仍是 `try`、`except`、`else` 与 `finally`。本文结合一个除零示例,说明各代码块何时执行、该如何分工,以及为什么这套写法足以覆盖大多数常见报错场景。
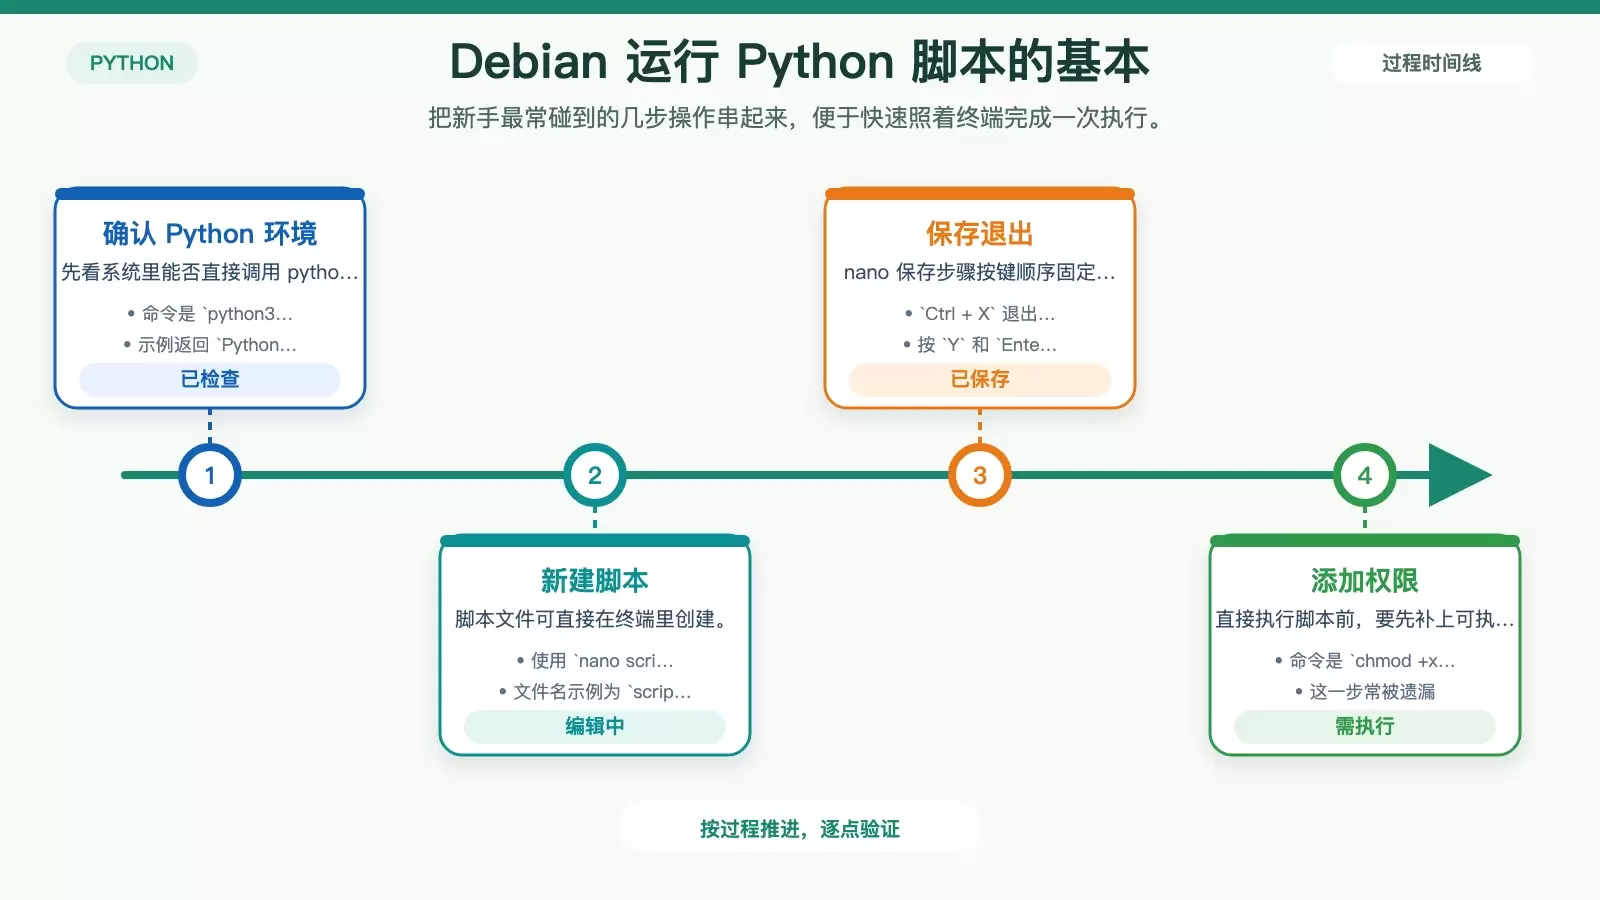
在 Debian 上运行 Python 脚本并不复杂,关键是先确认 `python3` 可用,再按“创建脚本、赋权、执行”的顺序操作。本文把两种常见运行方式和各自适用场景拆开讲清,方便你快速上手。 在 Debian 里执行 Python 脚本并不难,但很多初学者第一次上手时,往往会卡在环境确认、文件保存,或者“为什么不能直接运行脚本”这类细节上。
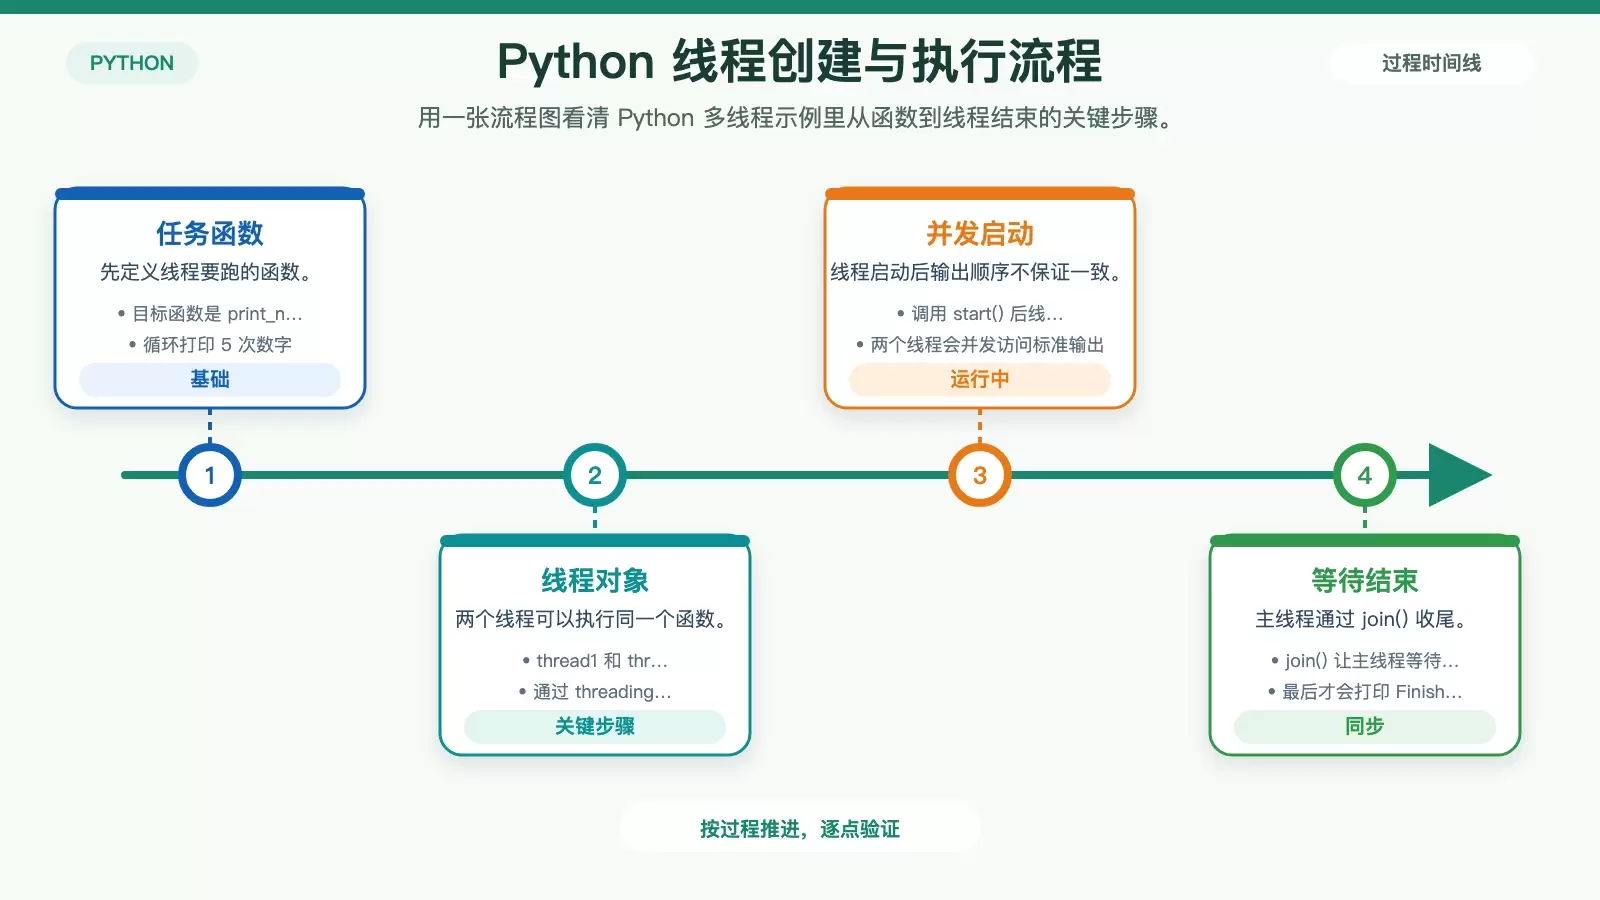
在 Ubuntu 上写 Python 多线程,最常用的是标准库 `threading`。本文从线程创建、`start()` 与 `join()` 的基本用法讲起,再解释共享数据为什么要配合 `Lock`,最后说明 GIL 对性能的实际影响,帮助你判断多线程适合 I/O 场景还是该改用 `multiprocessing`。
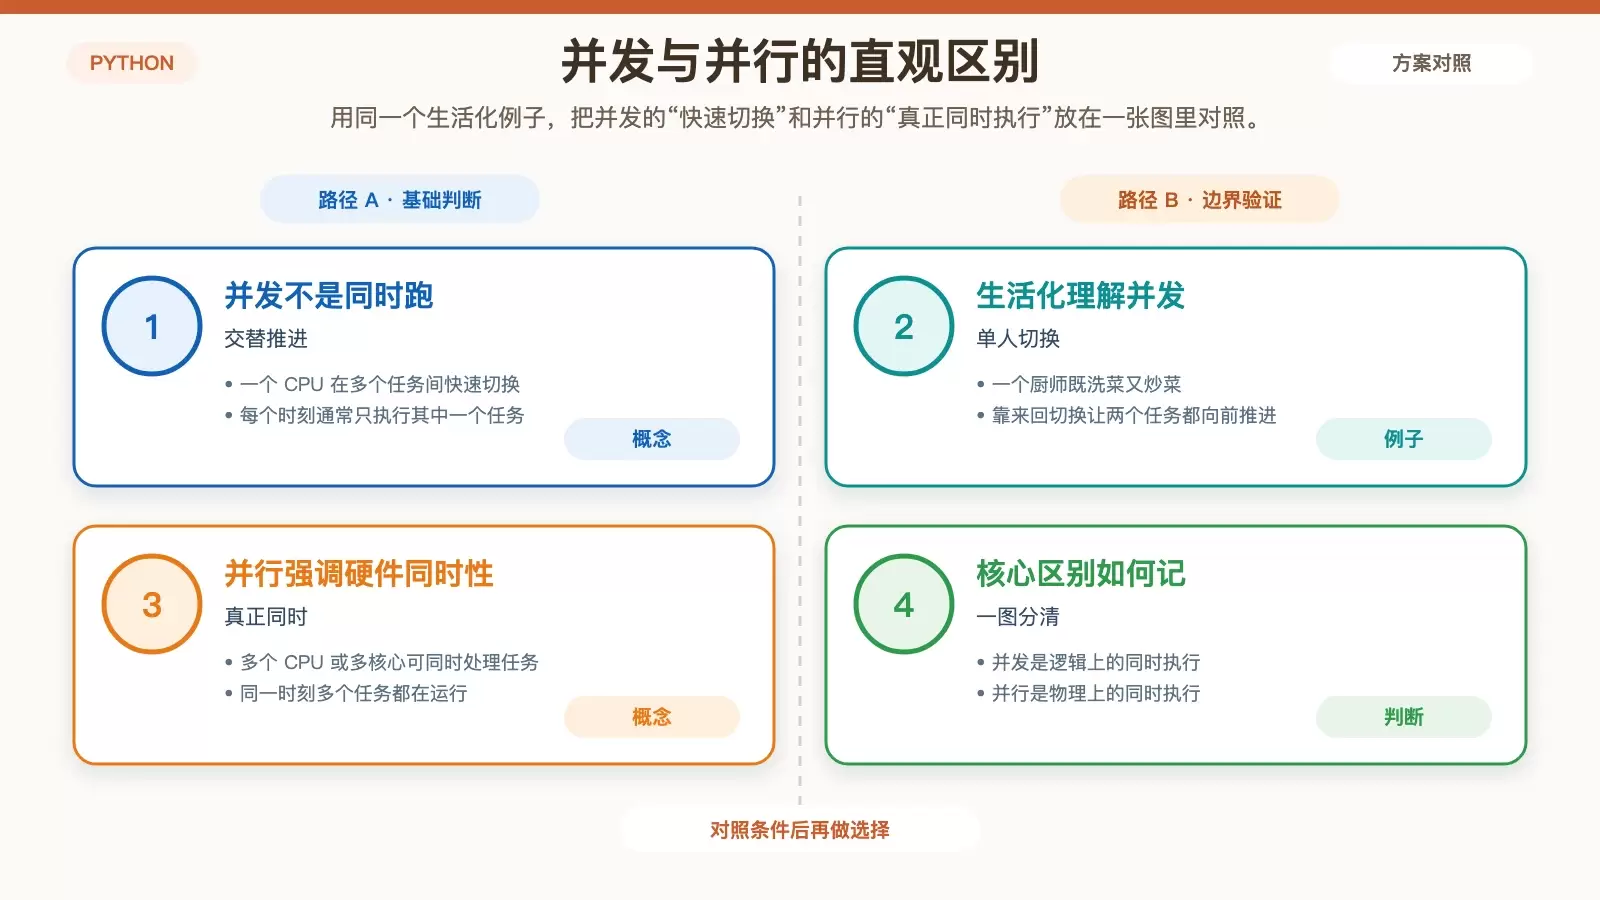
并发和并行常被混着说,但它们解决的不是同一件事。本文用直观例子拆开两者差别,并顺着 Python 常见的多进程、多线程、多协程三种模型,梳理各自优势、限制与适用场景。 很多初学者一接触 Python 并发编程,就会先被两个词绕住:并发和并行听起来很像,但放到程序设计里,判断标准完全不同。
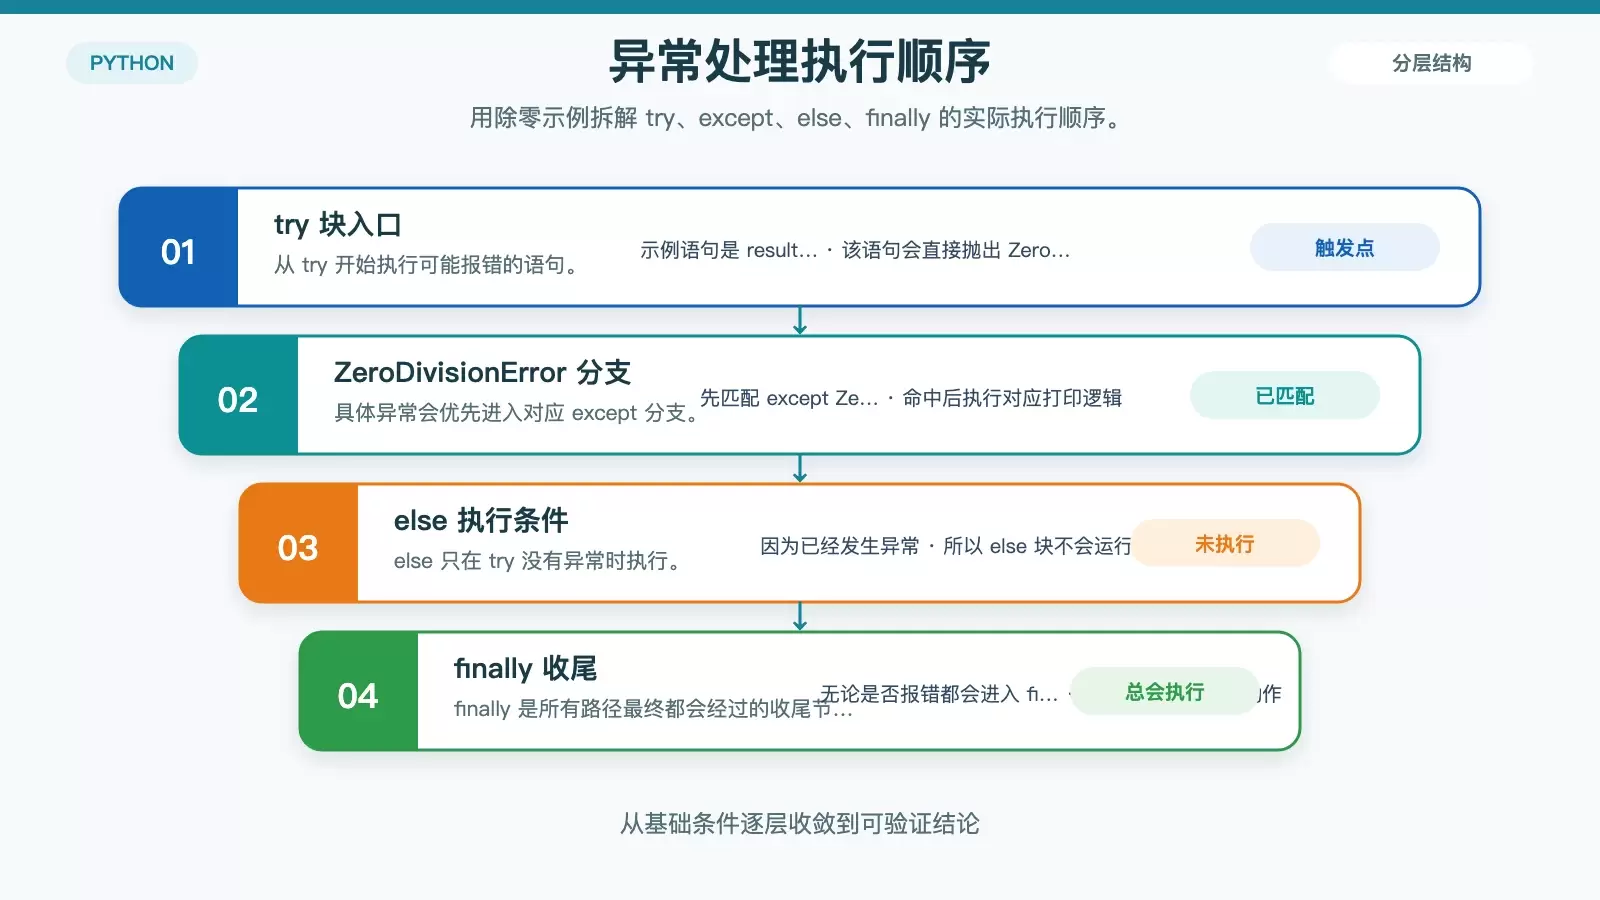
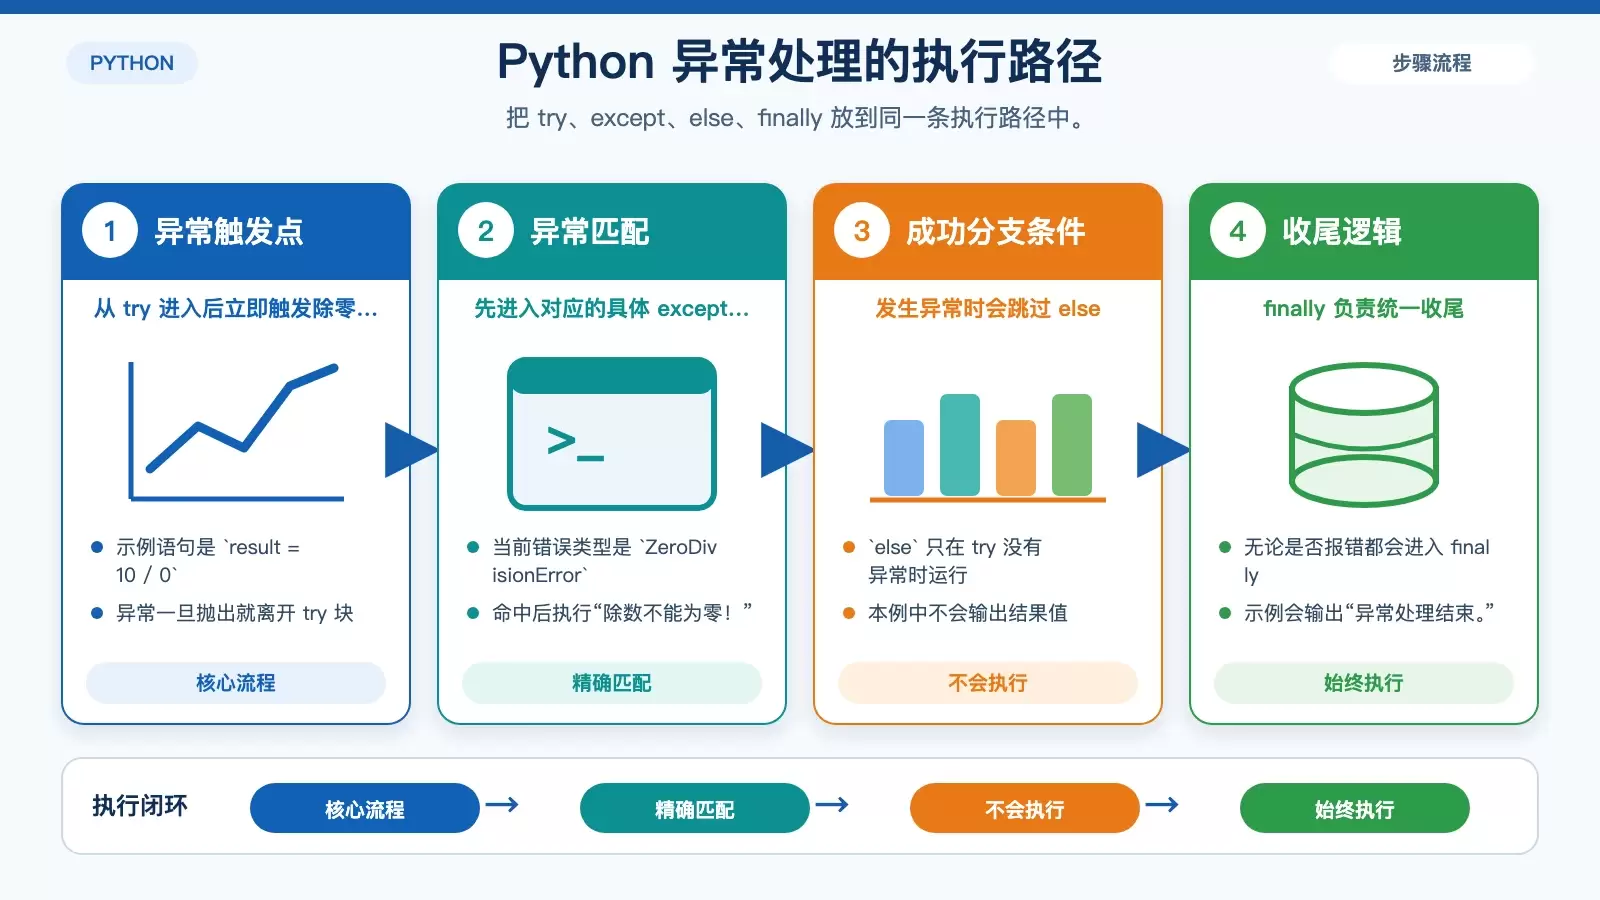
Python 异常处理的核心是用 `try` 捕获可能出错的代码,再用 `except`、`else`、`finally` 分别处理错误、成功分支和收尾动作。本文结合一个除零示例,拆开说明各个代码块的执行顺序和适用场景。 写 Python 脚本时,最怕的不是代码报错,而是程序一遇到异常就直接中断,既不知道问题在哪,也没有留下收尾动作。
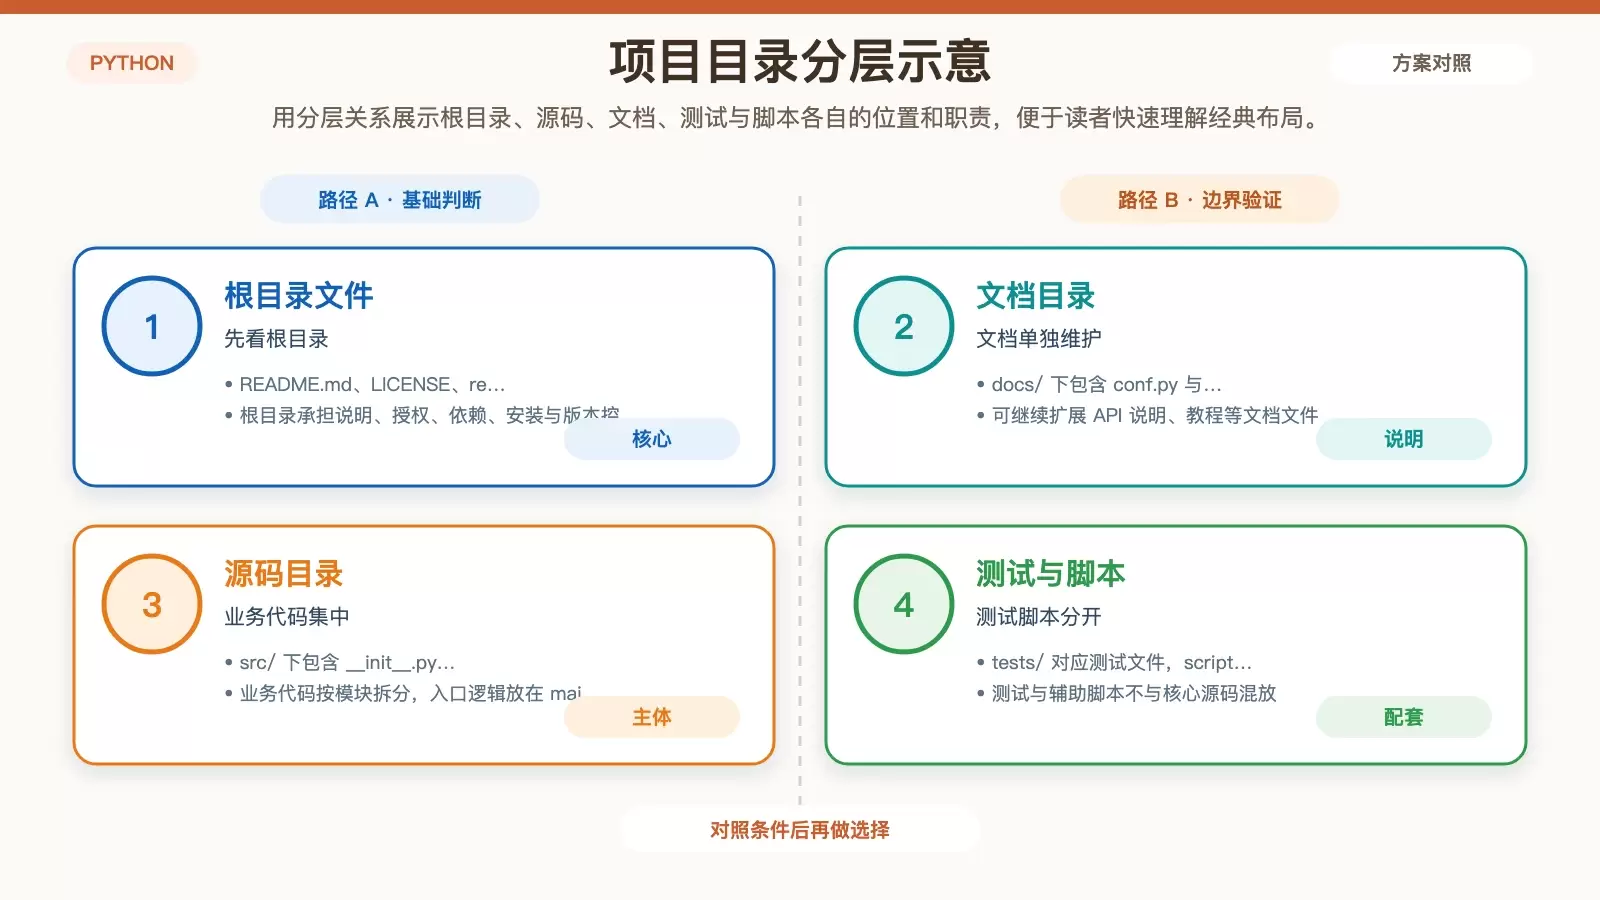
在 CentOS 上做 Python 项目,目录怎么分、文件放哪儿,直接影响后续维护、测试和交接效率。本文按根目录、源码、文档、测试与脚本几个层次拆解一套常见结构,并补充虚拟环境、代码规范、CI/CD 与日志管理等实践,方便你判断哪些约定值得一开始就定下来。
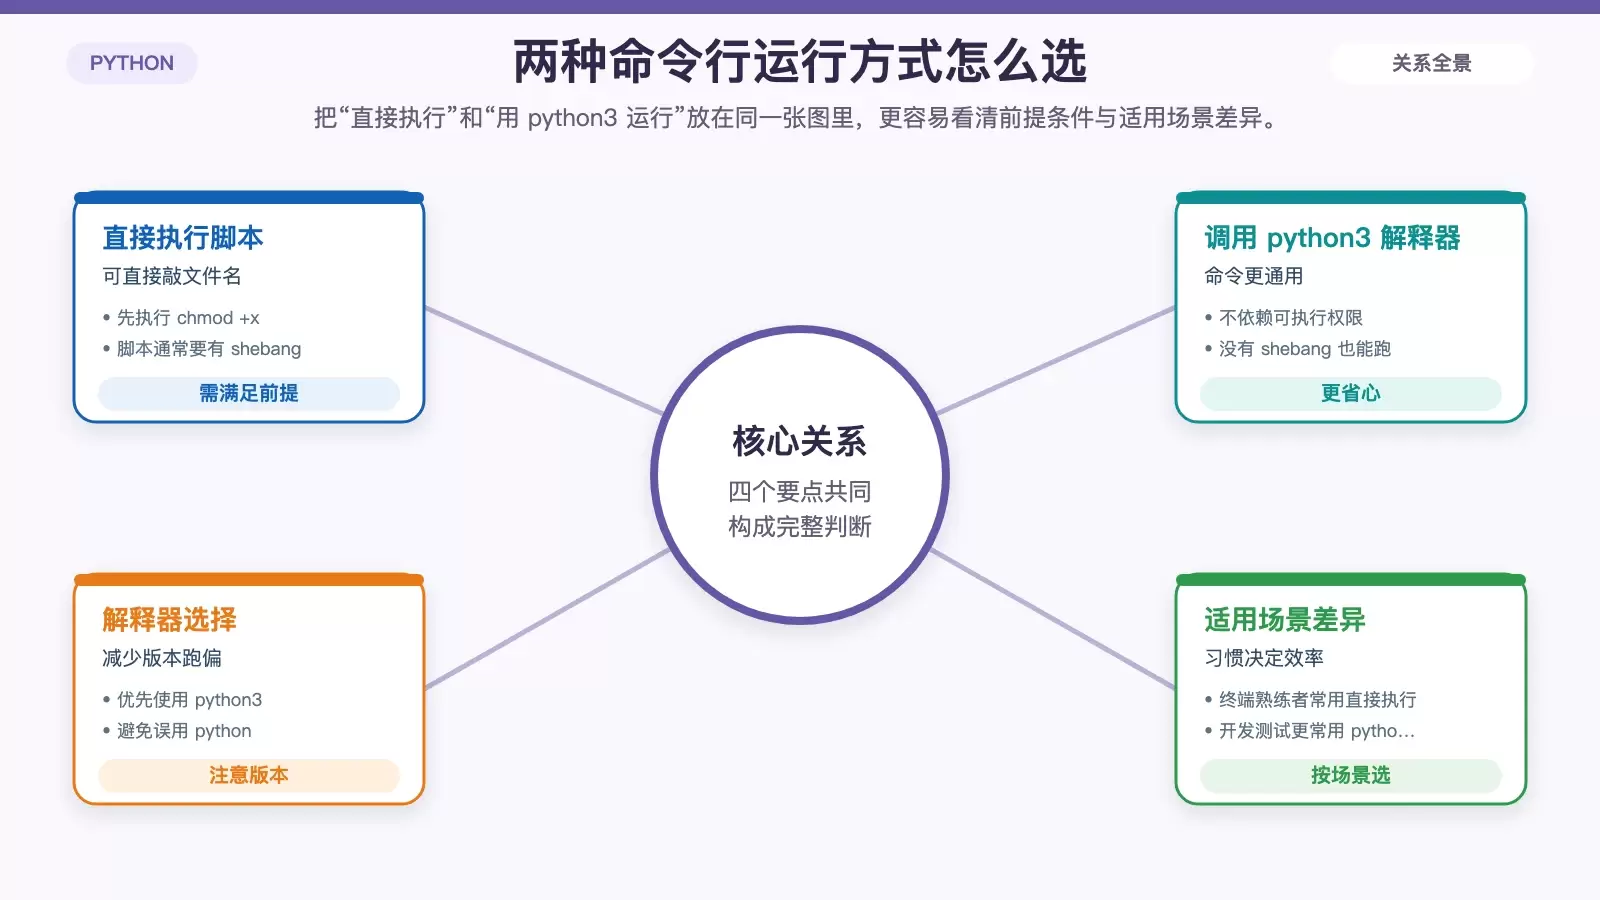
在 Ubuntu 里运行 Python 脚本,常见做法主要有三类:直接在终端执行、显式调用 `python3` 解释器,以及通过 `.desktop` 快捷方式双击启动。三种方式对应的前提条件和适用场景不同,选对方法能少踩权限、版本和启动方式上的坑。
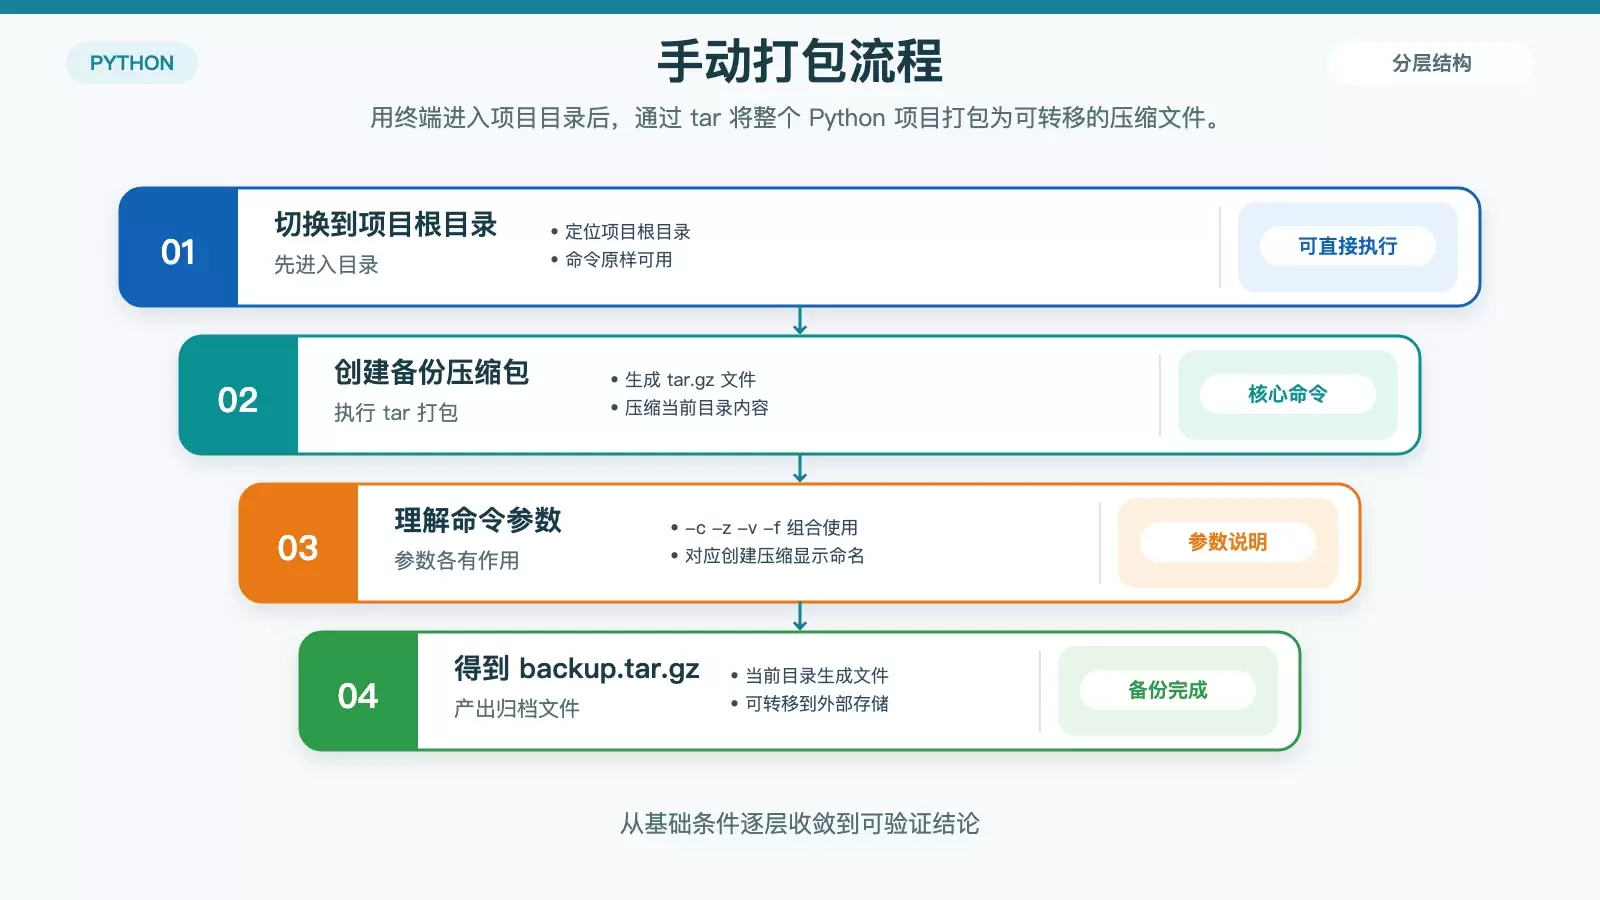
在 Ubuntu 上备份 Python 项目并不复杂,关键是把“项目文件”和“可恢复所需依赖”一起保存。本文按手动打包、定时自动备份、依赖补全三个部分整理出可直接执行的命令,并说明各参数和使用场景,方便你判断是临时归档还是长期定时备份更合适。
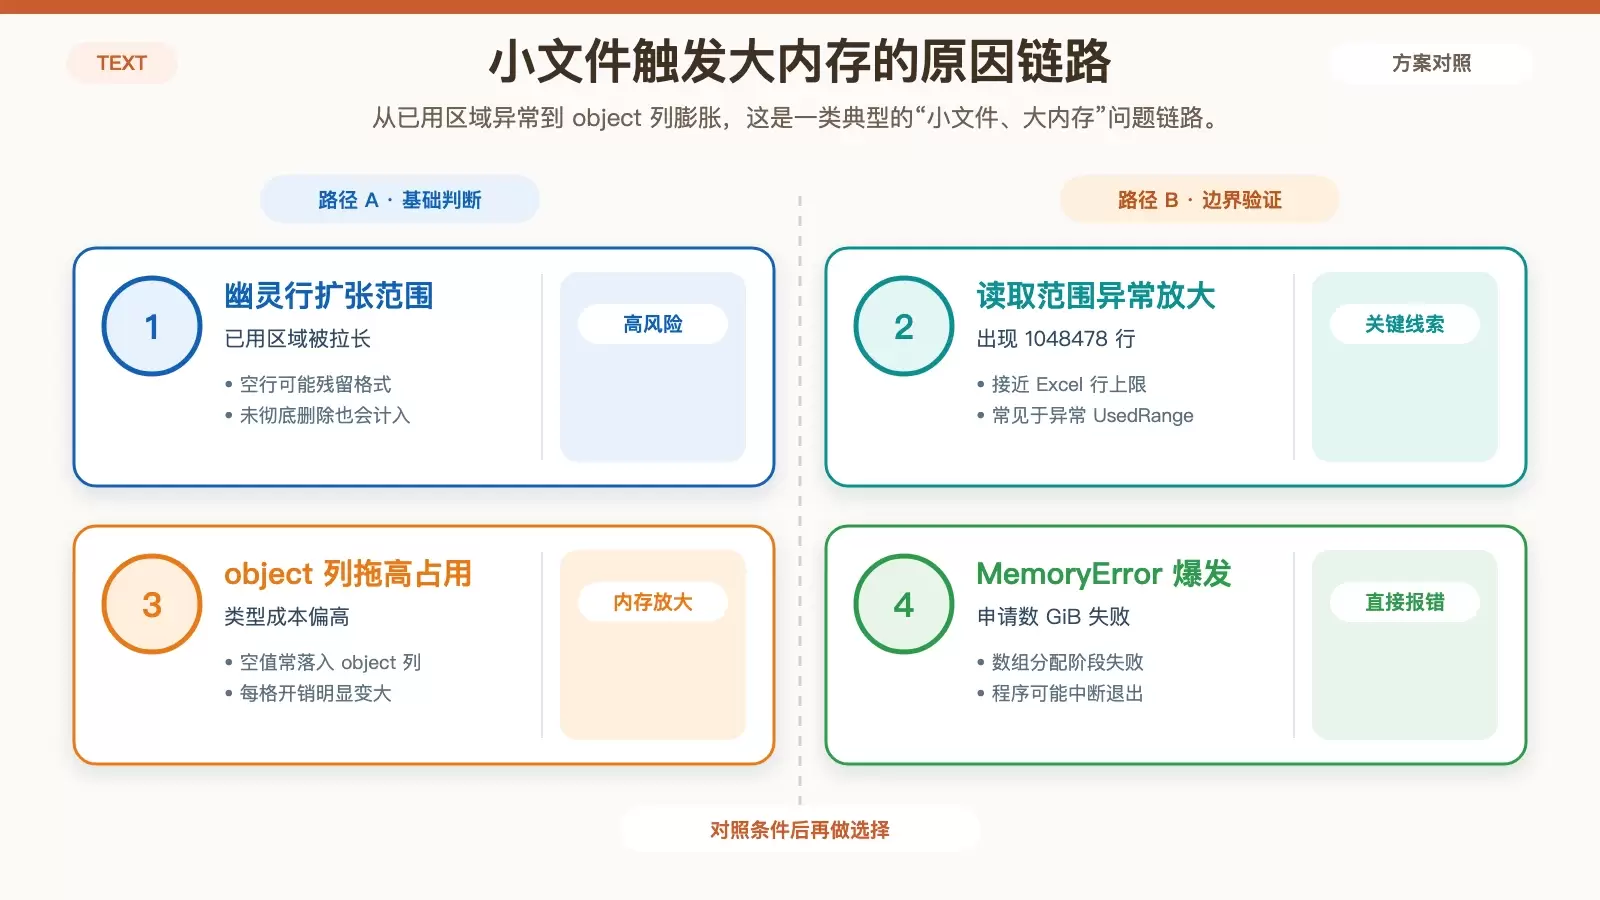
Pandas 读取 Excel 时出现 MemoryError,并不一定意味着文件真的很大。很多情况下,问题出在 Excel 的“已用区域”被异常拉长,配合 object 类型列和未及时释放对象,最终触发数 GiB 级内存申请。本文结合报错特征、成因和可直接落地的处理方式,整理出一套更稳妥的 Excel 解析思路。
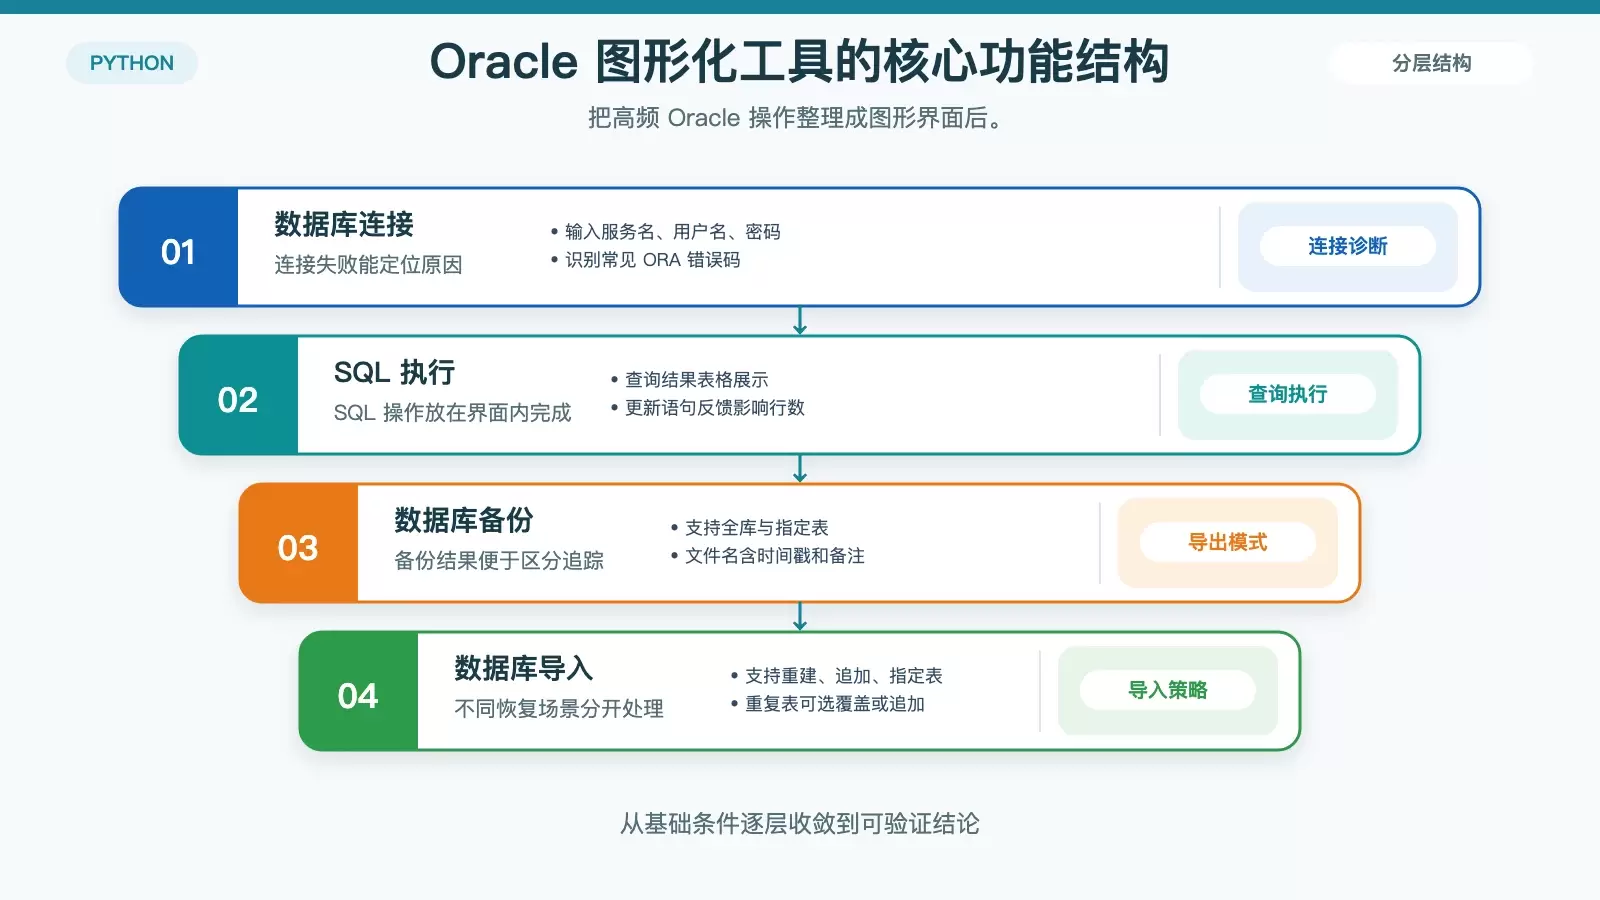
这款用 Python + Tkinter 编写的 Oracle 图形化工具,核心目标是把常见的备份、导入、SQL 执行和用户管理操作,从难记的命令行改成可视化流程。文章按实际使用场景梳理实现思路、关键代码和部署方式,便于判断它是否适合团队日常运维。
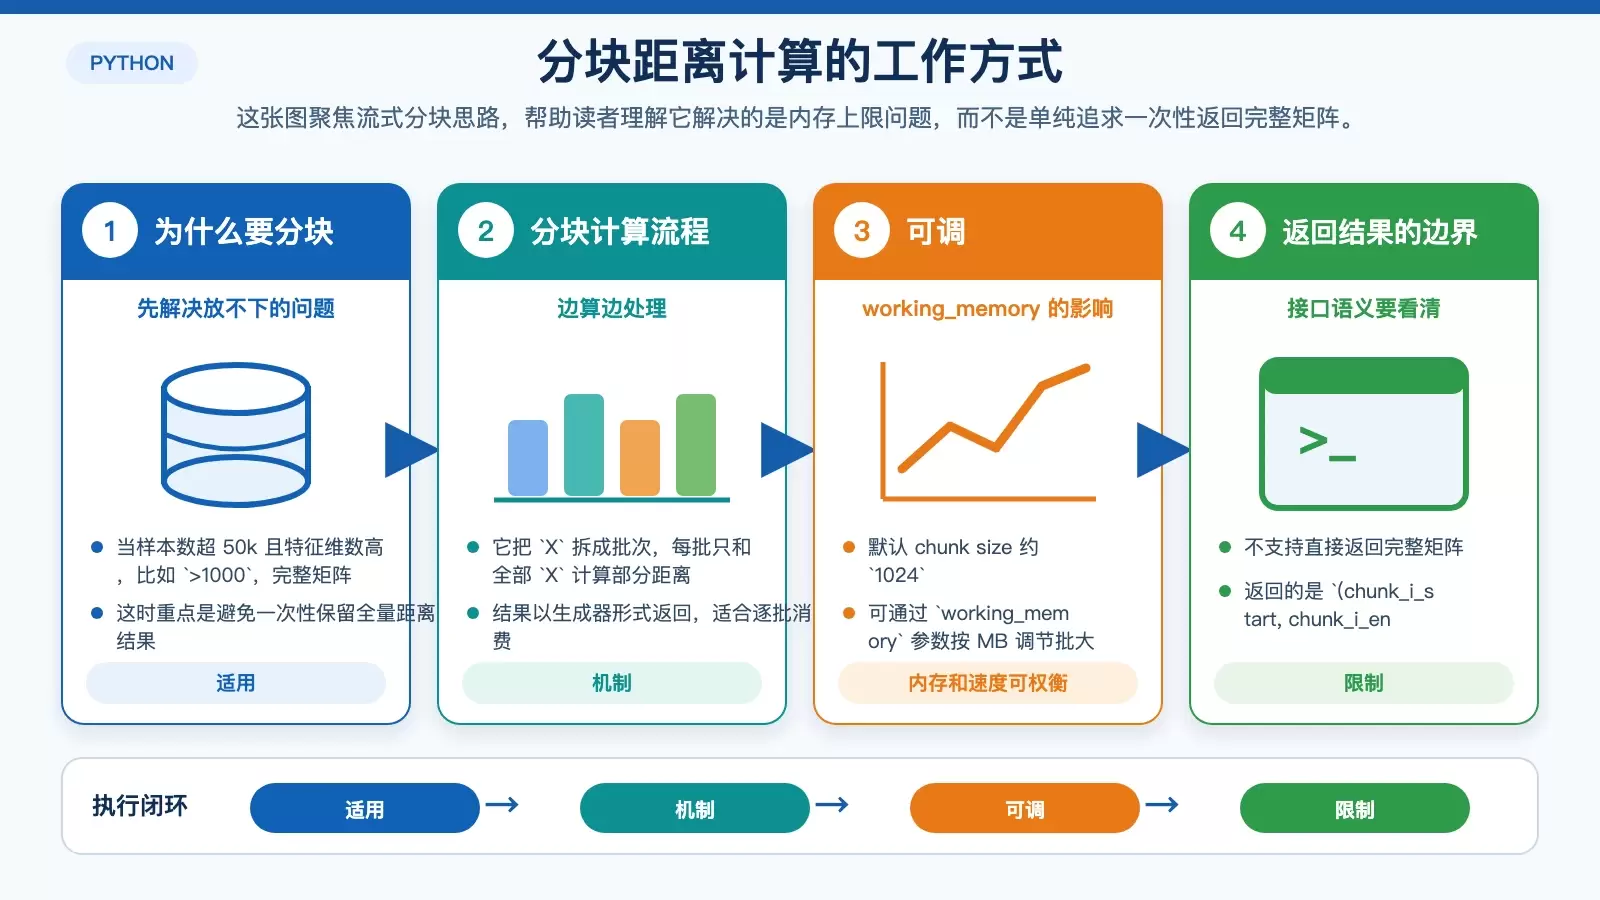
计算大规模欧氏距离矩阵时,性能问题往往不在公式本身,而在中间数组和内存占用。本文按数据规模拆解 `cdist`、`pdist`、`pairwise_distances_chunked` 与 `einsum` 的适用边界,帮助你判断什么时候该直接算、什么时候该分块、什么时候别急着上 GPU。
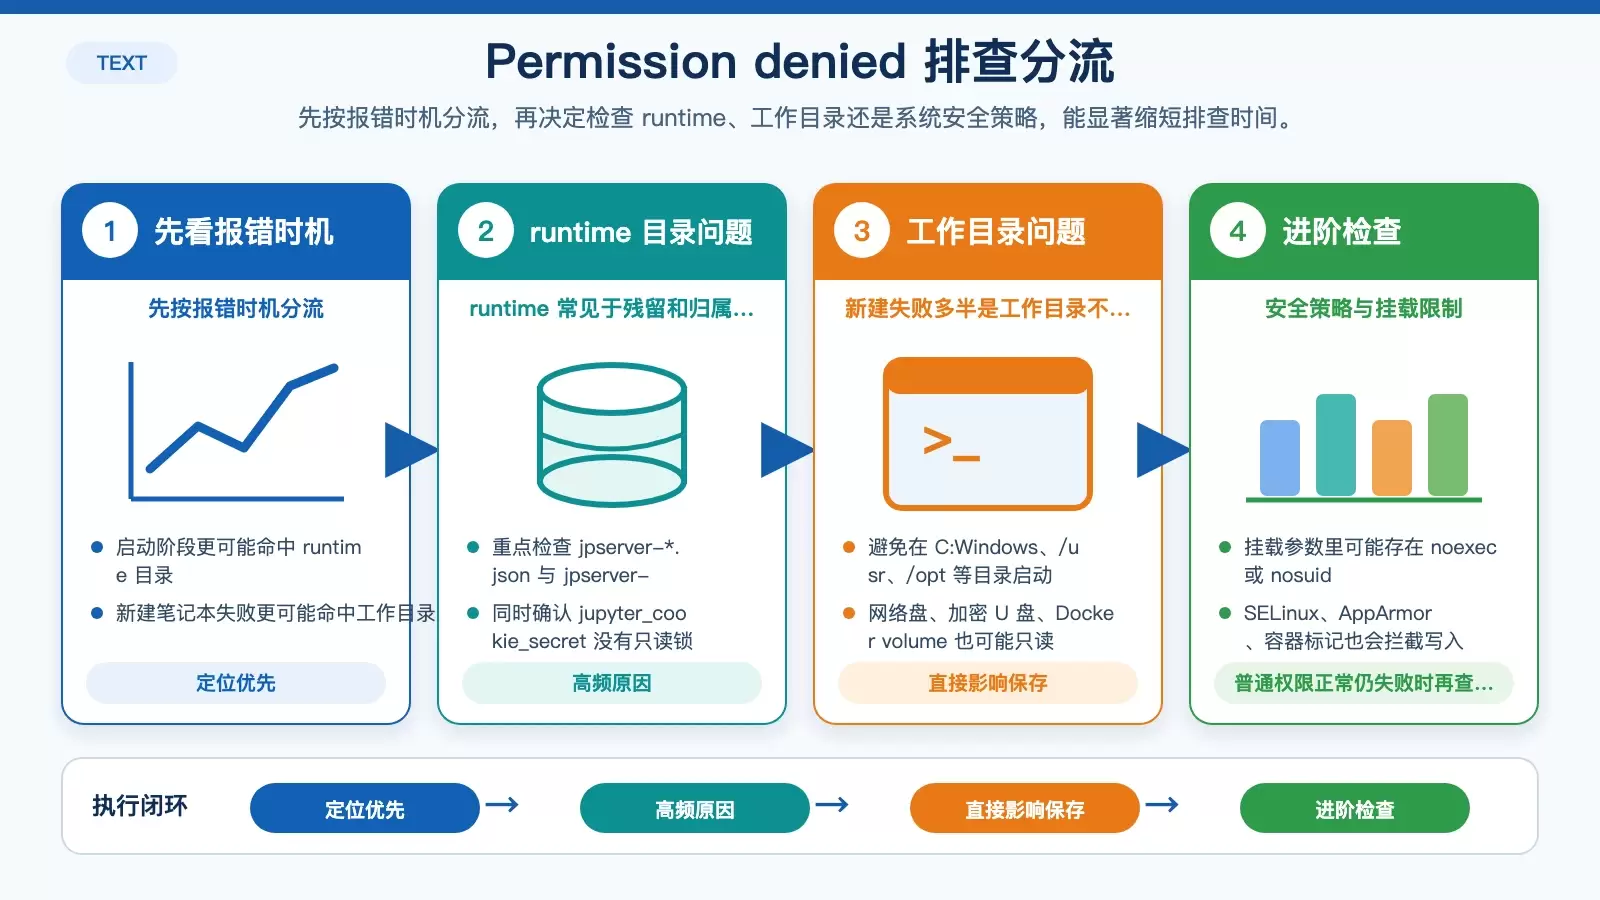
Jupyter Notebook 出现“Permission denied”通常不是程序损坏,而是运行时目录、工作目录或系统安全策略拦住了读写。本文按报错位置拆解排查路径,给出 Windows、Linux/macOS 下更稳妥的修复办法,并解释为什么一味 `chmod 777` 往往无效。 很多人遇到 Jupyter Notebook 的 Permission denied ,会先怀疑环境损坏,甚至直接重装,但这类报错大多与权限路径有关。