

Pandas数据缺失处理:NaN检测、过滤与填充实操
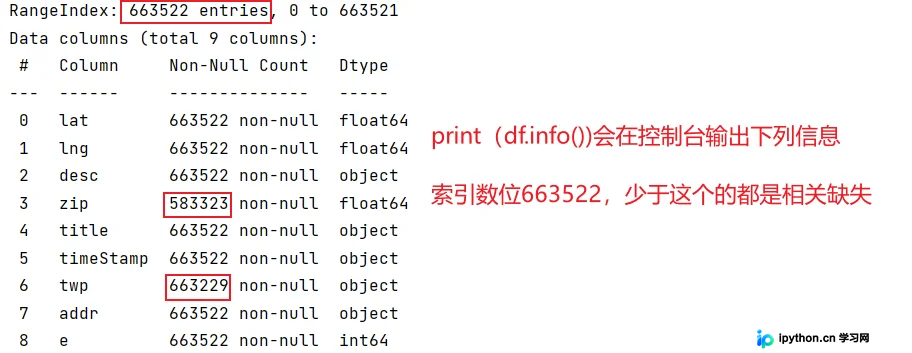
在数据分析实践中,缺失值常以 NaN 或误导性零值形式出现。本文梳理 Pandas 缺失数据检测机制,详细演示按列过滤、整行剔除及均值/中值填充的具体代码,并说明如何将无效零统一转码为 NaN,确保聚合运算不受干扰。
2026-10-11
6

在数据分析实践中,缺失值常以 NaN 或误导性零值形式出现。本文梳理 Pandas 缺失数据检测机制,详细演示按列过滤、整行剔除及均值/中值填充的具体代码,并说明如何将无效零统一转码为 NaN,确保聚合运算不受干扰。
深入解析Python中 a = value1 or value2 的底层运行机制。详细说明布尔上下文的真假值判定规则、逻辑运算符的短路求值特性,结合具体代码演示其作为变量默认值的实际应用方式,并补充常见误用场景的判断建议。
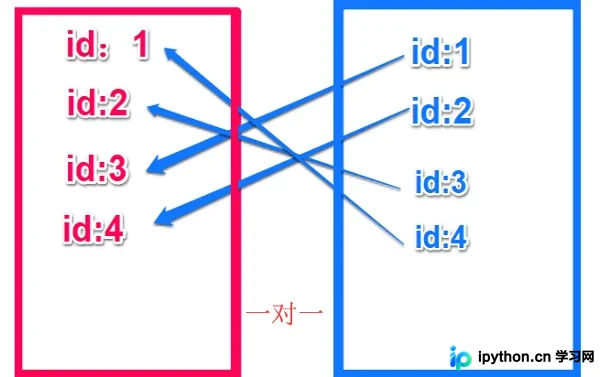
本文详解Django中数据库的三种核心关系:一对一、一对多与多对多。通过OneToOneField、ForeignKey及ManyToManyField定义模型,结合makemigrations与migrate命令完成表结构创建,并在views.py中演示数据的增删查改操作,帮助开发者掌握Django ORM的高级用法。
本文介绍在Python中逐帧读取多页TIFF文件的两种主流方案。通过安装tifffile或Pillow库,结合代码示例演示如何定位指定帧、转换为数组或图像对象,并对比两者在性能、输出格式及适用场景上的差异,帮助开发者根据项目需求快速完成图像序列处理。
本文详细梳理了Python语言中的内建函数与保留字。通过`keyword.kwlist`获取标准保留字列表,并按字母顺序整理了从A到Z的内建函数。重点标注了Python 2与Python 3之间的关键差异,如`execfile`、`xrange`的移除以及`nonlocal`、`ascii`的引入,帮助开发者快速查阅并避免兼容性问题。
本文详细介绍如何利用Python将PDF文档转换为可编辑的Word文件。通过对比pdf2docx、PyPDF2、PyMuPDF等主流工具特性,提供分步实操代码,涵盖基础安装、排版保真转换、纯文本提取及加密与扫描文件处理方案,帮助开发者高效解决文档格式转换与批量自动化需求。
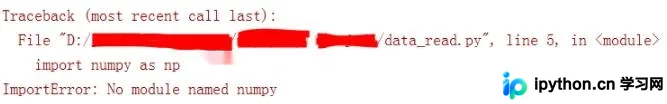
在PyCharm中运行Python代码时,即使模块在Jupyter Notebook中可用,仍可能遇到“ImportError: No module named”错误。这通常是因为PyCharm当前使用的Python解释器未安装该模块,或者电脑中存在多个Python版本导致环境不一致。本文详细介绍如何通过修改PyCharm的项目解释器来解决此问题,确保代码顺利运行。
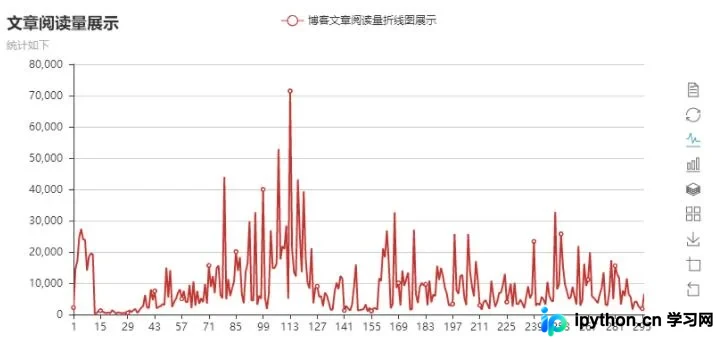
本文介绍如何使用Python读取Excel表格数据,并利用pyecharts库同时绘制折线图和柱状图。通过xlrd读取Excel列数据,结合numpy生成等间隔坐标轴,最终将图表保存为本地HTML文件,实现交互式数据可视化展示。
Python没有直接定义二维数组的语法,尝试使用a = [][]会引发SyntaxError。本文介绍利用列表解析(List Comprehension)高效创建二维数组的方法,通过合并for循环与创建代码,实现如3行4列且元素初始化为1的矩阵构建。

在Python多线程环境中,多个线程并发调用类方法并修改共享实例变量时,极易因非原子操作引发数据竞争,导致最终状态与预期不符。本文通过对比实验演示未加锁时的数值偏差,详细展示如何使用 threading.Lock 安全同步共享资源,并梳理锁的底层执行逻辑、性能权衡及典型死锁排查路径,协助开发者构建稳定可靠的多线程类应用。
Python GIL锁是CPython解释器的全局线程锁,因引用计数内存管理而产生。它导致多线程无法真正并行执行字节码。本文详解其运行机制,并提供多进程、C扩展库及异步编程等绕过策略,帮助开发者根据IO或CPU密集型场景选择最优并发方案。
本文深入解析Python多线程编程中锁的正确使用方式。通过对比传统acquire/release与上下文管理器with语句,阐述如何防止异常导致的锁未释放问题。重点讨论嵌套锁引发的死锁风险及分层锁定策略,并推荐利用queue模块实现任务间通信,从而构建更健壮的多线程应用。