Python目录下文件读取与批量处理方案
Python 处理本地数据时,常需自动获取目录文件列表以替代繁琐的手动筛选。本文基于标准库 os,详细演示如何精准提取单层目标文件、递归收集多级子目录内容,并结合实际业务流完成文件批量重命名。代码附带路径安全校验与异常处理机制,帮助开发者快速搭建稳定的自动化数据预处理管道。
2026-10-11
6

Python 处理本地数据时,常需自动获取目录文件列表以替代繁琐的手动筛选。本文基于标准库 os,详细演示如何精准提取单层目标文件、递归收集多级子目录内容,并结合实际业务流完成文件批量重命名。代码附带路径安全校验与异常处理机制,帮助开发者快速搭建稳定的自动化数据预处理管道。
functools.singledispatch 是 Python 提供的单分派工具,可将普通函数转换为基于首个参数类型自动路由的泛型函数。通过装饰器为不同数据类型注册独立处理器,替代冗长的条件分支,显著提升代码可读性与扩展性。本文详解其核心机制、标准配置步骤及多类型兼容实战,帮助开发者快速掌握类型分发模式。
本文系统梳理了Python中字符串与基础数据结构的常用操作。涵盖字符串翻转、回文判断、大小写转换、拆分合并,以及列表推导、元素频率统计、字典合并与唯一性检查等核心技巧。通过具体代码示例,帮助开发者快速掌握Python基础编程中的高频操作模式。
本文讲解如何利用Python切片作为占位符进行列表元素的插入与拼接。通过给切片赋值,可以在列表头部、尾部或任意中间位置高效插入新元素。需注意赋值对象必须是可迭代对象,且操作不会破坏原有元素结构。
本文详解Python SQLAlchemy的安装配置,并通过实例展示SQL工具包的表创建及ORM的类映射与数据操作,适用于初学者快速掌握数据库集成方法。
本文深入解析 Python 中 re.match() 函数的正则匹配机制,重点对比贪婪模式(.*)与懒惰模式(.*?)的行为差异。通过具体代码示例,展示如何控制捕获组提取内容,并探讨特殊字符在正则表达式中的实际作用与潜在报错原因。
本文介绍如何利用Python的tkinter库配合ttkbootstrap美化组件,快速构建一个具备基础四则运算与清除功能的桌面级计算器应用。通过定义窗口布局、绑定按钮事件与执行表达式计算,帮助初学者掌握Python GUI开发的核心流程与界面交互逻辑。
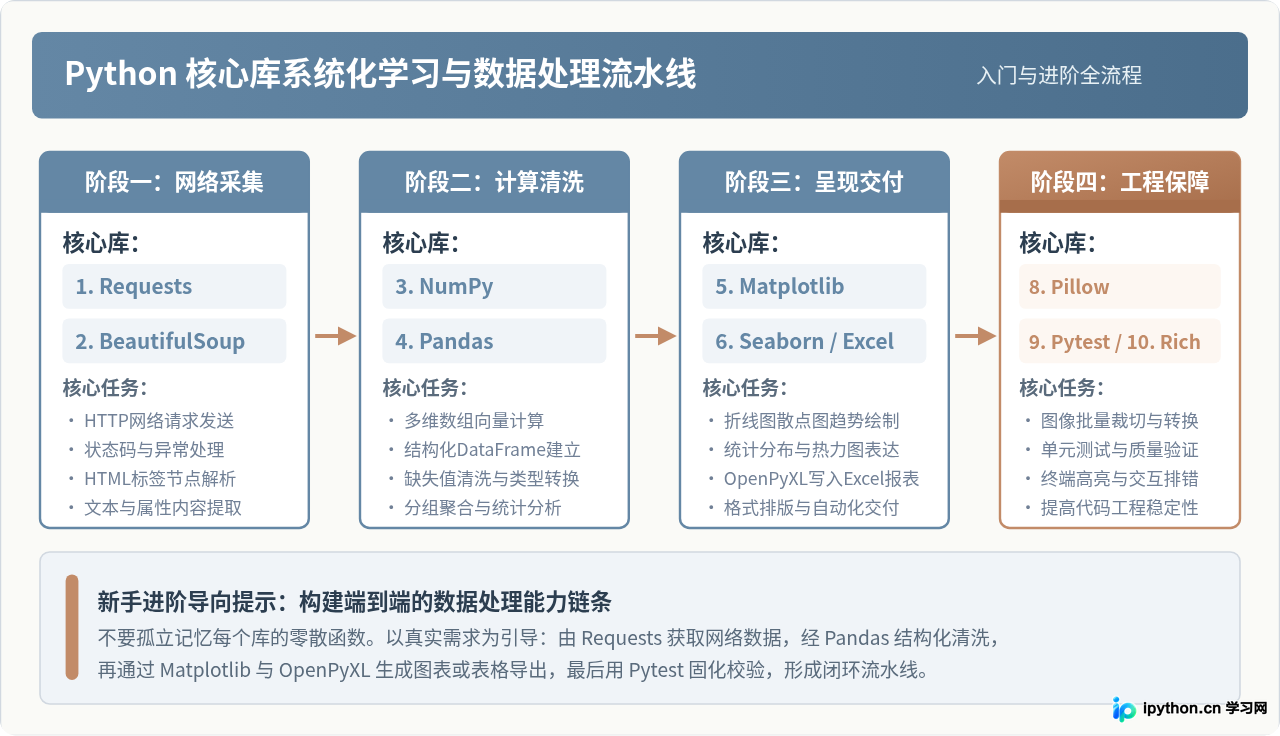
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
本文详解在Ubuntu系统中搭建Python开发环境的完整流程。通过终端命令更新系统源、验证及安装Python3与pip,并重点演示如何创建独立虚拟环境以隔离第三方依赖。同时涵盖代码编辑器配置方法及PATH环境变量核查步骤,帮助开发者在本地快速建立稳定可靠的运行环境。
本文介绍如何在Python3中处理JSON格式数据。通过json模块将JSON字符串解码为Python原生数据类型(如字典和列表),并演示如何访问嵌套结构中的元素。文章包含具体代码示例,展示如何格式化输出JSON数据以及如何遍历和提取嵌套数组中的信息。
本文介绍如何使用 Numba 库通过即时编译(JIT)技术显著提升 Python 代码的执行速度。重点讲解 @jit 装饰器的用法、nopython 模式的优势,以及针对 NumPy 数组和循环密集型计算的优化策略,帮助开发者在科学计算场景中实现接近 C 语言的运行效率。
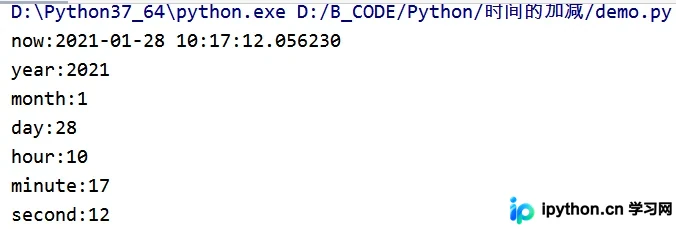
本文详细介绍Python中datetime模块的核心用法,涵盖获取当前时间各字段、datetime与字符串的双向转换(strftime与strptime),以及利用timedelta进行时间加减运算。通过具体代码示例,帮助开发者高效处理日常开发中的时间处理需求。