

使用Python快速打开一个百万行级别的超大Excel文件的方法
处理百万行级别的Excel文件时,常规方法往往耗时过长。本文通过对比pandas、xlrd和openpyxl模块的性能,发现开启openpyxl的只读模式可将打开20MB文件的时间从67秒缩短至0.4秒。文章提供了生成测试数据及读取大文件的完整Python代码示例,帮助开发者高效处理大规模表格数据。
2026-10-12
6

处理百万行级别的Excel文件时,常规方法往往耗时过长。本文通过对比pandas、xlrd和openpyxl模块的性能,发现开启openpyxl的只读模式可将打开20MB文件的时间从67秒缩短至0.4秒。文章提供了生成测试数据及读取大文件的完整Python代码示例,帮助开发者高效处理大规模表格数据。
在数据处理与爬虫开发中,经常需要从混合格式的URL里剥离出有效的主机域名。本文介绍两种主流方案:利用Python标准库urllib.parse快速提取网络位置,以及借助第三方tld模块自动识别顶级后缀获取注册域名。文章提供Python 3兼容代码、示例运行结果及异常排查指南,帮助开发者高效完成URL清洗工作。
本文详细讲解使用 Python 面向对象思想构建单链表的核心逻辑。通过封装独立的数据节点类与链表管理器,实现头插、定点插入、查找、替换与删除等操作。代码已修复原始版本中的参数笔误与指针跳转错误,并升级为 Python 3 标准语法,附带完整的运行验证流程,助您快速掌握基础数据结构搭建。
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作方法。涵盖基础属性获取(如 index、shape)、数据访问(loc、iloc)、多行多列切片、条件筛选、列的新增与删除,以及数据修改。通过具体代码示例,帮助开发者快速掌握 DataFrame 的高效数据处理技巧。
本文详解Python内置re模块的核心用法,对比match头部匹配与search全局查找的差异,演示逻辑或语法的实际场景。通过完整代码示例与执行结果对照,帮助开发者快速掌握文本提取与模式验证的操作流程。
本文详解 wxPython 的基础架构与主框架搭建流程。通过封装 wx.App 类实现应用初始化,结合 wx.Frame 构建独立窗口,并调用 MainLoop 启动事件循环。附完整可运行代码与效果对照,帮助快速掌握 Python 桌面图形界面程序的核心运行机制。
本文详细讲解如何使用 Python 标准库实现 HTTP 客户端的请求发送与服务端的响应接收。通过适配现代 Python 3 的内置模块,演示如何组装带自定义头的 POST 报文,重写处理器拦截路由并解析请求体,同时阐明 Content-Length 在防阻塞中的关键作用。
Python 在多重继承时通过方法解析顺序(MRO)确定属性查找路径。为解决早期深度优先搜索不满足局部优先级和单调性的问题,自 2.3 版本起全面启用 C3 算法。该算法通过计算基类 MRO 序列的头部元素,自动构建保证单调性的线性继承序列,有效避免方法冲突。
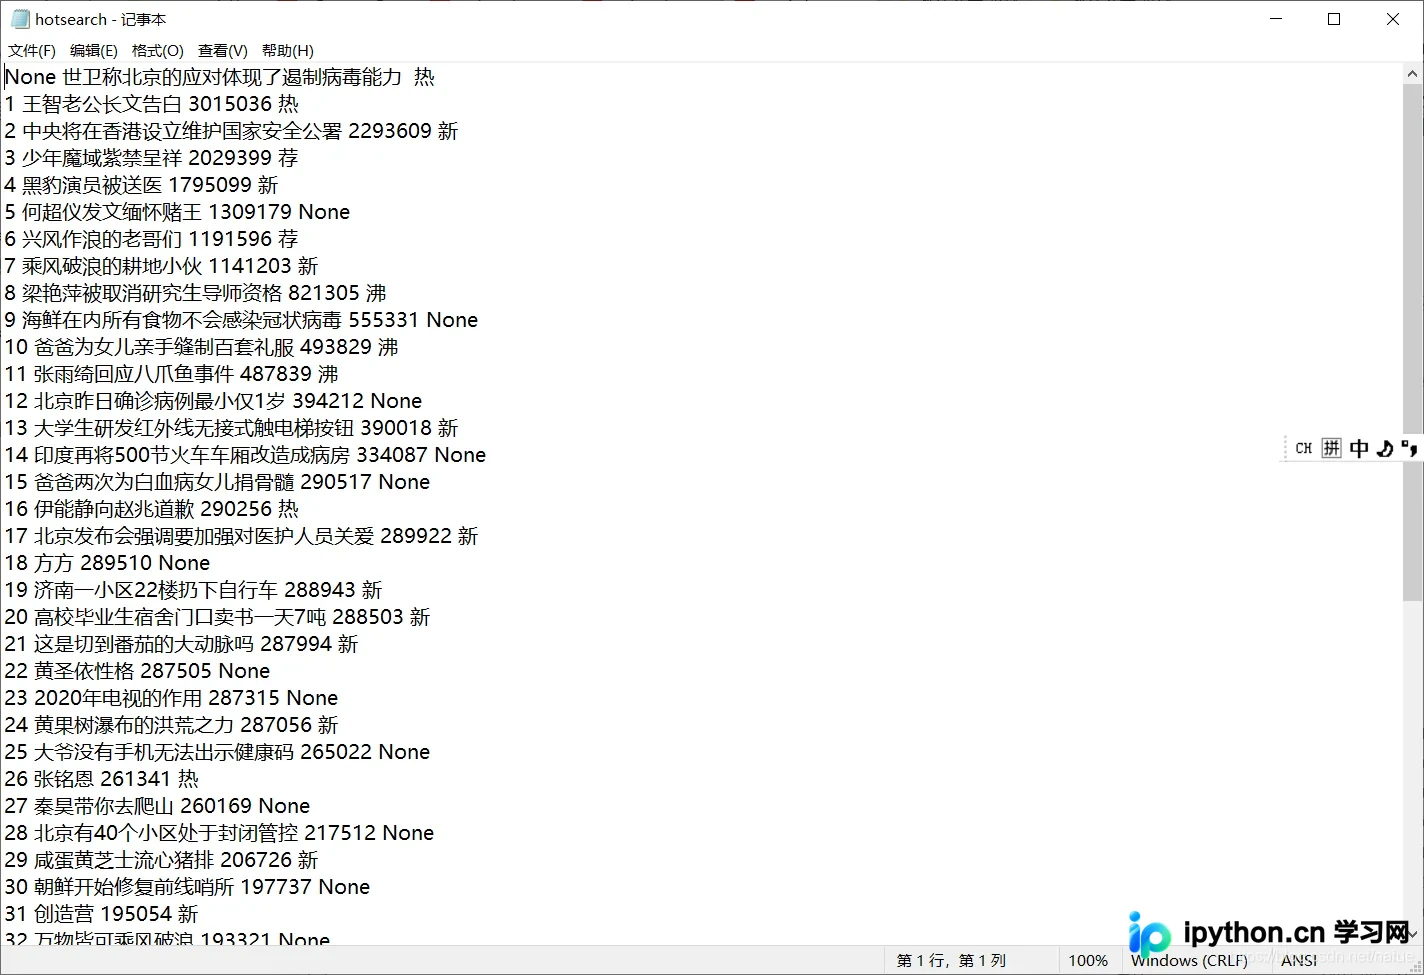
本文介绍如何使用Python爬取微博热搜数据并保存为文本文件。通过requests获取页面,利用BeautifulSoup解析HTML结构,提取热搜排名、标题及指数。此外,结合pandas和pyecharts库,对定时爬取的热搜数据进行可视化分析,生成动态时间轮播图,展示热搜趋势。
在Python自动化测试项目中,测试用例常按模块拆分至不同类中。借助unittest内置的TestSuite与TestLoader,可跨类批量加载用例并统一执行。本文提供完整代码示例,演示如何组合多组测试包、配置运行参数以及验证执行结果,帮助提升自动化测试管理效率。
在使用Python脚本读写MySQL数据库时,中文字符常因编码未对齐显示为乱码。本文通过统一数据库字符集、正确配置连接参数及移除废弃的系统编码覆盖命令,提供一套适用于Python 3的标准化排查与修复方案,确保数据交互稳定无误。
本文系统梳理 Python 常见语句类型,重点讲解赋值语句的多变量写入、序列解包机制与值交换技巧。通过一一对应原则演示列表、元组与字符串的解包用法,并说明数量不匹配时的 ValueError 报错原因及部分解包方案,助力开发者快速掌握核心赋值语法。