

Python+Selenium自动化实现分页(pagination)处理
本文介绍如何利用Python和Selenium库自动化处理网页分页功能。通过解析DOM元素,可获取分页总数、当前页码及翻页状态,并演示如何定位并点击指定页码链接实现页面跳转,适用于Web自动化测试与数据采集场景。
2026-10-13
7

本文介绍如何利用Python和Selenium库自动化处理网页分页功能。通过解析DOM元素,可获取分页总数、当前页码及翻页状态,并演示如何定位并点击指定页码链接实现页面跳转,适用于Web自动化测试与数据采集场景。
本文介绍在Python中如何获取文件名和文件路径。通过os模块的basename、dirname、realpath以及listdir和walk函数,可以分别提取URL或本地路径中的文件名与目录,列出指定目录内容,并递归遍历文件夹获取所有文件信息。
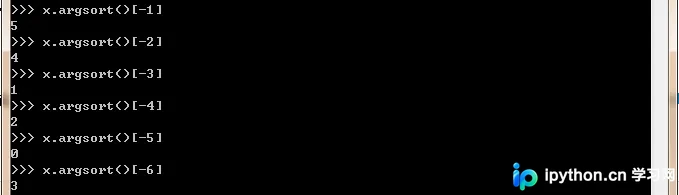
本文详细介绍Python中numpy库的argsort()函数,通过实例演示如何将数组元素从小到大排序并提取对应索引。重点解析利用负数索引(如[[wp:a2]])快速获取最大值或特定排名元素的方法,适用于批量数据处理及模型分类场景。
本文介绍使用Python遍历指定城市列表,通过API获取未来五天的天气预报数据,并将摄氏度转换为华氏度显示。代码包含详细注释,展示如何解析JSON数据及处理温度转换逻辑,便于开发者参考学习。
本文深入探讨Python网络编程中利用recv函数完整接收数据的三种核心方法。首先介绍基于连接断开的接收策略,适用于短连接场景;其次解析通过协议尾标识定位完整报文的方法;最后详解基于负载长度字段进行边接收边解析的技术。文章提供具体代码实现,帮助开发者解决TCP通信中的数据完整性问题。
本文详细介绍如何利用Python的xlwt和xlrd模块实现Excel文件的读写操作。通过pip安装所需模块后,演示了创建Workbook、添加Sheet、写入单元格数据及保存文件的全流程,并展示了如何打开xls文件、获取Sheet对象、遍历单元格值并打印内容。适用于Python 3.5.2及以上版本,帮助开发者快速掌握基础Excel处理技能。
本文详细介绍 Python Beautiful Soup 模块中 BeautifulSoup、Tag 和 NavigableString 三种核心对象的创建与使用方法。涵盖通过字符串或文件对象初始化 BeautifulSoup,指定 features 参数选择解析器(如 lxml、html5lib)的技巧,以及获取和修改 Tag 名称、属性及文本内容的实际操作。
本文详解在Django项目中,如何将settings.py中定义的自定义变量(如网站名称、描述)全局化,以便在HTML模板中直接通过键名访问。核心步骤包括:在settings.py定义变量,在views.py创建接收request参数的上下文函数,并将该函数注册到TEMPLATES配置的OPTIONS中。注意函数必须包含request参数,否则会导致错误。

本文详解在Python环境中如何利用M2Crypto库实现RSA公钥加密与私钥解密。通过读取rsa_pub.pem和rsa_private.pem文件,分别演示了使用公钥对明文数据进行加密,以及使用私钥对密文进行解密的具体步骤与代码实现,涵盖MemoryBuffer加载及PKCS1填充模式的应用。
本文深入解析Python中is与==的区别。is比较内存地址,用于判断是否为同一对象;==比较值,通过__eq__方法实现。通过代码示例说明两者在不同场景下的表现,帮助开发者准确选择比较方式。
本文深入解析Python APScheduler库的两种核心调度模式:阻塞式(BlockingScheduler)与非阻塞式(BackgroundScheduler)。通过具体代码示例,详细演示了如何配置interval、date及cron三种触发器,涵盖单次执行、固定间隔及复杂Cron规则的实现方法,帮助开发者根据应用场景选择合适线程模型。
本文深入探讨Python中并发获取SNMP信息的两种主流方案:基于C接口的netsnmp与纯Python实现的pysnmp。通过对比多线程与异步机制,分析其在处理198个Host及不同OID数量下的采集耗时。测试结果显示,netsnmp在多线程模式下效率显著优于pysnmp,且原生支持walk操作,本文推荐在实际高并发场景中优先选用netsnmp。