

Python Scrapy实战:京东商城数据爬取进阶教程
本文深入讲解使用Python Scrapy框架爬取京东商城的进阶技巧。内容涵盖构造奇数页请求、解析首屏数据、处理Ajax异步加载的后半部分商品信息,以及通过Meta传递参数。同时提供断点续爬、下载延迟、随机延迟、忽略Robots协议及并发控制等settings.py配置技巧,帮助开发者高效获取商品详情并避免被封禁。
2026-10-13
9

本文深入讲解使用Python Scrapy框架爬取京东商城的进阶技巧。内容涵盖构造奇数页请求、解析首屏数据、处理Ajax异步加载的后半部分商品信息,以及通过Meta传递参数。同时提供断点续爬、下载延迟、随机延迟、忽略Robots协议及并发控制等settings.py配置技巧,帮助开发者高效获取商品详情并避免被封禁。
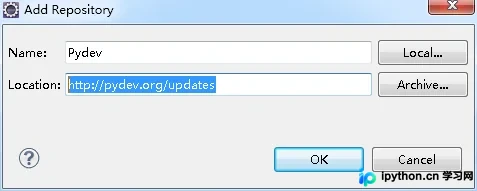
本文详细介绍在Windows系统中为Eclipse集成开发环境安装Python插件PyDev的完整流程。内容涵盖Python环境准备、通过在线更新站点安装PyDev、配置Python解释器路径以及创建首个PyDev项目。步骤清晰,旨在帮助用户快速在Eclipse中开启Python开发工作。
本文深入解析Python类中的特殊成员方法,涵盖__call__实现对象可调用的机制,__getitem__、__setitem__和__delitem__支持字典式访问及切片处理,__dict__用于获取类与对象成员字典,以及__iter__配合yield实现可迭代对象。通过具体代码示例,展示这些魔术方法在Python编程中的实际应用与行为逻辑。
本文介绍如何在Python中使用matplotlib库生成背景透明且图例透明的图片。通过设置savefig参数及图例框架属性,可实现背景与图例区域的透明效果,适用于需要叠加显示或去除白边的场景。
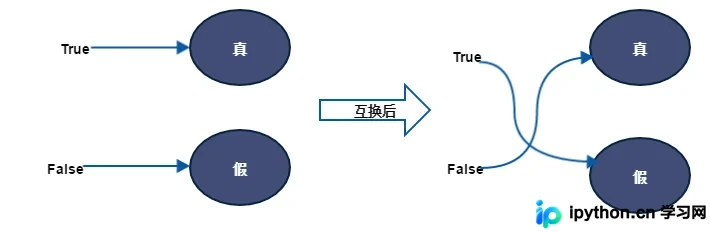
本文深入解析Python中True和False的本质。在Python2.x中,它们是可重新赋值的内置变量,导致逻辑混乱;Python3将其升级为关键字以禁止修改。文章通过代码示例展示互换操作的影响,并建议使用keyword模块验证其状态,帮助开发者避开版本差异带来的陷阱。
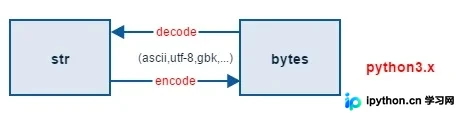
本文深入解析Python3如何解决Python2遗留的字符编码问题。通过对比Python2中ASCII默认编码及str/unicode混淆的缺陷,阐述Python3将默认编码设为UTF-8,并清晰区分str(文本)与bytes(二进制)类型。文章详细说明了bytes类型的定义、操作限制及与str的转换方法,包括encode和decode的具体应用,帮助开发者避免编码错误。
本文详细介绍如何使用Scrapy框架在PyCharm环境中编写一个仅需21行代码的Python爬虫。通过解析HTML结构定义Item,创建Spider类处理页面数据,并配置Settings以UTF-8编码输出JSON文件。文章还涵盖了运行命令、已知追加数据Bug及定时任务等扩展功能建议,适合初学者快速上手Scrapy基础应用。
本文介绍使用Python正则表达式从网页中提取新闻标题及链接的具体实现方法。通过urllib获取页面内容,利用正则匹配特定HTML结构,并对提取结果进行字符串替换处理,最终将标题和链接保存至本地文件。
本文深入解析Python中with关键字的工作原理,阐述其作为try/finally替代方案在资源管理中的优势。通过对比普通、进阶及高级写法,详解__enter__和__exit__方法的实现机制,并介绍利用contextmanager装饰器简化上下文管理器构建的技巧,帮助开发者写出更优雅、安全的代码。
本文详细介绍Python中datetime模块的五大核心类:date、datetime、time、timedelta及tzinfo。涵盖日期对象的创建、常用方法如ctime、fromtimestamp、strftime等,以及时间格式化符号的详细列表。同时讲解如何利用timedelta类计算两个日期之间的天数差与秒数,并提供实际代码示例,帮助开发者高效处理时间相关操作。
本文详细解析Python中元组(Tuple)与字典(Dict)的核心特性。重点阐述元组元素指向内存地址不变的“不可变”本质,以及字典作为映射类型对键不可变性的要求。文章涵盖字典的多种创建方式、生成式用法及get、pop、update等常用内置方法,帮助开发者掌握高效的数据处理技巧。
本文介绍如何使用Python的python-docx库,自动遍历指定目录下的特定后缀代码文件(如.cs),并将读取到的代码内容整理保存为Word文档。脚本支持处理中文编码,通过打印日志监控文件处理状态,确保生成包含标题、代码块及总行数的完整文档,适用于快速整理项目代码以申请专利或归档。