

Python实现中英文文本分离的两种实用方法
本文介绍在Python中分离中英文文本的两种常用方法。针对超短文本,可通过ASCII码值直接过滤;对于复杂混合文本,利用Unicode编码范围\u4e00-\u9fa5及正则表达式匹配英文字符与空格,实现精准提取。
2026-10-13
9

本文介绍在Python中分离中英文文本的两种常用方法。针对超短文本,可通过ASCII码值直接过滤;对于复杂混合文本,利用Unicode编码范围\u4e00-\u9fa5及正则表达式匹配英文字符与空格,实现精准提取。
Python3 默认使用 Unicode 编码,不再提供 sys.setdefaultencoding 方法。处理中文乱码时,应在输出序列化阶段通过 str.encode('GBK') 将字符串转换为本地编码字节串,从而实现与外部环境的兼容交互。
本文介绍在Python中创建文件时,如何处理Windows系统禁止的文件名字符。通过正则表达式re.sub方法,将反斜杠、冒号、星号等非法字符替换为合法字符,确保文件成功创建。
本文详细介绍Python中列表的基本定义与类型判断,系统讲解append、count、extend、index、insert、pop、remove、reverse、sort及len等常用函数的用法。通过代码示例演示列表的增删改查、排序去重及类型限制,帮助初学者快速掌握列表核心操作。
本文针对Python中使用f.write写入中文时出现的编码错误问题,提供了两种有效的解决方案。主要原因为默认编码方式不匹配,建议显式指定UTF-8编码进行写入,或通过修改系统默认编码来解决,确保中文内容能正确保存至文件。
本文详细介绍如何在Python中将包含大量浮点数的TXT文件数据读取并转换为NumPy数组。通过示例代码展示如何逐行处理文本、去除换行符、按逗号分割数据,并利用numpy的array和c_函数构建二维数组,最终实现125行45列数据的精确加载与输出。
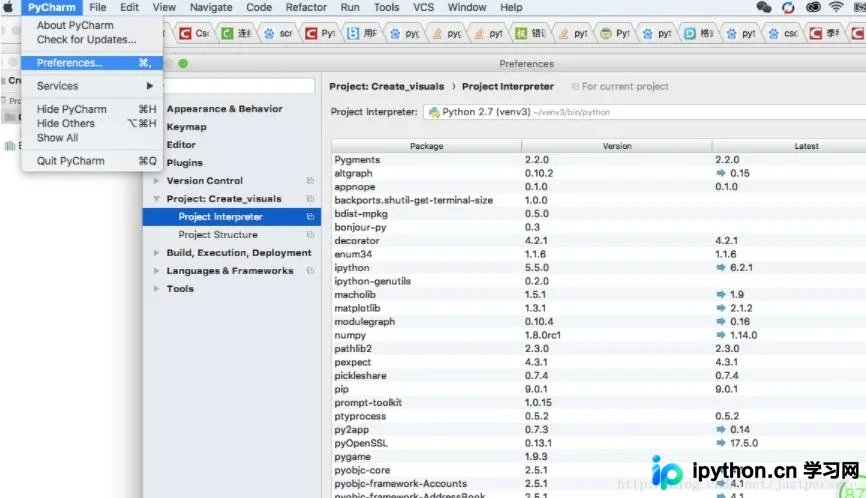
本文介绍在PyCharm中切换Python解释器时容易遇到的配置路径误区。指出应在Preferences中进行操作,而在File Setting中切换可能导致失败。通过明确正确的设置入口,帮助用户顺利解决解释器切换问题,确保开发环境配置准确无误。
本文介绍在Python中利用Numpy库高效处理CSV文件及矩阵数据的方法。通过numpy.matrix和numpy.load/dump实现矩阵数据的序列化存储,结合numpy.loadtxt与savetxt完成CSV文件的读取与写入。代码示例展示了如何将矩阵整体保存为.dat文件,以及如何读写标准CSV格式,适用于需要快速数据持久化的场景。
本文介绍如何在 pandas 中创建一个空的 DataFrame 并预先定义列名。通过构建包含基础字段、动态列表及特定标识的列名数组,并将其传递给 DataFrame 构造函数,即可实现快速初始化。该方法适用于需要预设数据结构后续填充数据的场景。
本文介绍在Python中查找列表最大或最小几个数索引的方法。通过对比heapq.nlargest和手动遍历两种实现,指出当列表存在重复元素时,heapq.nlargest结合nums.index会错误地返回相同数字的第一次出现索引,而手动方法能正确区分不同位置的元素。
本文介绍如何在Django Admin中通过django-guardian实现细粒度的行级权限控制。针对内置权限无法覆盖数据行级别的痛点,通过继承GuardedModelAdmin并重写has_module_permission、get_queryset等关键方法,解决新用户无访问权限的问题。文章提供了完整的代码修改示例及配置步骤,帮助开发者高效构建安全的管理后台。
本文解析Python中None与空值的区别,并提供判断参数是否为None或空的代码示例。通过if-elif-else结构演示如何区分NoneType与空字符串,帮助开发者避免常见错误。