Python读取TXT文件并去除空格计算每行长度的方法
本文介绍如何使用Python读取TXT文件,并通过split()方法去除每行空格后计算实际字符长度。提供了完整的代码示例,展示如何打开文件、逐行读取、处理字符串及计算长度,最后关闭文件。适合需要处理文本数据的开发者参考。
2026-10-13
7

本文介绍如何使用Python读取TXT文件,并通过split()方法去除每行空格后计算实际字符长度。提供了完整的代码示例,展示如何打开文件、逐行读取、处理字符串及计算长度,最后关闭文件。适合需要处理文本数据的开发者参考。
本文介绍在 Python 中判断数字奇偶性的基本方法。通过取模运算符 % 计算除以 2 的余数,若余数为 0 则为偶数,否则为奇数。文章提供了标准实现及内嵌 if 语句的示例,并展示了具体的代码执行结果,帮助初学者快速掌握这一基础逻辑。
本文介绍如何在Python中处理包含多个不同分隔符的字符串。默认split()仅支持单一分隔符,通过引入re模块并使用正则表达式字符集,可一次性指定多个分隔符进行分割,适用于日志解析等场景。
本文详细总结了使用Python进行MySQL数据库操作的核心方法,涵盖连接建立、SQL执行、数据获取及更新删除等基础功能。通过银行转账实例演示了完整的事务控制流程,包括数据校验、金额扣减与追加,并重点展示了异常发生时的回滚机制,确保数据一致性。
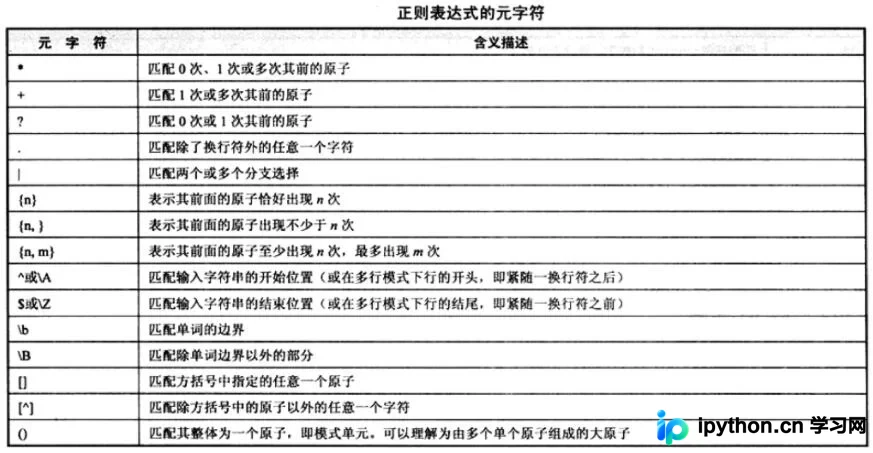
本文详细介绍Django框架中基于正则表达式的URL分发机制。重点解析URL模式定义时省略前导斜杠的规范,以及使用Python原始字符串(raw string)处理反斜杠转义冲突的重要性。通过官方示例代码,展示如何正确配置年份、月份及文章详情的URL路由规则,帮助开发者避免常见的语法错误。
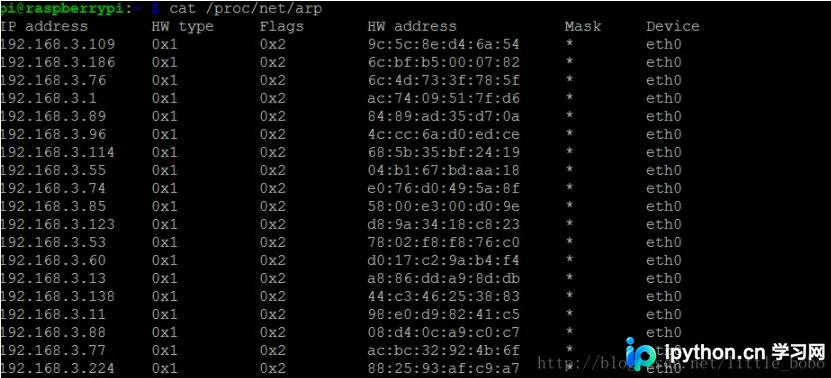
本文介绍在Python中利用正则表达式实现按多个空格分割字符串的方法。通过re.split函数配合特定模式,可有效处理包含连续空格的文本数据,并展示了从原始数据到处理结果的完整流程及代码示例。
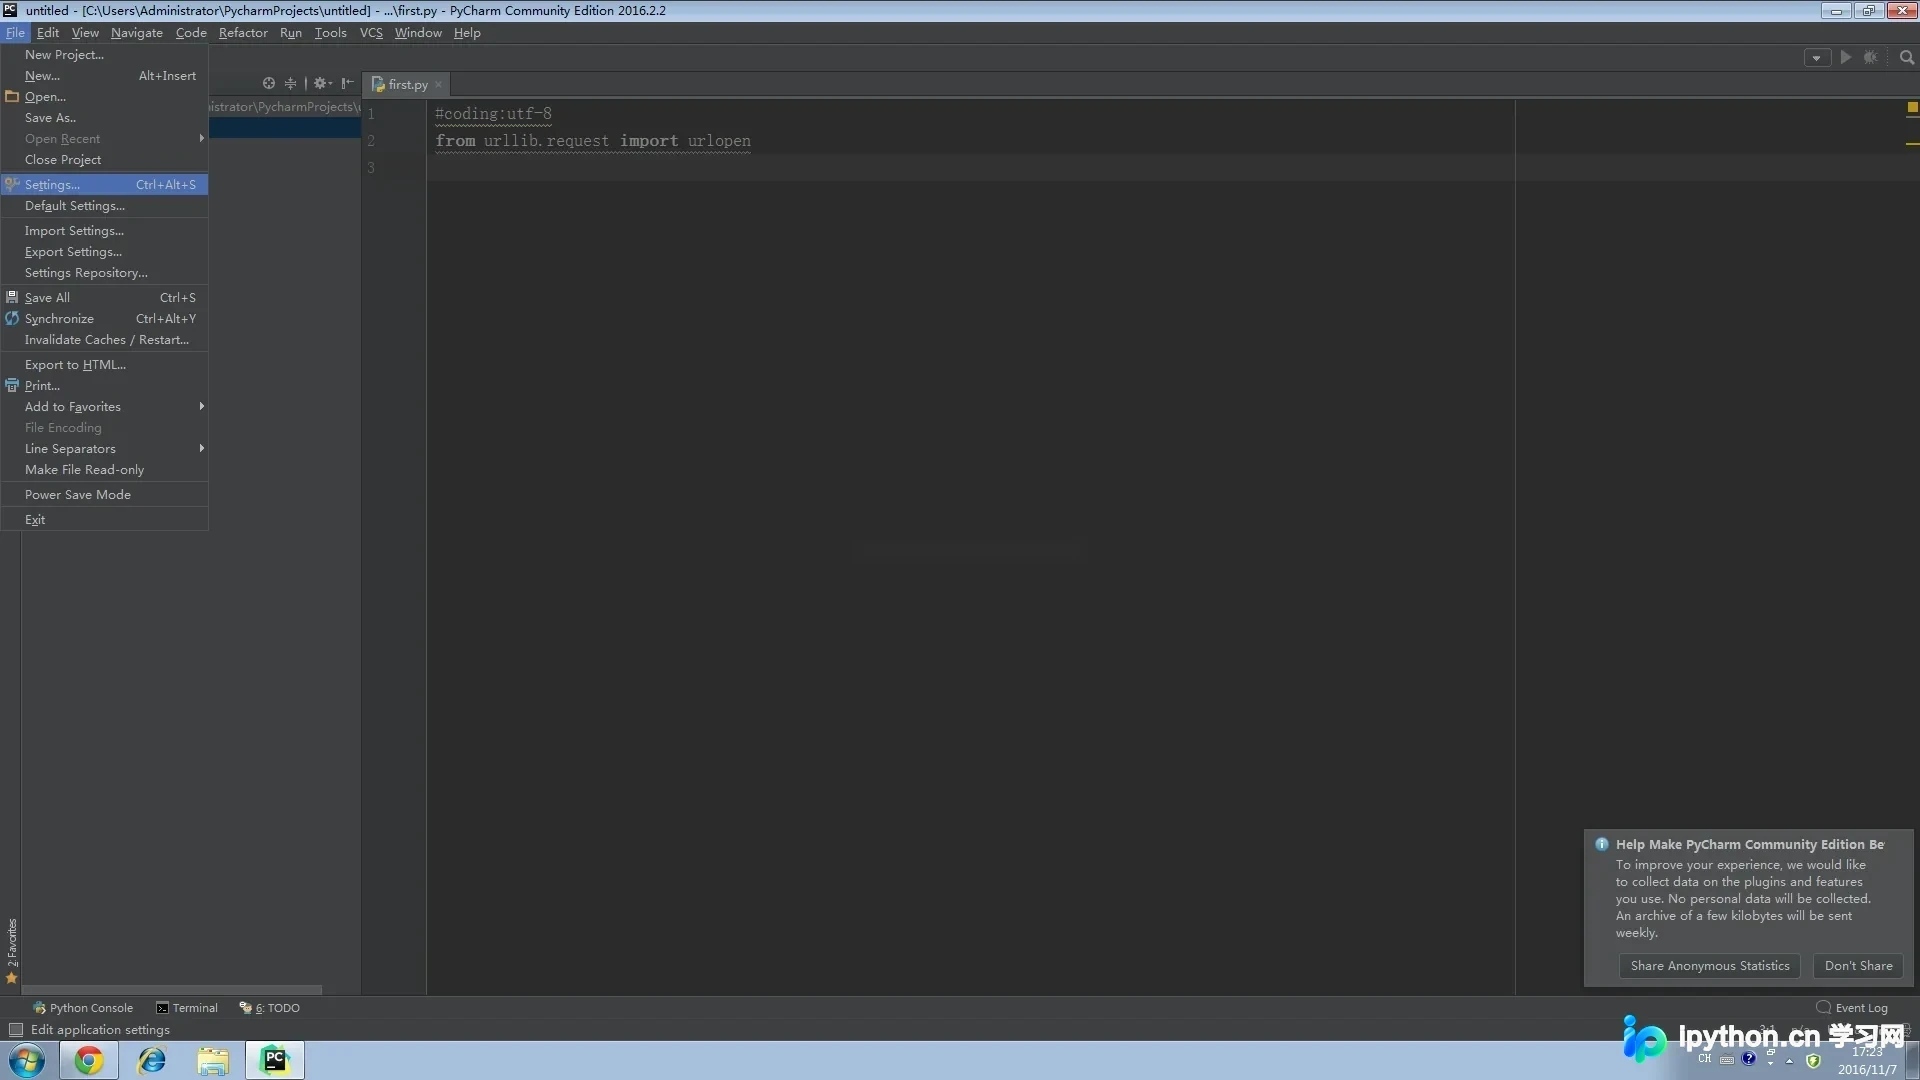
本文详细介绍Python中BeautifulSoup库的安装方法及基础使用。通过PyCharm自动安装bs4库,并演示如何将HTML源码转换为BeautifulSoup对象。文章解析了HTML标签的层级结构,讲解如何提取title等节点信息,并对比多种属性访问方式,帮助初学者快速掌握网页数据抓取的核心技巧。
本文分析Python中使用正则表达式匹配网页图片URL时,因HTML源码包含换行符导致匹配失败的问题。通过对比单行与多行字符串匹配结果,指出默认模式下'.'不匹配换行符。解决方案为在re.compile中传入re.S标志,使点号匹配所有字符包括换行符,从而完美提取跨行显示的图片地址。
本文探讨Python网页采集中正则表达式匹配换行符的问题。默认情况下,正则中的点号(.)无法匹配换行符,导致数据采集失败。通过示例展示使用[\s\S]组合可匹配包括换行在内的任意字符,并简要介绍\s与\S的定义,帮助开发者解决HTML解析中的换行匹配难题。
本文详解如何使用Python的requests库发送JSON格式数据。通过修改headers中的Content-Type为application/json,并利用json.dumps()将字典转换为JSON字符串,即可正确发送POST请求,适用于爬虫及接口测试场景。
本文深入解析Python中几种通用循环构造方法,包括允许用户交互的无限循环、通过特定数据终止的哨兵循环,以及基于文件行的读取模式。文章详细说明了哨兵值的设定原则、eval()函数的应用及readline()在文件处理中的关键作用,并指出处理含换行符的空行时需注意的细节,旨在帮助开发者掌握不同场景下的循环控制技巧。
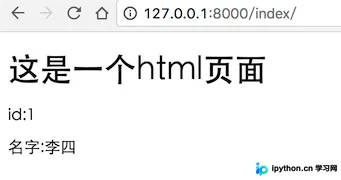
本文详解Django框架中HTML模板如何解析变量及视图层如何向模板传递数据。通过展示包含{{变量名}}占位符的HTML模板,以及使用render_to_response函数传递字典数据的Python视图代码,演示了同名键值覆盖规则及最终渲染效果,为基于Django的Python程序设计提供具体参考。