

Scrapy框架爬取西刺代理网免费高匿代理的实现代码
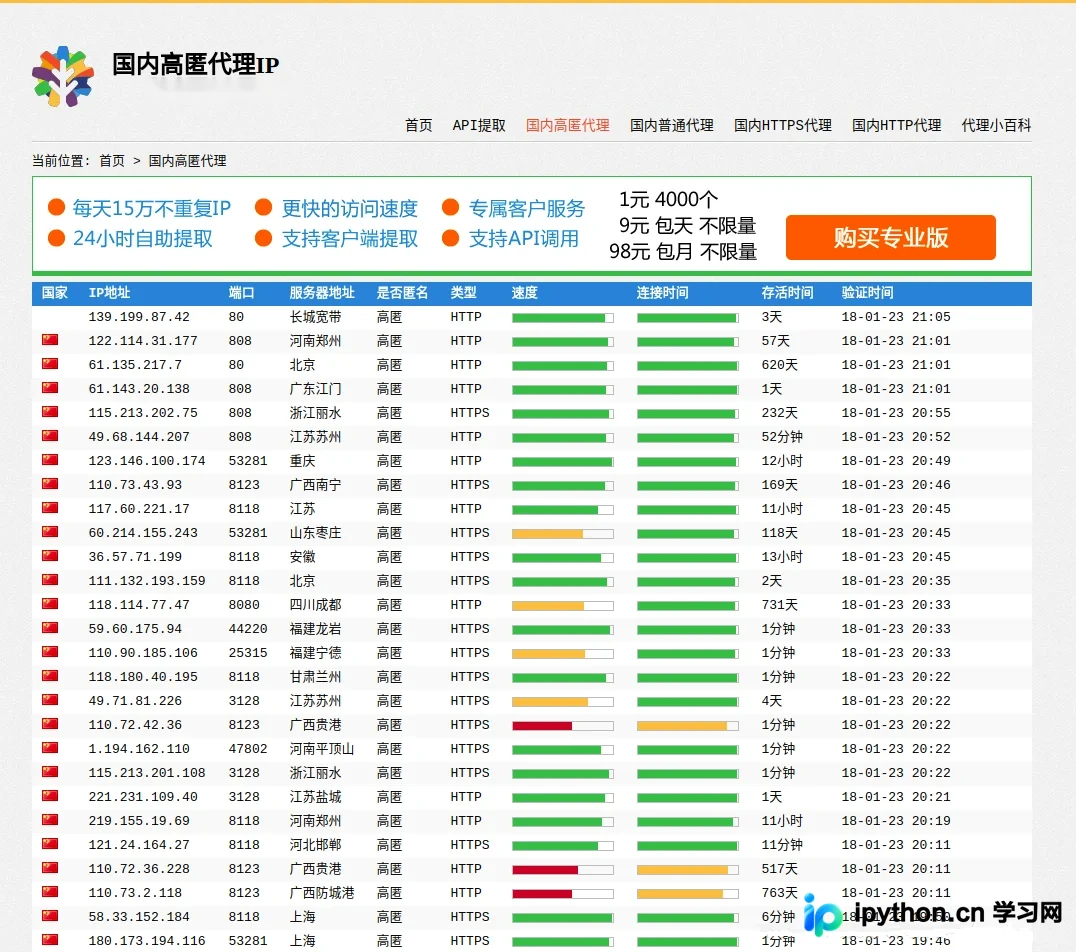
本文详细介绍如何使用Scrapy框架爬取西刺代理网的免费高匿IP数据,并将结果保存至MySQL数据库。教程涵盖项目创建、Item定义、Spider编写、Pipeline配置及Settings设置等完整步骤,代码示例仅展示前10页数据抓取逻辑,适合Python初学者参考学习。
2026-10-13
10

本文详细介绍如何使用Scrapy框架爬取西刺代理网的免费高匿IP数据,并将结果保存至MySQL数据库。教程涵盖项目创建、Item定义、Spider编写、Pipeline配置及Settings设置等完整步骤,代码示例仅展示前10页数据抓取逻辑,适合Python初学者参考学习。
本文介绍 Python 3.6 环境下运行 tkinter 时可能遇到的 ModuleNotFoundError 错误,特别是关于 'tkinter.ttk' 模块无法识别的问题。通过指定以 Python unit-test 模式运行,可有效解决该报错,确保 tkinter 相关功能正常加载。
本文介绍如何利用Python自动获取本机IP及地理位置,结合百度语音API将天气文本转换为MP3并播放。通过get_ip、get_weather、get_mp3和main四个模块实现从定位到语音播报的全自动流程,解决手动查询的繁琐问题。
本文详细解析Python中实现多进程的四种核心方式:利用os.fork()创建子进程、通过multiprocessing模块直接实例化Process、继承Process类重写run方法,以及使用进程池Pool进行任务管理。文章涵盖各方法的代码示例、适用场景及注意事项,帮助开发者根据实际需求选择高效的并发编程方案。
本文介绍如何在 Python 中使用 threading.Semaphore 来限制同时运行的最大线程数量。通过示例代码展示如何初始化信号量并在线程函数中使用 with 语句进行资源锁定,从而有效控制并发度,避免系统资源过载。
本文介绍如何在Python中通过Queue实现自定义线程池以控制并发线程数量,并结合signal模块监听SIGTERM信号实现优雅退出。通过示例代码展示线程生命周期管理与信号处理机制,帮助开发者掌握Python多线程的高级应用技巧。
本文介绍在Python中通过回调函数获取返回值的方法。核心思路是将回调函数赋值给变量,回调执行完毕后从该变量中提取结果。文章结合XMLReader实例,展示了如何在处理XML解析时获取对象内的数据,为需要处理回调返回值的场景提供实用参考。
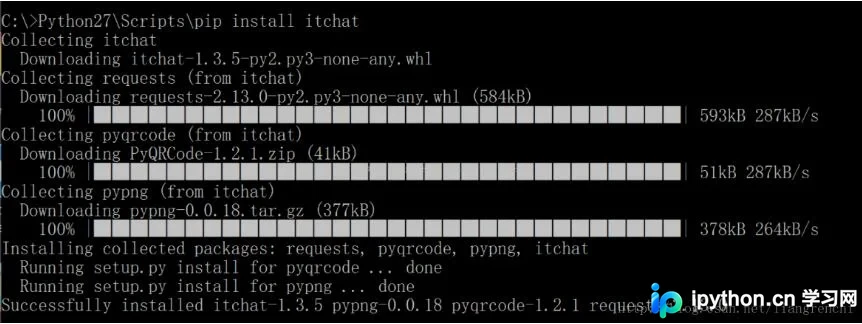
本文介绍如何利用Python的itchat库实现向微信群自动发送消息的功能。通过安装itchat并调用auto_login进行热登录,获取群聊对象后使用send方法指定接收者发送内容。文章提供了完整的代码示例及运行效果,适用于简单的群发自动化场景,旨在分享技术实现细节。
本文提供了一段使用Python编写的批量注册网站用户的示例代码。脚本通过随机生成用户名、密码及QQ邮箱,利用urllib库构造HTTP请求向指定URL提交注册数据,并解析返回结果判断注册是否成功。代码包含循环控制、文件写入及延时处理,旨在展示基础的网络请求自动化流程。
本文介绍如何利用Python标准库中的webbrowser和time模块,编写简短脚本实现定时自动打开指定URL的功能。通过获取当前时间并设置休眠时长,程序可在指定时间后自动启动默认浏览器访问目标网页,适用于需要定期访问特定页面的场景。
本文介绍如何使用Python库wxpy实现微信消息防撤回功能。通过监听消息状态码识别撤回行为,并重新发送原始内容。支持文本、图片、语音等多种消息类型,并提供了集成图灵机器人的示例代码,帮助开发者快速掌握微信自动化开发技巧。
本文介绍Python中fake-useragent库的安装与使用方法,展示如何随机生成各类浏览器UserAgent以辅助爬虫开发。重点解析缓存异常FakeUserAgentError的解决方案,包括禁用服务器缓存及添加本地数据文件的高级配置,帮助开发者规避网络请求失败问题。