

Python中使用Numpy计算两个向量的平均值
本文介绍如何使用Python的Numpy库计算两个数组的平均值。通过示例展示了数组相加后除以2的操作,生成包含浮点数的平均向量,适用于基础数据处理场景。
2026-10-13
11

本文介绍如何使用Python的Numpy库计算两个数组的平均值。通过示例展示了数组相加后除以2的操作,生成包含浮点数的平均向量,适用于基础数据处理场景。
本文详解如何在 Python Pandas 中高效获取满足特定条件的行索引。对比了低效的迭代方式,重点介绍了使用布尔索引直接获取 index 列表的方法,并深入解析了 iloc(位置索引)与 loc(标签索引)的区别。同时提供了利用 np.flatnonzero 获取序数索引的技巧,帮助开发者避免常见的索引混淆错误。
本文介绍如何利用Python将MySQL数据库中的数据转换为JSON格式,以简化第三方推送平台的数据录入工作。通过实例代码展示连接数据库、查询数据、处理字典结构及生成JSON文件的全过程,帮助开发者高效完成数据格式转换任务。
本文详细解析Python中获取WebSocket实时数据的四种常见链接方式。通过对比create_connection、ws4py客户端、原生WebSocket模块以及WebSocketApp类,分析各方案在连接稳定性、耗时及代码复杂度上的差异。文章提供了完整的代码示例,帮助开发者根据实际需求选择最合适的实现方案,并指出各方法的潜在优缺点。
本文介绍在Python中遍历列表时获取元素下标的两种常见方式。通过range(len())手动计算索引是基础方法,而使用内置enumerate函数则是更地道、高效的Pythonic写法。文章还解析了enumerate的start参数用法,并指出了随意命名变量及不必要的list转换等常见代码瑕疵,帮助开发者写出更规范的Python代码。
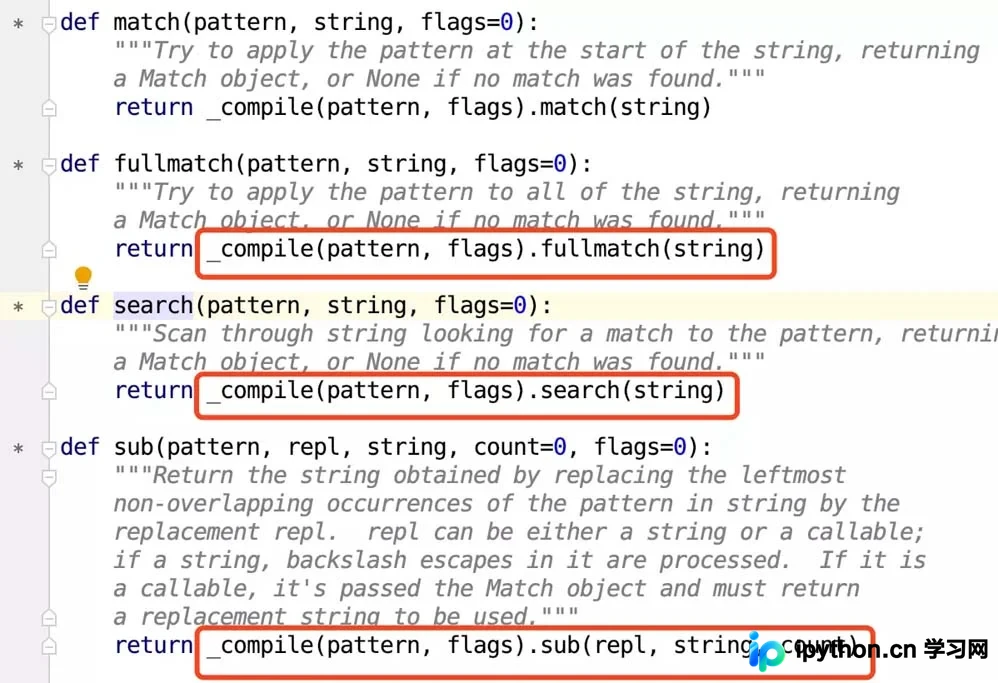
本文通过Python源码深入解析,指出re模块中的search、findall等方法内部已自动调用_compile并具备缓存机制。手动调用re.compile不仅多余,且源自其他语言的不良习惯。文章澄清了关于百万级数据匹配的性能误区,建议开发者直接使用内置方法以获得更简洁高效的代码。
本文详细解析Python中实现单例模式的三种主要方法:通过装饰器缓存实例、重写基类__new__方法以及利用元类控制类创建。每种方式均附有代码示例,帮助开发者理解不同场景下的最佳实践与实现细节。
本文介绍如何在Python中计算数据的偏度和峰度。通过结合NumPy进行基础统计量(均值、标准差)的计算,并利用SciPy库的stats模块获取偏度和峰度指标,帮助开发者理解数据分布的不均衡性及峰值特征。
本文详细介绍基于Python的Jacobi迭代算法,用于求解形式为Ax^(m-1)=b的非线性张量方程。内容涵盖对称张量S与对角占优张量A的生成逻辑、向量b的构造方法,以及完整的迭代求解代码。通过设定精度Delta、阶数m和维数n,演示了算法在指定最大迭代步数M内的收敛过程与性能评估。
本文介绍如何使用Python的Pandas库生成指定范围内的日期列表。通过pd.date_range函数,可以灵活设置起始与结束日期,并自定义频率参数(如天、月等)。示例展示了如何将日期对象转换为字符串格式,适用于数据分析和时间序列处理场景。
本文介绍如何在Python中计算平均平方误差(MSE),即数据点到拟合直线Y方向距离平方的平均值。首先展示基于循环的基础实现方法,随后通过zip函数优化代码,使实现更加简洁高效。
本文深入解析Python与Matlab在科学计算领域的核心差异。Python凭借免费开源、丰富的第三方库及通用编程能力,在Web开发、爬虫及大规模生态中占据优势;Matlab则凭借Simulink、详细的文档及垂直领域的深度集成,在特定科研与数值计算场景中保持竞争力。文章提供了基于策略研究、数据分析及IT开发等不同需求的具体选型建议,帮助开发者做出最优技术决策。