

Python基于Mitmproxy实现被动式浏览器请求抓取与解析
本文介绍如何利用Python结合Mitmproxy库构建被动式代理,以捕获浏览器发出的HTTP/HTTPS请求。内容涵盖环境安装、目录结构配置及核心代码实现,重点解析如何过滤静态资源并提取请求关键信息,适用于安全扫描器开发场景。
2026-10-13
8

本文介绍如何利用Python结合Mitmproxy库构建被动式代理,以捕获浏览器发出的HTTP/HTTPS请求。内容涵盖环境安装、目录结构配置及核心代码实现,重点解析如何过滤静态资源并提取请求关键信息,适用于安全扫描器开发场景。
本文汇总了Python初学者最常遇到的12类错误,包括语法缺失、运算符误用、缩进规范、类型转换及作用域问题。通过对比错误代码与正确写法,帮助开发者快速定位并修复NameError、TypeError、IndentationError等异常,提升代码健壮性。
本文深入对比Python中三种主流字符串格式化方式:%-formatting、str.format及f-string。分析指出%-formatting在复杂场景下可读性差,str.format虽改进但仍显冗余。重点解析f-string(Python 3.6+)凭借运行时表达式求值机制,在语法简洁性、代码可读性及执行性能上均显著优于传统方法,推荐作为现代Python开发的首选方案。
本文介绍如何使用Python的serial和thread模块实现串口数据的实时接收。通过封装MSerialPort类,利用多线程机制在后台持续读取串口数据,主线程负责定时打印接收到的信息,适用于嵌入式设备通信等场景。
本文详解Python中实现斐波那契数列的三种主流方法:递归法、递推法及矩阵法。通过对比分析各算法的时间与空间复杂度,指出递归法虽简洁但存在重复计算与深度限制,递推法线性增长,而矩阵法利用二分加速实现对数级复杂度。文章提供完整代码示例及性能对比图表,帮助开发者根据数据规模选择最优方案。
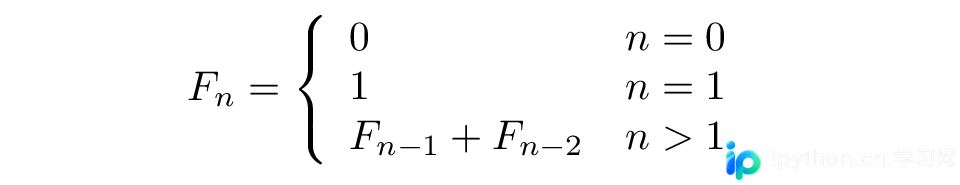
本文详细解析Pandas库中resample方法的使用。涵盖降采样与升采样的具体操作,包括频率调整、区间闭合规则(closed)、标签设置(label)以及NaN值填充策略(pad/bfill)。通过Series示例展示如何应用自定义函数,帮助开发者掌握时间序列数据的高效处理技巧。
本文介绍如何在Windows系统中使用Python获取连接的USB设备的PID和VID。对比了pyusb库的依赖复杂性,推荐使用pyWin32库通过WMI接口查询。重点解析Win32_USBHub与win32_usbcontrollerdevice的区别,并提供获取所有USB设备信息的完整代码示例,适用于需要稳定部署的场景。
本文详解 Python 中 Lambda 匿名函数的定义与常规 def 函数的区别,通过绝对值排序和闭包两个典型场景展示其应用。同时结合代码示例分析何时使用 Lambda 更简洁,何时应回归常规函数以保证代码可读性,帮助开发者掌握 Pythonic 编码技巧。
本文详解 pandas DataFrame 的行列索引创建与值提取方法。通过 index 和 columns 参数自定义索引,演示如何获取单列、单行及特定单元格数值。结合车站客流数据实例,展示利用 iloc 和 loc 进行数据筛选与统计计算,如查找最大客流车站及其日均值对比。
本文深入解析Python中列表(list)与元组(tuple)的核心差异。两者均为序列类型,但元组不可变而列表可变,这导致它们在内存占用、初始化速度及作为字典键的能力上存在显著不同。文章通过代码示例对比了它们的操作方法、异构与同构数据的存储策略,以及namedtuple的轻量级类应用,帮助开发者根据场景选择合适的数据结构。
本文深入解析Pandas中分组聚合的核心机制,详细对比apply、applymap、map及agg函数的适用场景与性能差异。通过groupby对象的工作原理,结合代码示例展示如何高效进行数据分组、统计分析及多维度聚合操作,帮助开发者优化数据处理流程。
本文整理Python常用函数与基础用法,涵盖自定义函数定义、文件删除操作、金字塔图案打印及九九乘法表生成等实例。通过具体代码示例,展示Python在字符串处理、文件IO及循环控制方面的实际应用,适合初学者参考学习。