

pandas取出重复数据的方法
本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。
2026-10-13
10

本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。
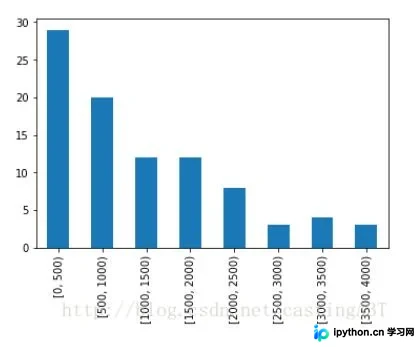
本文通过具体代码示例,演示如何利用pandas库对销售数据进行区间划分(分箱)并计算各区间频率。主要涉及pd.cut函数的区间设置、value_counts统计频数,以及通过DataFrame操作计算频率百分比与累计频率,最终结合matplotlib生成条形图可视化结果。
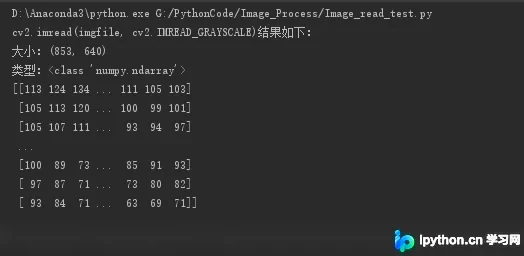
本文总结了Python3中读取图片并转换为灰度图的四种常用方法,包括OpenCV直接读取、OpenCV转换、PIL.Image模块以及TensorFlow处理。通过代码示例和运行结果对比,分析了各方法在实现细节和输出结果上的差异,建议在实际项目中保持处理链路的一致性以避免潜在Bug。
本文详细介绍Pandas中用于数据分析的累积计算(cum系列)与滚动计算(rolling系列)函数。cum系列作为DataFrame或Series的方法,用于生成前n项的累计和、积、最大值等;rolling系列则通过指定窗口大小k,对数据进行滑动窗口统计,如计算滚动均值、方差等。文章提供了具体的代码示例和输出结果,帮助开发者掌握这两种常用统计技巧。
本文详细介绍如何使用Python读取Excel文件(包括xlsx和xls格式)并进行数据分类统计。通过openpyxl和xlrd两个库,分别演示了基础数据提取与复杂通话记录的分类统计方法,涵盖按地点、类型及号码汇总时长的完整代码实现。
本文介绍 Python 中强大的命令行库 Click。通过安装、基础命令创建、参数选项配置以及 Group 分组功能,展示如何用少量代码构建优雅的命令行工具。涵盖装饰器使用、参数类型定义、交互式提示及子命令管理,适合需要开发 CLI 应用的开发者参考。
本文基于Clean Code理念,结合Python3.7语法,总结7条变量命名建议。涵盖使用有意义名称、统一同类变量词汇、确保可搜索性、自我描述、避免猜测、去除冗余上下文及合理使用默认参数。通过正误代码对比,帮助开发者提升代码质量与可维护性。
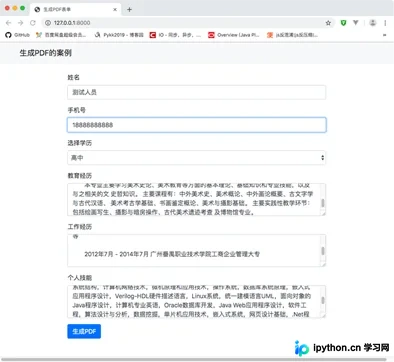
本文介绍如何在Django项目中利用xhtml2pdf库生成PDF文件,重点解决中文显示乱码问题。通过配置中文字体、编写表单验证与类视图,实现用户信息到PDF的转换。文章包含完整的安装步骤、代码示例及字体配置方法,帮助开发者快速实现PDF下载与预览功能。
本文详解Python中CSV、JSON和XML三种主流数据格式的读写方法。通过内置csv、json模块及ElementTree处理XML,结合pandas库实现高效操作。重点演示如何将数据在列表、字典、DataFrame及XML之间相互转换,涵盖从基础读写到高级格式互转的完整流程,助开发者轻松应对数据存储与交换需求。
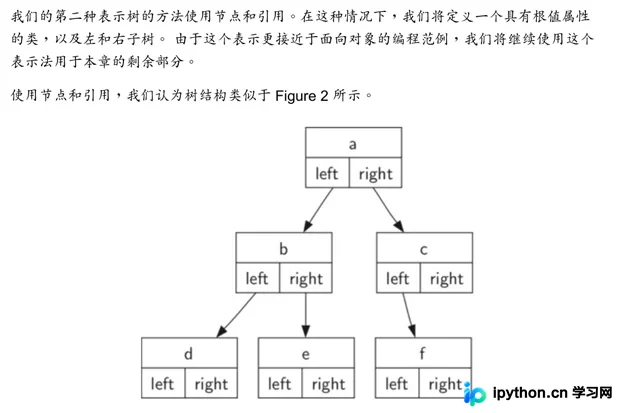
本文详细解析Python中二叉树的构建与四种核心遍历算法。通过递归与非递归两种方式,分别实现前序、中序、后序及层次遍历。重点阐述利用栈结构处理非递归遍历时节点入栈与出栈的逻辑,以及后序遍历中双栈法的应用,附带完整代码与运行结果分析,帮助开发者深入理解树形数据结构的操作细节。
本文介绍如何在Python中使用Matplotlib库设置输出图像的像素大小和分辨率。通过修改plt.rcParams中的'savefig.dpi'和'figure.dpi'参数,可分别控制保存图像的像素密度和画布分辨率。该方法适用于plt.show()之前,帮助开发者生成更清晰的高清图像,常用于科研绘图或高清展示场景。
本文介绍如何利用Python3的PIL库将非RGB格式图片转换为RGB格式,以满足深度学习模型对输入数据的要求。内容涵盖单张图片转换方法及基于txt文件路径列表的批量处理脚本,解决灰度图等格式转换的实际需求。