

Python3递归法求二叉树最大深度详解
本文介绍如何使用Python3通过递归方法计算二叉树的最大深度。文章定义了二叉树深度的概念,即根节点到最远叶子节点路径上的节点数,并详细解析了递归遍历的逻辑:从根节点向下遍历,每进入一层子节点深度加一。文中提供了完整的Python3代码实现,包括TreeNode类的定义及Solution类的maxDepth和getDepth方法,最后对算法的时间与空间复杂度进行了简要分析,帮助读者掌握二叉树基础遍历技巧。
2026-10-13
3

本文介绍如何使用Python3通过递归方法计算二叉树的最大深度。文章定义了二叉树深度的概念,即根节点到最远叶子节点路径上的节点数,并详细解析了递归遍历的逻辑:从根节点向下遍历,每进入一层子节点深度加一。文中提供了完整的Python3代码实现,包括TreeNode类的定义及Solution类的maxDepth和getDepth方法,最后对算法的时间与空间复杂度进行了简要分析,帮助读者掌握二叉树基础遍历技巧。
本文详细介绍如何利用Python3标准库urllib结合BeautifulSoup解析HTML,实现自动投票功能。通过获取Cookie、解析动态验证码并提交POST请求,完成投票逻辑。代码包含完整的请求头设置与数据封装示例,适用于需要批量处理投票场景的开发参考。
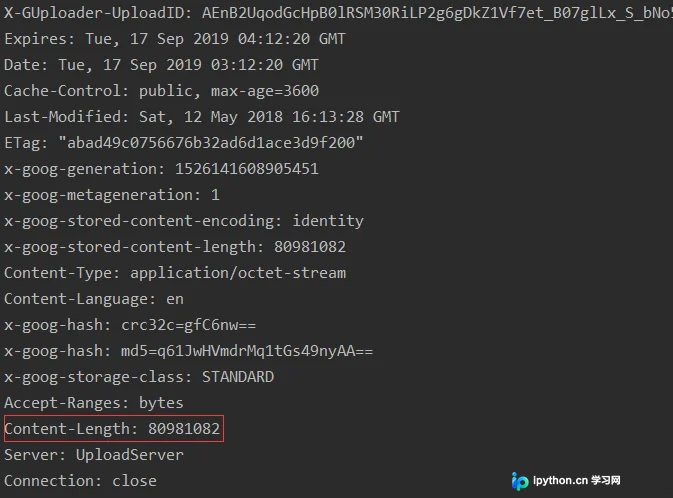
本文介绍在Python3中如何使用urllib模块获取远程URL的文件大小。重点解决urllib2迁移至urllib.request后的代码适配问题,并指出服务器返回的Content-Length头字段大小写敏感导致的获取失败现象,提供修正后的完整示例代码。
本文介绍基于Python3和easygui库开发的图形界面代码统计工具。程序通过递归遍历指定目录下的文件,忽略venv和.idea等无关目录,统计各类代码文件的行数并汇总展示。针对非UTF-8编码文件采用异常跳过机制,最终在GUI文本框中输出总行数、完成百分比及各类文件明细,为开发者提供便捷的项目规模评估手段。
本文详细介绍Python3中将数据保存为TXT文件的方法,包括使用open()和write()函数进行基础写入,以及利用numpy库的savetxt()函数处理数组数据。同时涵盖使用save()和savez()保存二进制文件(.np/.npz格式)的操作,并附带读取数据的load()方法示例,帮助开发者高效管理数据存储。
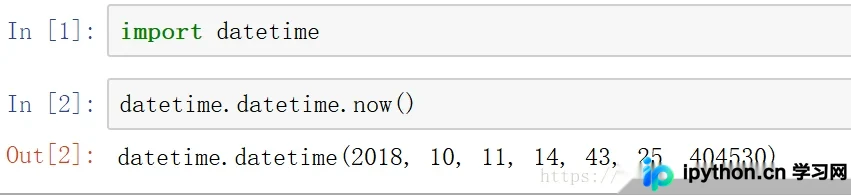
本文系统总结Python3中处理时间的常用方法。通过datetime模块,演示如何获取并输出当前系统时间,利用strftime()进行标准化格式输出(如年月日时分秒)。此外,详细讲解如何计算两个日期之间的时间间隔,以及如何对当前时间进行天、小时、分钟和秒的加减运算,为开发提供实用的时间处理代码参考。
本文介绍使用Python3结合xlrd库读取Excel中的姓名与代号,自动批量创建对应文件夹,并遍历指定目录将包含姓名关键词的文件移动至新文件夹的方法。通过os和shutil模块实现文件查找与移动,适用于大量文件整理场景,提供完整代码及关键函数说明。
本文介绍了在Python 3.6.1环境下实现文件复制及带延时功能的批量复制脚本。通过shutil模块完成简单文件重命名复制,并扩展加入time模块实现循环中的延时控制,适用于测试客户端报文传输速率等场景。
本文深入解析Python3中类方法、静态方法与实例方法的区别。通过Date类示例,展示如何利用@classmethod实现灵活的工厂模式,自动处理子类继承问题,并对比@staticmethod在无需访问类或实例状态时的适用场景,帮助开发者根据是否返回实例对象选择合适的方法定义方式。
本文介绍了使用Python3将视频转换为字符动画的完整实现方案。通过OpenCV处理视频帧,提取颜色与字符映射信息,并结合JavaScript在前端渲染彩色字符画面。代码包含视频处理核心类及HTML生成逻辑,支持自定义帧率与宽度,最终输出可直接在浏览器播放的HTML文件。
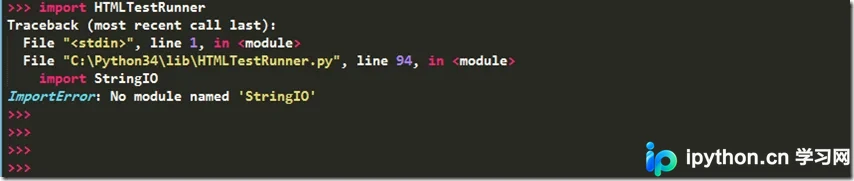
本文详细解析在Python3环境下使用HTMLTestRunner时遇到的ImportError: No module named 'StringIO'错误。由于官方原版基于Python2编写,需手动修改源码以适配Python3语法。文章列出了具体的代码修改位置及对应语句,包括StringIO导入、字典键值判断、字符串解码及print语句的转换,帮助开发者快速解决模块引入失败的问题。
本文详细介绍Python3中字节串bytes与字节数组bytearray的使用方法。涵盖bytes的多种构造方式、常用运算操作,以及bytes与str之间通过encode和decode进行的编码转换流程。