

Python爬虫面对反爬机制有多吃力?IP封禁与验证码应对
深入解析Python爬虫在遭遇IP封禁与验证码拦截时的真实阻力来源,提供代理池调度、指数退避重试、人机验证识别与浏览器指纹模拟的工程化解决方案。
2026-10-26
29

深入解析Python爬虫在遭遇IP封禁与验证码拦截时的真实阻力来源,提供代理池调度、指数退避重试、人机验证识别与浏览器指纹模拟的工程化解决方案。
本文基于《Python3网络爬虫开发实践》案例,针对腾讯网站更新后导致的Cookie登录失效问题提供解决方案。通过整合Selenium浏览器自动化与代理池技术,详细演示了如何配置Chrome驱动、设置请求头及处理重试机制,帮助开发者应对反爬策略变更,实现稳定的微信文章数据抓取。
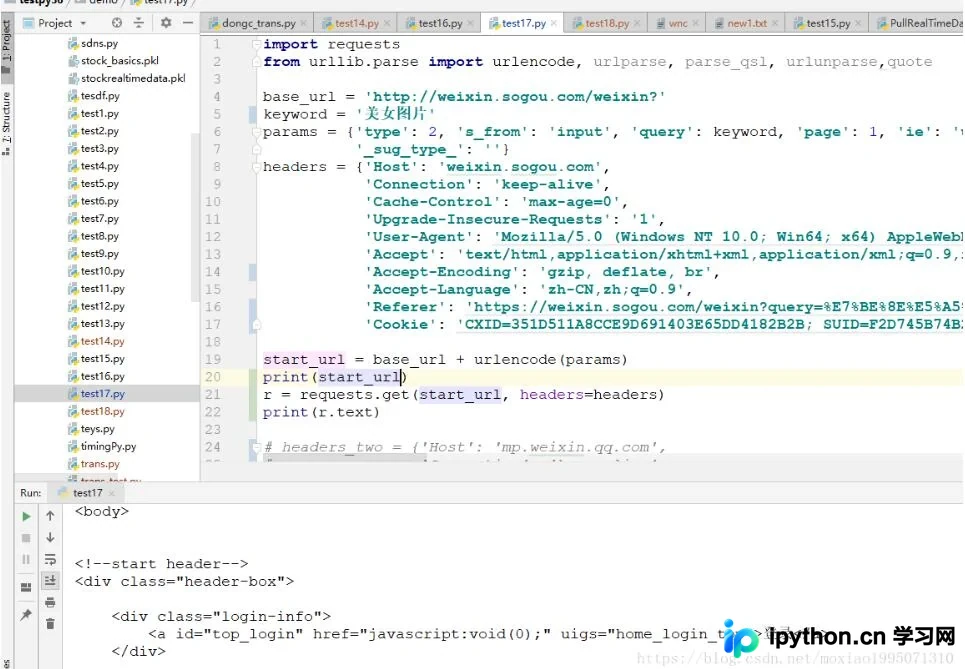
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。
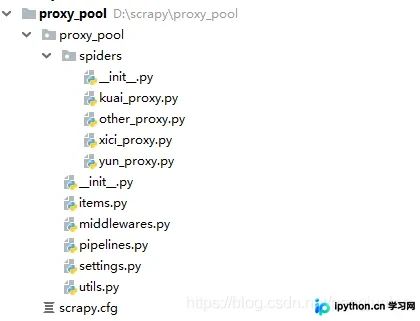
本文详细介绍Python爬虫代理池的搭建流程。针对IP访问频率限制问题,提出通过代理池轮询IP的解决方案。涵盖从代理网站抓取、可用性验证、Redis存储到队列管理的完整代码实现,包含IPProxy类、配置管理及多爬虫基类设计,并提供测试与GitHub源码地址。
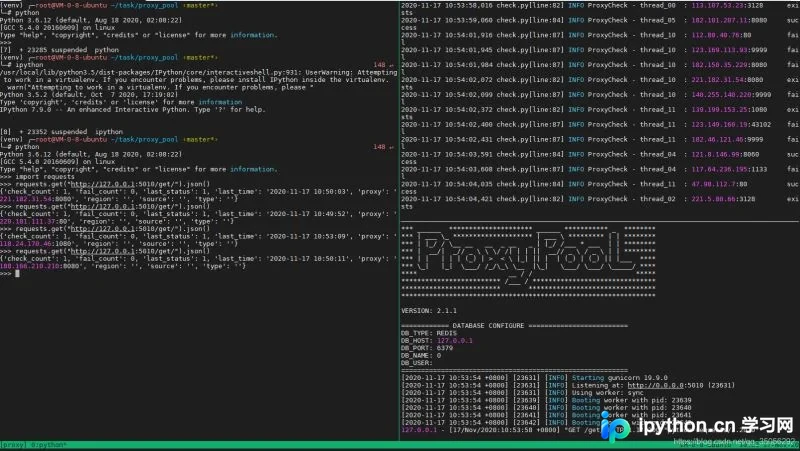
本文介绍在Python爬虫开发中,针对高并发请求导致IP被封禁的问题,使用开源项目proxy_pool搭建代理池的完整流程。涵盖从Python虚拟环境搭建、Redis依赖安装,到配置文件修改、服务启动及代码测试的具体步骤,帮助开发者实现IP自动轮换与异常处理。
深入解析Scrapy单进程事件驱动机制,从Twisted/Asyncio底层架构、非阻塞中间件编写,到高并发参数调优与生产级避坑指南,全面构建高吞吐量异步爬虫系统。
本文详解如何使用Python构建一个轻量级的爬虫代理池。通过抓取西祠胡同等免费代理网站,利用PyQuery解析数据并存入List,实现HTTP与HTTPS代理的分类管理。文章提供了代理有效性检测、随机调用及失效清理的核心代码逻辑,并探讨了基于分数的代理维护机制,帮助开发者应对403限制。