

PHP 使用 iconv 转换 UTF-8 与 GB2312 编码避免失败
在 PHP 开发中,直接使用 iconv() 进行字符集转换时常因特殊字符报错导致转换失败。本文介绍通过在目标编码后添加 //IGNORE 参数,使函数自动忽略无法识别的字符并继续执行,从而解决 UTF-8 与 GB2312 之间的编码转换难题。
2026-10-16
14

在 PHP 开发中,直接使用 iconv() 进行字符集转换时常因特殊字符报错导致转换失败。本文介绍通过在目标编码后添加 //IGNORE 参数,使函数自动忽略无法识别的字符并继续执行,从而解决 UTF-8 与 GB2312 之间的编码转换难题。
本文系统梳理PHP开发中常见的UTF-8乱码问题,涵盖HTML页面、PHP文件、MySQL数据库及JS交互四个层面的编码配置。重点讲解如何去除BOM头、设置Header响应类型、统一数据库字符集以及使用iconv进行字符转换,帮助开发者快速定位并解决中文显示异常问题。
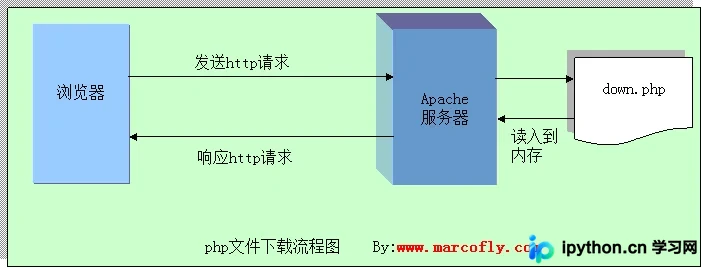
本文详细解析 PHP 服务端文件下载的完整流程,涵盖从请求接收、文件读取到响应头设置及分块传输的每一步。提供包含中文路径处理、内存缓冲控制和安全检查在内的可执行 PHP 代码,帮助开发者高效、稳定地实现大文件下载功能。
本文解析PHP中将GB2312/GBK转换为UTF-8的方法。对比了高性能但需指定源编码的iconv函数,以及支持自动识别编码但性能稍低的mb_convert_encoding函数。提供了处理非法字符截断问题的方案,并演示了检测字符串编码后自动转换的代码示例。
在PHP开发中,正确处理字符编码是避免乱码的关键。本文介绍使用 mb_detect_encoding() 函数自动检测字符串当前编码格式的完整方案,包括配置多编码库(ASCII, UTF-8, GBK等),以及结合 iconv() 进行目标编码转换的具体操作步骤与代码实例。
本文提供PHP环境下实现Unicode字符串编码(将中文转为\u格式)和解码(将\u格式还原为可读文本)的完整类库代码。通过iconv进行字符集转换,结合正则表达式解析Unicode序列,解决JSON数据交互或前端展示中的乱码问题。
在 PHP 中对包含中文字符串的数组进行默认排序时,UTF-8 编码下的 asort 往往无法实现按拼音排序。这是因为 GBK 等内码集天然支持拼音序,而 UTF-8 是 Unicode 编码。解决思路是通过 iconv 函数将 UTF-8 临时转换为 GBK 或 GB2312 进行排序,最后再转回 UTF-8。本文将详细介绍处理非法字符风险的修正方法及完整代码实现。
本文详解PHP中iconv函数在GB2312转UTF-8时因非法字符导致内容截断的问题。通过添加//IGNORE参数,可避免E_NOTICE错误及数据丢失,确保采集程序稳定运行。