

PHP实现文件下载功能:核心原理与完整代码示例

发布时间:2026-10-15| 4人浏览过
深入解析 PHP 服务端文件下载的完整流程,涵盖请求处理、内存读取、响应头设置及分块传输等核心步骤,并提供含中文文件名兼容处理的完整代码示例。
服务器端文件下载的核心逻辑
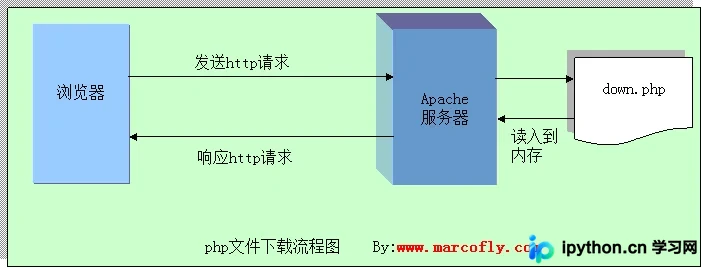
客户端(浏览器)通过 HTTP 请求触发服务器上的脚本(如 down.php),服务端接收到请求后,立即开始执行以下关键动作:
- 读取目标文件至内存:这是实现下载的基础。任何文件的远程获取都必须先在服务端将其加载,通常借助
fopen()函数打开一个只读的文件句柄(File Pointer)。 - 向客户端流式输出数据:对于体积较大的文件,绝不能一次性将全部字节读取完毕后发送,否则会引发严重的内存溢出或阻塞服务器响应。最佳实践是设定固定的缓冲区大小(例如每次 1024 字节),利用循环一边读取一边向客户端推送数据,以此降低服务器负载并提升连接稳定性。
完整操作流程与参数配置
一个健壮的文件下载脚本需要精确配置 HTTP 响应头并处理文件路径。以下是具体的操作步骤及注意事项:
第1步:初始化环境与安全验证
首先需确保目标文件存在于指定路径。注意:部分老旧 PHP 函数对非 ASCII 编码路径支持不佳,若文件名包含中文,必须先使用 iconv('utf-8', 'gb2312', $filename) 进行转码,否则 file_exists() 可能无法识别。同时建议使用绝对路径(如结合 $_SERVER['DOCUMENT_ROOT'])以确保跨目录调用的准确性。
第2步:构建必需的 HTTP 响应头 (Header)
在发送实际数据前,必须使用 Header() 告诉浏览器如何正确处理即将传输的内容。以下四个响应头缺一不可:
Content-type: application/octet-stream:声明内容为通用二进制流,浏览器将提示用户“保存”而非直接尝试在网页内渲染。Accept-Ranges: bytes:告知浏览器服务器支持基于字节的范围请求,便于断点续传或进度显示。Accept-Length: [total_bytes]:发送文件的总字节数(可通过filesize()获取)。Content-Disposition: attachment; filename=[name]:强制浏览器以附件形式下载,并预设推荐的文件名。
第3步:循环分块读取并输出数据
定义缓冲区变量(如 $buffer=1024)。开启一个 while 循环,当 feof($fp)(未到达文件末尾)且当前累计字节小于文件大小限制时,不断调用 fread($fp, $buffer) 读取小段数据并通过 echo 输出给前端。读取完成后,务必执行 fclose($fp) 释放资源。
核心逻辑流程图解
整个数据的流向与控制过程如下图所示:
完整的 PHP 下载实现代码
<?php
// 指定要下载的原始文件名(示例为中文图片名)
$file_name = "圣诞狂欢.jpg";

// 解决部分环境不支持中文路径的问题(根据具体文件系统要求调整)
$file_name = iconv("UTF-8", "GB2312", $file_name);

// 拼接文件物理绝对路径,避免相对路径错误
$sub_path = $_SERVER['DOCUMENT_ROOT'] . "marcofly/phpstudy/down/down/";
$file_path = $sub_path . $file_name;

// 安全验证:确认文件是否存在
if(!file_exists($file_path)){
    echo "没有该文件文件";
    return;
}

// 打开文件指针,仅做读取操作
$fp = fopen($file_path, "r");

// 获取文件总大小
$file_size = filesize($file_path);

// 【必需】设置 MIME 类型,告知浏览器这是不可预知类型的二进制数据
header("Content-type: application/octet-stream");

// 【必需】支持按字节范围请求
header("Accept-Ranges: bytes");

// 【必需】传输文件的总字节数
header("Accept-Length:" . $file_size);

// 【必需】设置为附件下载模式,并指定默认文件名
header("Content-Disposition: attachment; filename=" . $file_name);

// 设置单次读取缓冲区大小(单位:字节),控制内存占用与IO效率
$buffer = 1024;
$file_count = 0;

// 【核心】分批读取并实时输出内容到浏览器
while(!feof($fp) && $file_count < $file_size){
    // 读取 $buffer 大小的数据块
    $file_con = fread($fp, $buffer);
    // 累加已传输计数
    $file_count += $buffer;
    // 输出数据块给客户端
    echo $file_con;
}

// 关闭文件句柄并清理相关系统资源
fclose($fp);
?>
关键技术细节解析
header("Content-type:text/html;charset=utf-8")的作用:- 该指令告诉浏览器以 UTF-8 编码格式解析当前的文本内容。虽然纯下载流中不一定强制依赖此头部,但在涉及界面反馈(如报错信息)时可防止乱码。
Accept-Length与内存控制策略:- 如果不设定一次性读取的大小而试图用
file_get_contents()直接将所有数据塞入内存,在面对百兆级甚至更大的文件时会严重拖垮服务器性能。本方案采用逐块输出(Chunked Transfer),能保持极低的常驻内存开销。
以上就是 PHP 实现文件下载功能的详细内容,更多关于 PHP 开发实用技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









