

Python使用linecache模块获取文件指定行内容
本文介绍Python标准库linecache模块,通过getline方法快速获取文件指定行内容。该方法由traceback模块内部使用,支持从sys.path查找文件。若行号超出范围或文件不存在,均返回空字符串而不报错。针对大文件读取效率低的问题,提供了基于enumerate的手动遍历替代方案,需注意行号从1开始计数。
2026-10-13
6

本文介绍Python标准库linecache模块,通过getline方法快速获取文件指定行内容。该方法由traceback模块内部使用,支持从sys.path查找文件。若行号超出范围或文件不存在,均返回空字符串而不报错。针对大文件读取效率低的问题,提供了基于enumerate的手动遍历替代方案,需注意行号从1开始计数。
PHP 函数分为内置函数与用户自定义函数,其底层执行机制截然不同。内置函数本质是 C 函数转发,效率极高;而用户函数通过 Zend 虚拟机解释执行 Opcode,并依赖符号表栈管理局部变量。本文解析 PHP 函数调用流程、参数传递及递归实现的底层逻辑,探讨静态数组模拟堆栈对性能的影响,为编写高性能 PHP 代码提供理论依据。
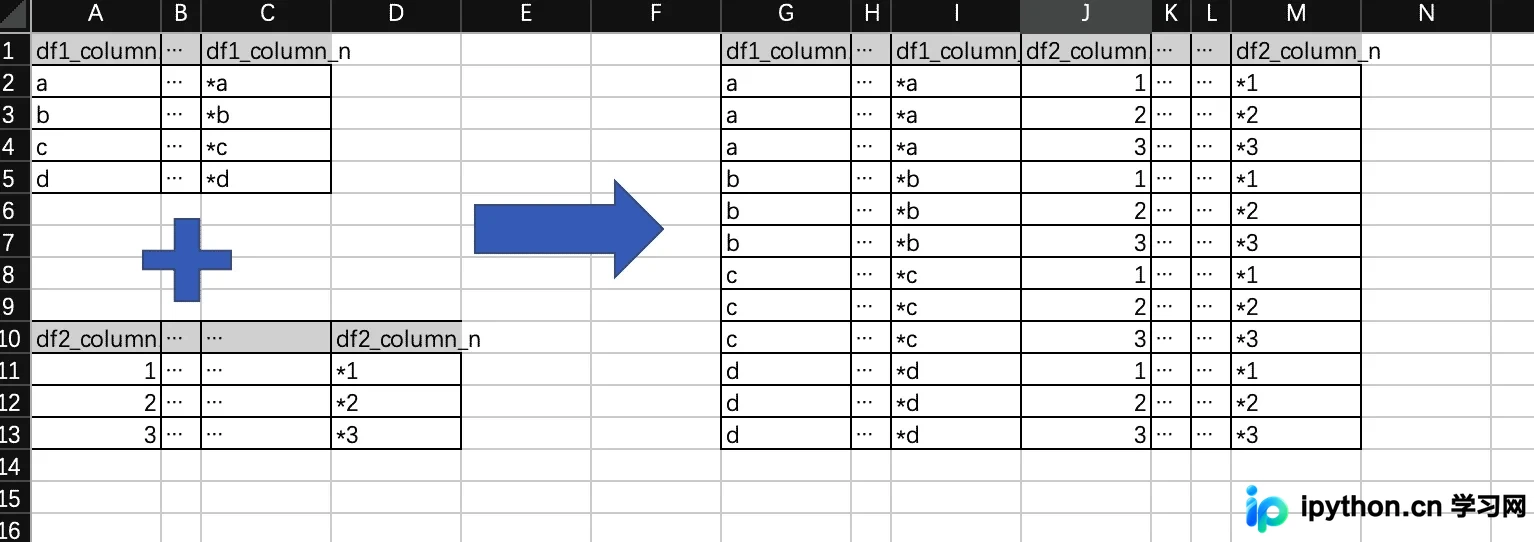
本文介绍如何在Python中高效计算两个Dataframe的笛卡尔积。通过对比双重循环法与基于Merge的优化法,展示了利用Pandas内置功能将时间复杂度从O(m*n)降低至O(n)的技巧,并提供了具体的代码实现与性能测试数据,帮助开发者解决大数据量下的合并性能瓶颈。
本文介绍在Jupyter Notebook中查看单元格运行时间的两种方法:通过安装jupyter_contrib_nbextensions启用Execute Time插件,以及使用%time和%%time Magic命令进行代码性能分析。详细解释了CPU时间与Wall time的区别,帮助用户优化代码执行效率。
在PHP项目中使用preg_match进行复杂正则匹配时,若遇到匹配失败或无结果的情况,通常是因为触发了默认的回溯和递归限制。本文详解如何通过ini_set调整pcre.backtrack_limit和pcre.recursion_limit参数值,并配合memory_limit设置,确保长字符串处理的稳定性与安全性。
本文通过IL代码分析C#中Try-Catch机制,指出无异常发生时性能损耗极小,仅在捕获异常时需遍历Exception Handling Table。提供避免在循环中使用、明确异常类型及优先使用Try-Parse等优化准则,帮助开发者正确评估并合理使用异常处理。
本文深入解析 MySQL Order By 排序的内部机制,包括利用索引有序性获取数据和内存/磁盘文件排序(双路与单路)。通过调整 max_length_for_sort_data、去除冗余字段及合理配置 sort_buffer_size,可显著减少随机 IO 并提升查询效率,避免高并发下的资源耗尽。
本文探讨如何在Python中通过多线程技术加速耗时的For循环操作。针对大规模数据(如千万级记录)处理场景,通过示例展示如何将串行处理改为并行处理,利用multiprocessing.dummy模块中的ThreadPool实现并发执行,显著减少运行时间,并提供具体代码实现与性能对比结果。
本文介绍Django中F表达式在更新数据库字段时的应用。相比传统加载内存方式,F表达式直接生成SQL语句,显著提升大量数据更新性能。文章涵盖单对象与批量更新的代码示例,并重点强调更新后调用refresh_from_db()获取最新字段值的重要性,避免数据不一致问题。
本文深入解析Python中双下划线的魔法方法,涵盖__init__、__getattr__、__slots__及__enter__/__exit__等核心机制,并演示如何通过类方法、装饰器及元类实现单例模式,帮助开发者优化内存使用并掌握高级面向对象编程技巧。
本文深入解析Python中类属性的动态绑定机制,探讨实例调用类方法时的实时查找过程。通过对比实验量化动态绑定与静态绑定的性能差异,指出在低频次调用下开销可忽略,但在千万级循环中会产生显著时间损耗。同时分析动态绑定在灵活性上的优势,帮助开发者理解其适用场景与潜在影响。
JavaScript中setInterval容易因执行时间超过间隔导致任务堆积。本文介绍如何通过setTimeout实现递归调用替代setInterval,确保每次任务完成后才开始计时,从而避免堆积和并发执行风险,提升定时任务的稳定性。