

Python中DataFrame与Series的创建方法解析
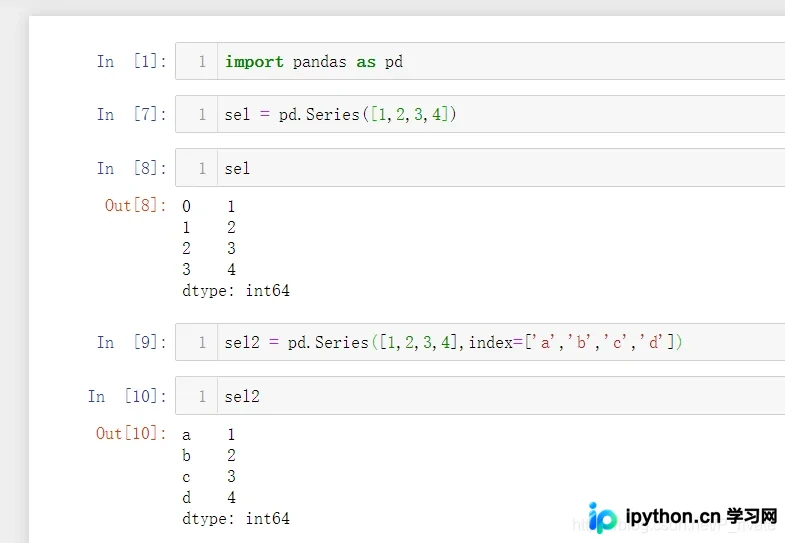
本文介绍了Python中Pandas库下Series和DataFrame的基本创建方式。通过示例代码展示了如何利用列表生成Series,以及如何结合日期索引与随机数矩阵构建DataFrame,并输出运行结果供参考。
2026-10-13
5

本文介绍了Python中Pandas库下Series和DataFrame的基本创建方式。通过示例代码展示了如何利用列表生成Series,以及如何结合日期索引与随机数矩阵构建DataFrame,并输出运行结果供参考。
本文详细讲解如何利用pandas库对Series和DataFrame进行排序操作。内容涵盖按索引排序、按值排序、升降序调整及多列排序等核心功能,通过具体代码示例与运行结果展示,帮助开发者掌握数据清洗与预处理中的关键排序技巧。
本文详解pandas中处理重复索引的方法。通过Series.index.is_unique判断索引是否重复,并对比Series与DataFrame在索引取值时的返回类型差异。Series取重复索引返回Series,而DataFrame始终返回DataFrame。文章提供具体代码示例,帮助开发者避免常见错误。
本文介绍在Python数据分析中,如何利用字典或Series对象对DataFrame进行自定义分组。通过示例演示了groupby方法在列方向上的应用,展示了如何将多个列映射到同一组别(如red、blue)并执行聚合计算。对比发现字典与Series分组原理一致,均通过键值匹配实现数据归类,为灵活处理复杂数据结构提供了实用方案。
Pandas 的 Series 是用于存储一维序列的带标签数据结构,其底层由索引与值数组组成。本文通过可运行代码演示如何创建 Series、使用索引与切片访问元素、执行基础数学运算与标签对齐,并掌握 unique、value_counts 及 isin 等高效统计筛选方法,助您快速上手结构化数据的常规处理流程。
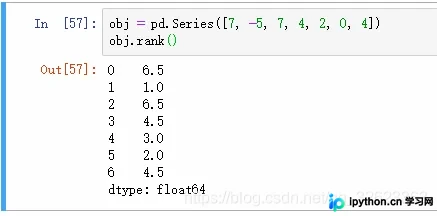
本文详解pandas中Series与DataFrame的rank排名函数。内容涵盖默认平均排名原理、利用method参数自定义并列值处理策略、设置降序排列以及指定数据框行列维度的完整操作指南,帮助开发者快速掌握数据位次计算与标准化处理方法。
本文详解pandas中df.dropna()函数的使用,涵盖Series和DataFrame的缺失值删除。重点解析axis、how、thresh、subset和inplace等关键参数,通过具体代码示例展示如何灵活处理不同场景下的NaN数据,帮助开发者高效清理数据。
本文介绍如何使用 pandas 的 concat 函数对 Series 数据进行轴向连接。通过示例演示了默认 axis=0 的连接方式,以及按 axis=1 连接生成 DataFrame 的情况。重点解析了不同轴向操作对结果类型的影响,并展示了索引重叠时的连接行为。
本文详细介绍 Pandas 中 Series 数据结构的创建、索引机制及常用操作方法。涵盖通过列表和字典构建 Series,掌握位置索引与标签索引的区别,演示花式索引与布尔索引技巧。同时深入解析 describe、value_counts、去重、空值处理(dropna/fillna)及排序取 Top-N 等核心函数的使用,帮助开发者高效处理一维数据。
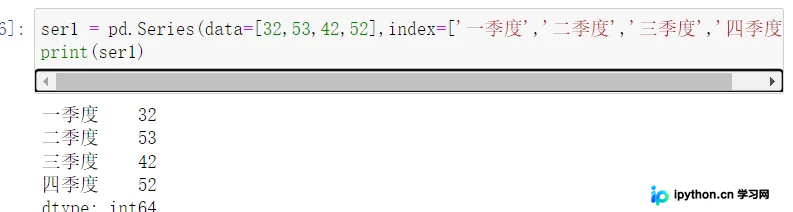
本文深入解析Pandas中Series与DataFrame的算术运算规则。重点阐述索引对齐机制,说明当索引不匹配时如何生成NaN值。同时详细讲解利用广播机制实现DataFrame与特定行或列的运算,包括指定axis参数的具体用法,帮助开发者掌握数据对齐与广播的核心逻辑。