

Python使用Pandas读写Excel实例解析
本文详细解析Python中Pandas库读写Excel文件的方法。涵盖安装pandas及依赖包xlrd、openpyxl的步骤,演示如何创建Excel并写入数据,深入讲解read_excel函数的关键参数如io、sheet_name、header等,并提供读取、增删行列及保存文件的完整代码示例,帮助开发者高效处理大型数据集。
2026-10-13
5

本文详细解析Python中Pandas库读写Excel文件的方法。涵盖安装pandas及依赖包xlrd、openpyxl的步骤,演示如何创建Excel并写入数据,深入讲解read_excel函数的关键参数如io、sheet_name、header等,并提供读取、增删行列及保存文件的完整代码示例,帮助开发者高效处理大型数据集。
本文介绍如何使用Python批量读取Excel文件,调用百度翻译API进行内容翻译,并将结果写回Excel。通过os.listdir遍历文件,利用xlrd读取数据,结合百度翻译接口实现中英文互译,最后使用openpyxl将翻译结果写入指定列。
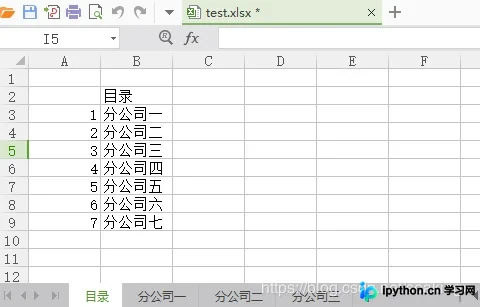
本文介绍如何使用Python的openpyxl库,根据Excel文件中的目录信息,将包含多个工作簿的工作簿拆分为独立的单个文件。通过遍历目录表并逐个复制单元格数据,实现自动化拆分,适用于需要批量处理Excel文件的场景。
本文提供Python实现的智联招聘爬虫代码实例。通过输入职位关键字,程序自动抓取职位名称、薪资及工作经验等数据,并利用openpyxl库将结果写入Excel文件。代码包含完整的请求头设置、分页逻辑及数据解析过程,适合用于快速获取招聘平台公开信息。
本文介绍Python中三种将数据写入CSV或Excel文件的方法:使用csv模块处理CSV文件,利用openpyxl模块操作xlsx格式,以及通过pandas库同时支持两种格式。其中pandas方法代码最简洁,适合快速实现数据持久化需求。
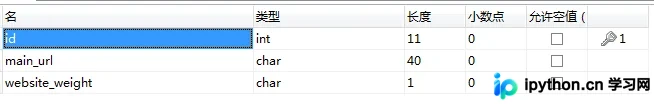
本文详细解析如何使用Python3批量查询网站百度权重。通过openpyxl读取Excel中的网址列表,利用Requests伪造请求获取seo.chinaz.com页面,并用BeautifulSoup提取权重数据。最终将结果写入MySQL数据库及Excel文件,提供完整的代码逻辑与配置说明。
本文介绍如何使用仅50行Python代码批量抓取高考志愿信息。通过结合requests-html解析网页与openpyxl处理Excel,实现从URL列表读取、网页内容提取到数据写入的全流程。文中详细讲解了处理非结构化HTML、正则表达式分割学校名称及表格切片等关键技术点,并提供了完整的错误处理与代码示例,帮助开发者快速完成数据自动化任务。
本文介绍如何利用Python的pyautocad库连接AutoCAD,通过iter_objects方法遍历Text对象,获取文本字符串及插入点坐标。结合openpyxl库,将提取的数据写入Excel文件。文中提供了三个示例,演示了基础数据导出、特定型号(如BM30/BM65)筛选以及多型号(Vigi/iC65等)批量处理的方法,帮助开发者实现CAD图纸数据的自动化整理。
本文总结了Python自动化测试中处理Excel文件的三种常用方法:openpyxl、xlrd及pandas。文章详细对比了各库的安装方式、读写特性及局限性,重点提供了针对多Sheet操作Bug修复的openpyxl封装代码,以及xlrd配合xlutils处理.xls文件的读写方案,并简要展示了pandas在数据读取中的应用,旨在为测试人员提供可直接复用的工具类代码。
本文介绍Python处理Excel时插入和删除行的两种方案。openpyxl虽常用但中间操作性能差,需转换列表或修改源码;推荐xlwings,支持调用VBA接口,在Windows和macOS下运行高效且兼容WPS,适合需要动态调整行数的场景。
本文介绍了使用Python openpyxl库遍历Excel文件中所有工作表并查找特定字符串的方法。通过遍历每个sheet中的单元格,检查其值是否包含目标字符串,并输出匹配结果。该方法适用于需要批量处理Excel文件内容的场景。
本文介绍在 Python 3.6 环境下利用 PyInstaller 将 Python 脚本打包为可执行文件(exe)的具体步骤。重点强调必须使用 32 位 Python,并详细说明了处理 PyInstaller 兼容性问题及安装 openpyxl 模块的方法。