

Python统计学基础:数据概括性度量详解与代码实现
本文详细介绍Python中数据概括性度量的核心概念,涵盖集中趋势(众数、中位数、四分位数、平均数)与离散趋势(四分位差、极差、方差、标准差、离散系数)的计算方法,以及偏度与峰度的分布特征分析。结合Python3.5环境下的numpy和stats库代码示例,展示如何批量计算各项统计指标,为数据分析提供量化依据。
2026-10-13
6

本文详细介绍Python中数据概括性度量的核心概念,涵盖集中趋势(众数、中位数、四分位数、平均数)与离散趋势(四分位差、极差、方差、标准差、离散系数)的计算方法,以及偏度与峰度的分布特征分析。结合Python3.5环境下的numpy和stats库代码示例,展示如何批量计算各项统计指标,为数据分析提供量化依据。
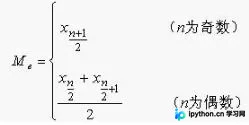
本文解析如何利用Numba库提升Python代码运行效率。通过安装配置及@jit装饰器的应用,演示了对NumPy数组和循环代码的即时编译过程。实测数据显示,启用JIT后函数执行耗时从5秒降至0.14秒,性能提升近40倍,验证了Numba在处理数值计算循环时的显著加速效果。
本文介绍如何在Python中结合Sympy与NumPy库处理函数求导问题。Sympy生成的符号导数无法直接用于数值运算,需通过evalf()和float()进行转换。文章提供了单点赋值与数组批量计算的代码示例,展示如何将符号结果代入具体数值或数组,并利用NumPy完成后续计算与绘图。
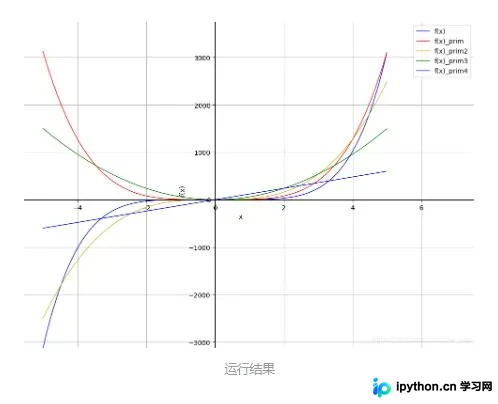
本文介绍在Python中利用NumPy库对数组进行排序并获取对应索引值的方法。通过np.sort()实现数值排序,利用np.argsort()分别获取正序和逆序的索引序列。内容涵盖一维与二维数组的处理,包括按行或按列排序的具体操作,帮助开发者快速掌握数组排序及索引提取技巧。
本文介绍Python中生成等差数列和等比数列的多种方法。重点讲解numpy库中linspace与arange的区别,以及利用itertools模块结合takewhile实现无穷数列截断的技巧。同时对比了传统类实现__iter__与生成器函数的优劣,提供高效且简洁的代码示例。
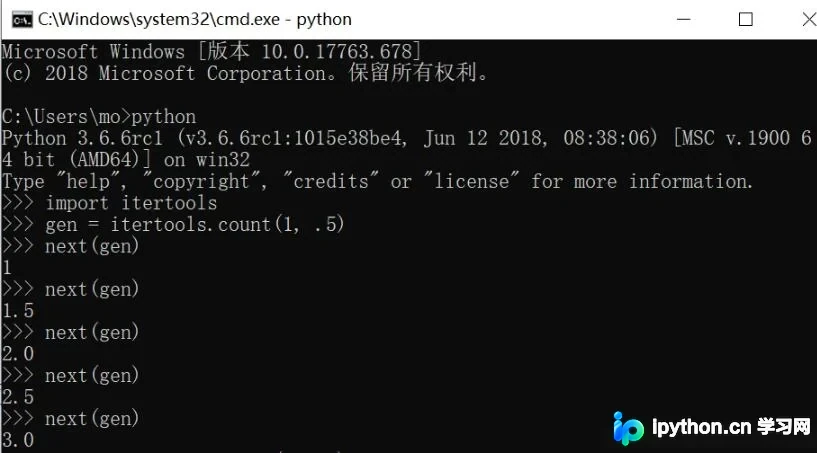
本文介绍如何使用Python生成任意频率的正弦波,并基于numpy模块的FFT函数合成矩形波和三角波。通过解析正弦与余弦函数的合成过程,展示离散傅里叶变换在信号处理中的应用,包括频谱计算、分贝可视化及波形合成实例,帮助深入理解FFT原理。
本文详细介绍Python NumPy库中数组的组合与分割方法。涵盖水平组合hstack、垂直组合vstack、深度组合dstack及行列堆叠函数,并讲解水平分割hsplit、垂直分割vsplit和深度分割dsplit的使用语法与注意事项。通过具体代码示例展示不同维度数组的操作结果,帮助开发者掌握多维数据处理技巧。
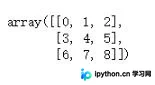
在使用Python处理大型数组或矩阵时,NumPy默认会截断输出并用省略号表示中间部分。本文介绍通过导入numpy后调用np.set_printoptions(threshold=np.inf)函数,可取消输出限制,实现完整显示所有数据。
本文详解Python Numpy中ma模块的MaskedArray类,介绍data、mask和fill_value三个核心属性,并通过代码示例演示如何生成掩膜数组及直接对ndarray进行条件运算,帮助开发者理解掩膜机制及其在数据处理中的应用。
本文介绍了在Python中利用NumPy库通过设定阈值来创建Mask数组的方法。通过简单的比较运算,可以将数组元素与指定阈值进行对比,生成对应的布尔型Mask数组,便于后续的数据筛选和处理操作。
本文介绍 Python NumPy 库中掩码数组(Masked Array)的概念与应用。掩码数组由数据数组和布尔掩码组成,用于忽略残缺或无效数据点。文章详细解析了 data、mask 和 fill_value 三个核心属性,演示了如何创建掩码数组、访问元素以及使用 filled() 方法处理填充值,帮助开发者高效处理包含空白或无法处理字符的大规模杂乱数据。
本文深入解析Python中利用NumPy库进行多项式拟合的核心方法。详细讲解np.polyfit函数的最小二乘法原理及参数设置,以及np.poly1d类在构建多项式、求值、求根和系数提取中的应用。通过正弦函数拟合示例,展示从数据生成、模型拟合到可视化绘图的完整流程,帮助开发者高效实现数据趋势分析与函数逼近。