

Python实现多个NPY文件合并与CSV批量处理指南
本文介绍如何使用Python合并多个NPY文件,通过遍历目录加载数组并使用numpy.append进行拼接保存。同时提供批量合并CSV文件的方案,利用Pandas读取文件并处理编码问题,将多个月度数据整合为单一文件,适用于数据预处理场景。
2026-10-14
6

本文介绍如何使用Python合并多个NPY文件,通过遍历目录加载数组并使用numpy.append进行拼接保存。同时提供批量合并CSV文件的方案,利用Pandas读取文件并处理编码问题,将多个月度数据整合为单一文件,适用于数据预处理场景。
本文深入解析Python中Numpy库的核心功能,涵盖ndarray对象的创建、数据类型管理及内存优化。详细演示了从列表生成、arange到文件读写的全流程,重点讲解切片、掩码及高级索引技巧,并介绍矩阵运算、统计分析及形状变换等实用操作,助力高效处理科学计算数据。
本文详细解析Numpy中两组易混淆函数的区别:resize与reshape均改变数组形状,但前者直接修改原数组,后者返回新数组;ravel与flatten均可将多维数组展平为一维,主要差异在于内存分配与视图机制。通过具体代码示例说明各函数的行为及参数设置,帮助开发者根据需求选择合适的操作。
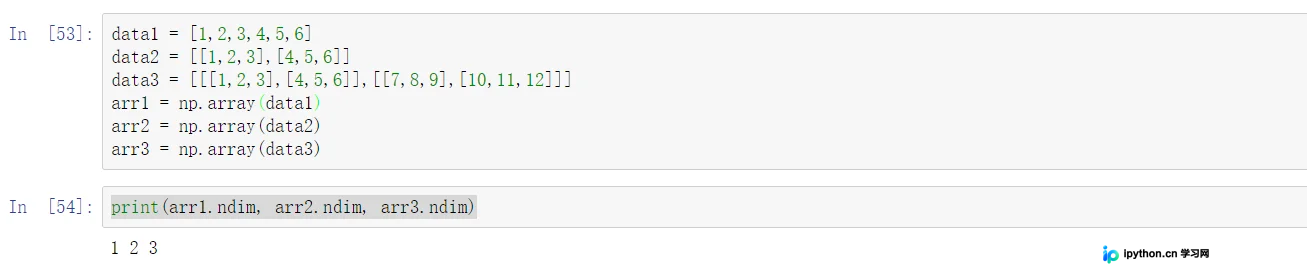
本文深入解析Numpy数组的四个核心属性与方法:ndim用于获取数组维度数,shape返回各维度大小的元组,dtype标识数据类型(如int32、float64),astype实现类型转换。内容涵盖一维至多维数组的shape理解,以及整型、浮点型、字符串间的类型转换规则与截断机制,帮助开发者准确掌握Numpy基础操作。
本文深入解析NumPy中的Fancy Indexing(高级索引)机制,涵盖一维与二维数组的索引技巧,并详细阐述数组间的比较运算。通过具体代码示例,展示如何利用布尔数组进行元素筛选、统计计数及条件过滤,帮助开发者高效处理数值数据。
本文深入探讨Python中提升计算速度的四种核心方法。通过对比原生循环、NumPy数组运算、numexpr表达式引擎及多线程技术,展示从纳秒级到秒级的性能差异。文章结合具体代码示例与基准测试结果,为数据处理和科学计算场景提供高效的性能优化方案。
本文介绍如何使用Python将纯数值型Excel数据导入并转换为矩阵。通过xlrd库读取数据,利用numpy构建矩阵。针对Excel读取数值自动转为浮点型(如111111.0)导致报错的问题,提供将Excel列格式设为文本的解决方案,确保数据格式正确。
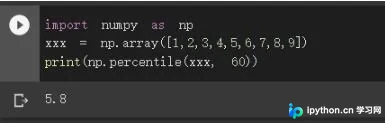
本文深入解析Python NumPy库中np.percentile函数的使用方法及底层计算逻辑。通过具体代码示例说明如何获取多维数组的任意百分比分位数,重点解读axis与keepdims参数的作用。同时,结合实例剖析线性插值算法在分位数计算中的具体过程,帮助开发者准确理解并应用该函数。
本文介绍如何在Python中使用NumPy实现类似Pandas的rolling滚动窗口功能。通过调整数组形状和步幅,利用NumPy底层C代码执行高效循环。文章详细解析了滚动窗口的参数设置、计算方法及与Pandas rolling函数的区别,并提供具体代码示例,帮助开发者在时间序列数据分析中灵活应用滚动计算。
本文解析在Python中使用pymysql获取数据库数据时,因字段类型导致数据全部转为字符串的问题。通过示例展示如何利用numpy的astype(np.float)方法将字符串数组转换为浮点数,从而正确执行数学计算,避免类型错误。
本文详解在Python中替换NumPy数组中大于特定阈值元素的多项技术。通过对比基础循环、布尔索引、np.minimum、np.clip以及np.putmask等方法的执行效率,结合MRI图像处理的实际场景,推荐在需要原地修改或限制数值范围时优先使用内置函数,以实现代码简洁性与运行速度的最佳平衡。
本文介绍如何在Python中使用NumPy计算数组按列非零元素的平均值,通过判断非零元素并求和除以数量实现。同时补充了利用Pandas DataFrame统计行列零值个数的方法,包括按行返回Series及按列返回Series的操作示例,为数据处理提供实用参考。