Python更新librosa时遇到依赖冲突怎么办
针对Python在更新音频处理库librosa时常见的依赖冲突问题,深入解析numba、llvmlite与numpy版本锁死根源,提供清晰的报错定位方法、排查流程与环境隔离解决方案。
2026-10-30
8

针对Python在更新音频处理库librosa时常见的依赖冲突问题,深入解析numba、llvmlite与numpy版本锁死根源,提供清晰的报错定位方法、排查流程与环境隔离解决方案。
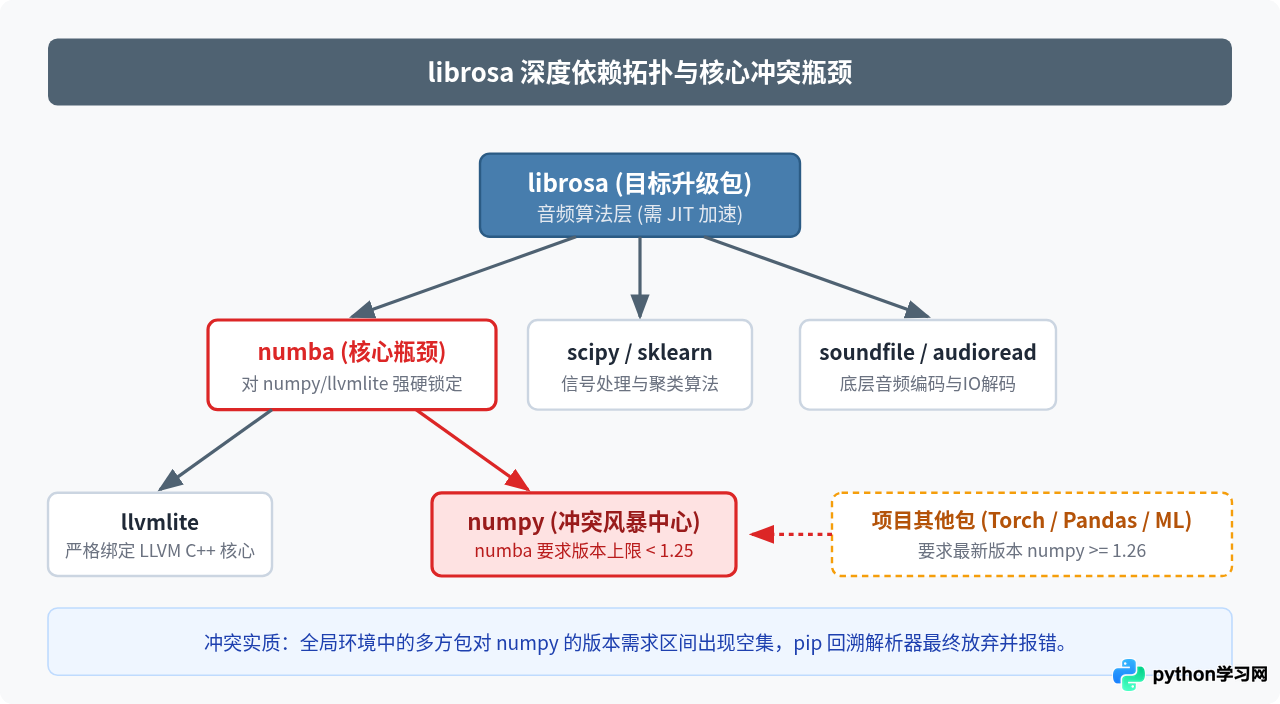
深入解析如何利用Numba的@jit与@njit装饰器加速Python数值计算型for循环,剖析CPython解释器瓶颈与LLVM JIT底层原理,提供标准化实操四步法、性能对比范例、适用边界判断及最佳实践清单。
本文通过实测对比Python中Numpy二维数组的两种遍历方式:双层循环与切片后一维遍历,并引入Numba JIT加速。结果显示,切片遍历通常更快,但Numba首次调用存在编译开销。文章详细解析了不同数据规模下的耗时差异及底层内存引用机制,为高性能计算提供实践参考。
本文深入探讨 Python 性能优化的多种技术路径,涵盖 Cython、IPython.parallel、numexpr、multiprocessing、Numba 及 NumbaPro 等工具的应用场景。通过对比列表推导、迭代器、eval、生成器及 map 函数的执行效率,并结合 NumPy 数组的 C 与 Fortran 内存布局测试,揭示不同实现方式在时间与空间复杂度上的显著差异,为开发者提供具体的性能调优参考。
本文深入对比Numba与Cython两大Python加速工具。解析Numba通过JIT将Python转为LLVM IR实现自动并行与GPU支持的优势,以及Cython通过生成C代码提供底层控制的特性。分析两者在易用性、调试难度及适用场景上的差异,帮助开发者根据项目规模选择最佳性能优化方案。
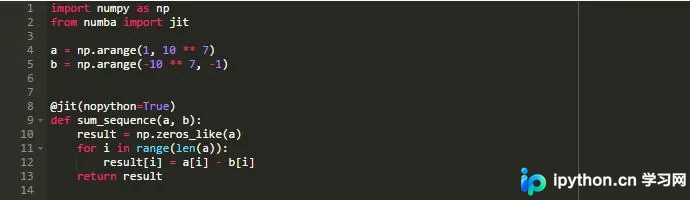
本文深入解析Python程序加速运行的核心方法。从基础层面探讨将代码封装为函数、利用局部变量优势、预绑定方法以及使用内置容器等技巧,有效减少属性查找开销。进阶部分介绍PyPy的JIT编译与Numba的LLVM加速技术,并强调在追求性能前确保逻辑正确性的重要性。
本文介绍如何使用 Numba 库通过即时编译(JIT)技术显著提升 Python 代码的执行速度。重点讲解 @jit 装饰器的用法、nopython 模式的优势,以及针对 NumPy 数组和循环密集型计算的优化策略,帮助开发者在科学计算场景中实现接近 C 语言的运行效率。
深入解析Numba即时编译(JIT)加速Python数值计算的核心工作机制,结合nopython模式、类型推断、LLVM编译管线及常用装饰器用法,提供规范的代码示例与调优排错建议。