Python在人工智能开发中的核心优势与主流库解析
本文深入探讨Python在人工智能领域的核心地位,对比Lisp、Prolog、C/C++及Java等语言的优劣,重点分析Python在文档、跨平台、易用性及开源生态方面的优势。同时列举AIMA、scikit-learn、NLTK等主流AI库,并通过员工情绪分析案例展示Python在物联网与AI结合场景下的实际应用价值。
2026-10-13
6

本文深入探讨Python在人工智能领域的核心地位,对比Lisp、Prolog、C/C++及Java等语言的优劣,重点分析Python在文档、跨平台、易用性及开源生态方面的优势。同时列举AIMA、scikit-learn、NLTK等主流AI库,并通过员工情绪分析案例展示Python在物联网与AI结合场景下的实际应用价值。
本文详细解析自然语言处理中基础的中文分词算法——前向最大匹配法。通过设定最大词长,从左至右扫描文本并与词典比对,逐步缩短候选子串直至匹配成功或转为单字。文章提供了完整的Python代码示例,演示如何读取输入文件与词典,并输出分词结果,适合NLP初学者参考学习。
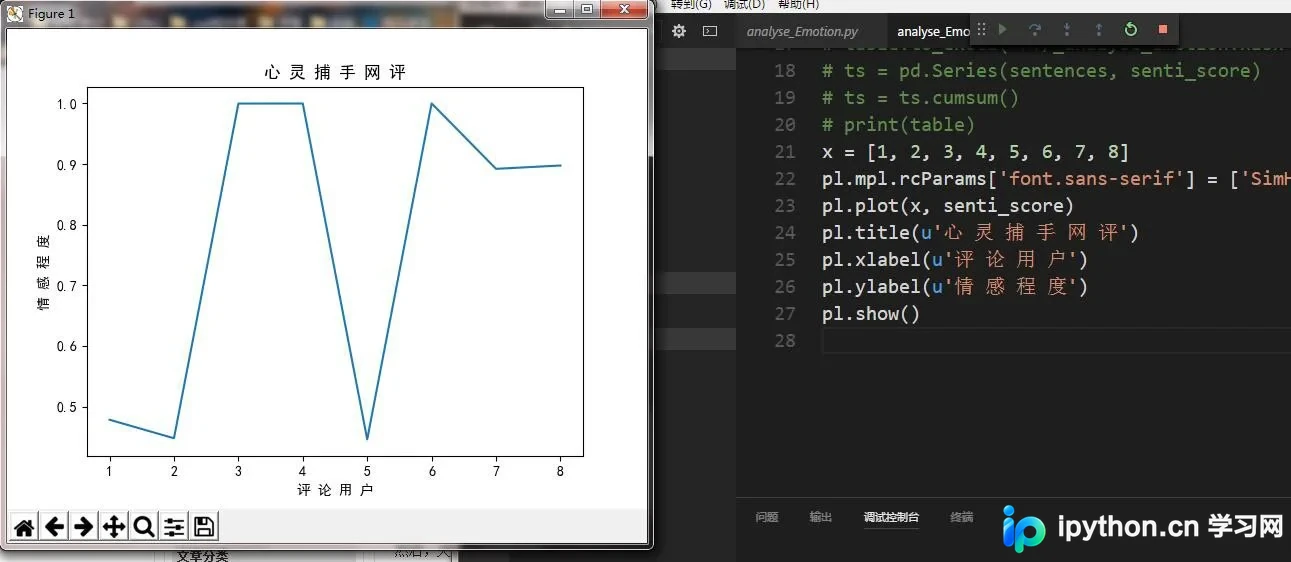
本文介绍如何使用Python库SnowNLP进行中文文本情感分析。详细讲解pip安装SnowNLP、pandas及pylab依赖模块,并通过提取《心灵捕手》豆瓣影评数据,演示从文本读取、情感评分计算到使用pylab绘制情感趋势图的全过程。旨在为初学者提供一套完整的情感分析简易Demo及参考代码。
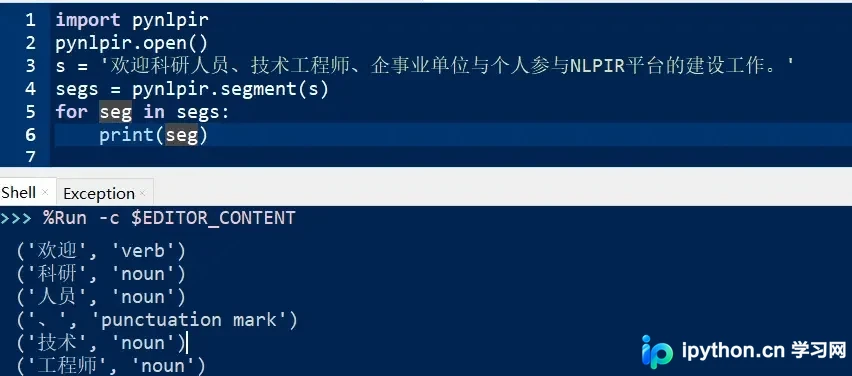
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。
本文详细演示如何使用纯Python从零构建N-gram文本生成管线。内容涵盖原始语料的标准化预处理、滑动窗口序列建模、基于上下文的随机拼接算法,以及引入Temperature参数优化输出多样性的完整代码。同时对比了传统N-gram模型的局限性,并给出向深度神经网络迁移的明确路径,适合自然语言处理初学者快速建立概率语言模型认知。
本文详解Python jieba库的安装配置及三种分词模式(精确、全、搜索引擎)的特点。通过荷塘月色案例,展示如何结合中文虚词列表进行词频统计,提供完整代码与运行结果分析,帮助开发者快速掌握中文文本处理技巧。
本文详解Python自然语言处理中的四种核心切分算法:完全切分、正向最长匹配、逆向最长匹配及双向最长匹配。通过Pyhanlp加载词典,展示各算法的代码实现与逻辑差异,帮助开发者理解中文分词原理并选择最优方案。