

Python自然语言处理之切分算法详解

发布时间:2026-10-12| 2人浏览过
在自然语言处理中,将连续文本切分为有意义的词语序列是基础且关键的一步。本文深入解析Python环境下常用的四种切分算法:完全切分、正向最长匹配、逆向最长匹配以及双向最长匹配,并通过具体代码展示其实现逻辑与适用场景。
一、前言:理解切分算法
自然语言处理的核心任务之一是对语句进行词语检测。由于一句话中往往包含多个互相重叠的词语,输出的切分结果直接取决于所采用的切分算法。常用的切分策略主要包括完全切分、正向最长匹配、逆向最长匹配以及双向最长匹配四种。
二、完全切分:穷举所有可能
完全切分的目标是找出文本中所有存在于词典中的单词。其核心逻辑是遍历文本的每一个连续子序列,并查询词典以判断该子序列是否为有效词汇。最终输出包含文本中所有可能的单字与词汇组合。
实现步骤如下:
- 加载词典:使用Pyhanlp的IOUtil加载核心词典文件(如mini.txt版本),并提取所有键名构建集合。
- 遍历子串:通过双重循环生成文本的所有连续子串。
- 匹配与存储:若子串存在于词典中,则将其加入结果列表。
from pyhanlp import *

def load_dictionary():
    IOUtil = JClass('com.hankcs.hanlp.corpus.io.IOUtil')
    path = HanLP.Config.CoreDictionaryPath.replace('.txt', '.mini.txt')
    dic = IOUtil.loadDictionary([path])
    return set(dic.keySet())

def fully_segment(text, dic):
    list = []
    for i in range(len(text)):
        for j in range(i + 1, len(text) + 1):
            temp = text[i:j]
            if temp in dic:
                list.append(temp)
    return list

if __name__ == "__main__":
    dic = load_dictionary()
    print(fully_segment("在绝对实力面前,一切的说辞都是枉然", dic))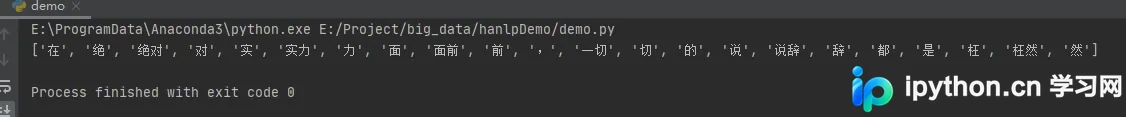
三、正向最长匹配:从左至右优先长词
中文分词旨在提取具有意义的词语序列。在最长匹配策略中,单词长度越长优先级越高。正向最长匹配(Forward Maximum Matching)从文本头部开始扫描,优先输出更长的匹配词。
算法逻辑:
- 初始化指针i指向文本起始位置。
- 在当前指针位置,尝试从短到长截取子串。
- 若截取的词存在于词典中,且长度大于当前记录的最长词,则更新最长词。
- 将找到的最长词加入结果列表,并将指针i移动该词的末尾。
def forward_segment(text, dic):
    list = []
    i = 0
    while i < len(text):
        long_word = text[i]
        for j in range(i + 1, len(text) + 1):
            word = text[i:j]
            if word in dic:
                if len(word) > len(long_word):
                    long_word = word
        list.append(long_word)
        i += len(long_word)
    return list
四、逆向最长匹配:从右至左优化效率
逆向最长匹配(Backward Maximum Matching)同样遵循长度优先原则,但扫描方向是从文本尾部向头部进行。尽管最终输出的词语顺序仍保持语句原有的逻辑顺序,但逆向匹配通常在处理某些特定语境时比正向匹配更节约时间。
实现要点:
- 指针i从文本最后一个字符开始向前移动。
- 在当前位置,尝试从短到长(相对于剩余文本)截取子串。
- 一旦找到词典中存在的词,立即记录并跳出内层循环(因为逆向匹配遇到第一个匹配即为该位置最长匹配)。
- 将词加入列表,指针i向前移动该词的长度。
def backward_segment(text, dic):
    list = []
    i = len(text) - 1
    while i >= 0:
        long_word = text[i]
        for j in range(0, i):
            word = text[j:i + 1]
            if word in dic:
                if len(word) > len(long_word):
                    long_word = word
                    break
        list.append(long_word)
        i -= len(long_word)
    return list
五、双向最长匹配:融合策略
双向最长匹配(Bidirectional Maximum Matching)旨在融合正向和逆向两种方法的优势。它同时执行正向和逆向最长匹配,并根据结果数量和质量决定最终输出。
决策规则:
- 若正向切分得到的词数少于逆向切分,则返回正向结果。
- 若正向词数多于逆向,则返回逆向结果。
- 若词数相同,则比较单字(长度为1的词)的数量。单字越少,说明切分出的词汇越丰富,因此优先返回单字较少的那个结果。
#统计单字个数
def count_single_char(list):
    return sum(1 for word in list if len(word) == 1)

#双向匹配算法
def bidirectional_segment():
    f = forward_segment("在绝对实力面前,一切的说辞都是枉然", dic)
    b = backward_segment("在绝对实力面前,一切的说辞都是枉然", dic)
    if len(f) < len(b):
        return f
    elif len(f) > len(b):
        return b
    else:
        if count_single_char(f)<count_single_char(b):
            return f
        else:
            return b
以上就是Python自然语言处理中四种常见切分算法的详细内容,更多关于Python分词技术、Pyhanlp使用及NLP算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









