Python TensorFlow 入门指南:从安装到 CNN 实战
本文深入解析 TensorFlow 的核心优势与应用场景,提供详细的安装配置指南,涵盖 CPU 与 GPU 版本验证。通过张量操作、计算图构建及 Dataset API 使用,展示模型训练全流程。重点演示基于 MNIST 数据集的卷积神经网络(CNN)实战,包括数据预处理、模型构建、训练评估及预测,助力开发者掌握 AI 开发技能。
2026-10-12
6

本文深入解析 TensorFlow 的核心优势与应用场景,提供详细的安装配置指南,涵盖 CPU 与 GPU 版本验证。通过张量操作、计算图构建及 Dataset API 使用,展示模型训练全流程。重点演示基于 MNIST 数据集的卷积神经网络(CNN)实战,包括数据预处理、模型构建、训练评估及预测,助力开发者掌握 AI 开发技能。
本文详细介绍Python中两种主流的关键词提取技术:TF-IDF与TextRank。通过解析词频-逆文档频率原理及基于图排序的TextRank算法,结合jieba库实现代码示例,对比两者在提取民营企业、贷款等关键词时的权重差异,帮助开发者根据场景选择最优方案。
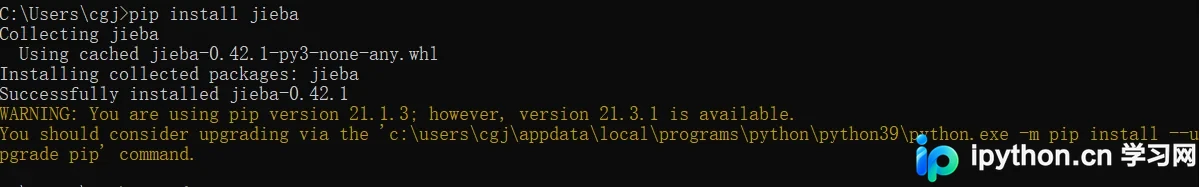
本文详解Python jieba库的安装配置及三种分词模式(精确、全、搜索引擎)的特点。通过荷塘月色案例,展示如何结合中文虚词列表进行词频统计,提供完整代码与运行结果分析,帮助开发者快速掌握中文文本处理技巧。
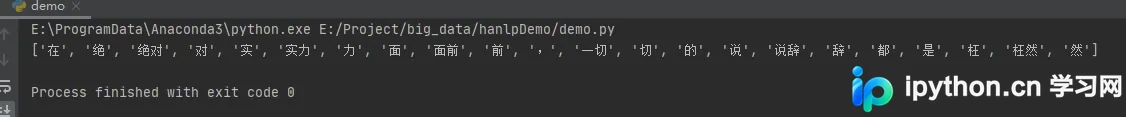
本文详解Python自然语言处理中的四种核心切分算法:完全切分、正向最长匹配、逆向最长匹配及双向最长匹配。通过Pyhanlp加载词典,展示各算法的代码实现与逻辑差异,帮助开发者理解中文分词原理并选择最优方案。
本文详细演示如何使用纯Python从零构建N-gram文本生成管线。内容涵盖原始语料的标准化预处理、滑动窗口序列建模、基于上下文的随机拼接算法,以及引入Temperature参数优化输出多样性的完整代码。同时对比了传统N-gram模型的局限性,并给出向深度神经网络迁移的明确路径,适合自然语言处理初学者快速建立概率语言模型认知。
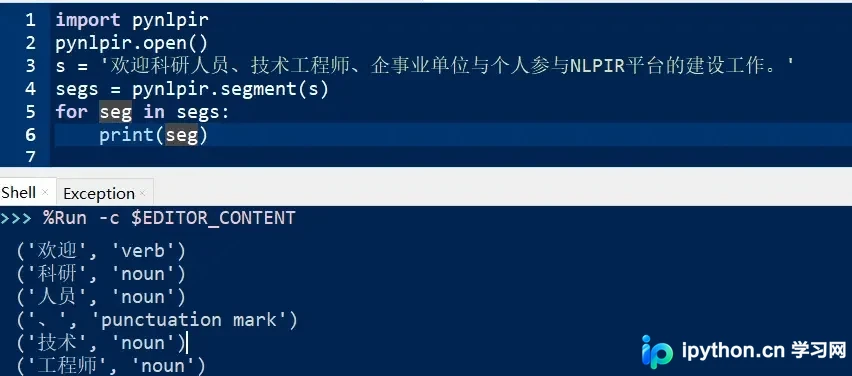
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。
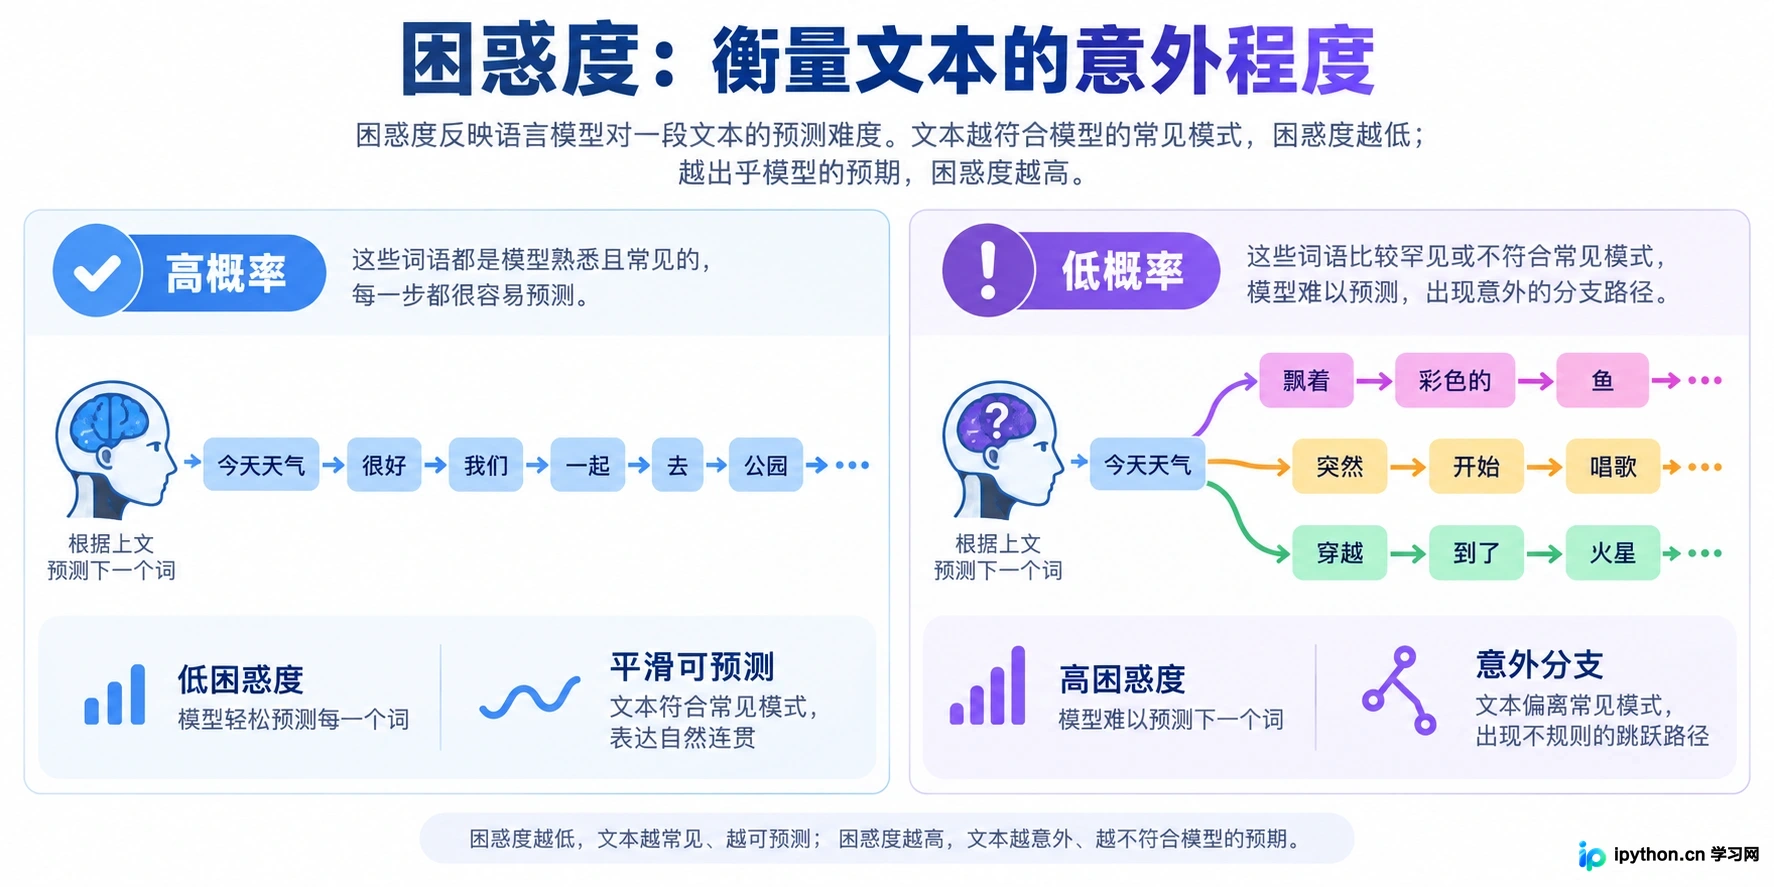
本文深入解析AI写作检测背后的核心逻辑,重点阐述困惑度(Perplexity)与突发性(Burstiness)两大指标如何区分人类与机器文本。通过场景化分析,揭示AI生成内容在概率预测和句式节奏上的特征,帮助用户理解检测工具的原理及其局限性,从而更理性地看待检测结果。