MySQL数据库性能优化:索引原理、创建与存储引擎选择
本文详细解析MySQL数据库性能优化的核心手段,包括B+树索引原理及适用场景。涵盖主键、唯一、普通及全文索引的创建与维护,深入探讨多列索引的最左匹配原则、LIKE查询陷阱及OR语句对索引的影响。同时对比InnoDB与MyISAM存储引擎特性,提供大批量插入、GROUP BY排序优化等实用SQL技巧,助您提升查询效率并保障数据安全。
2026-10-14
4

本文详细解析MySQL数据库性能优化的核心手段,包括B+树索引原理及适用场景。涵盖主键、唯一、普通及全文索引的创建与维护,深入探讨多列索引的最左匹配原则、LIKE查询陷阱及OR语句对索引的影响。同时对比InnoDB与MyISAM存储引擎特性,提供大批量插入、GROUP BY排序优化等实用SQL技巧,助您提升查询效率并保障数据安全。
本文介绍在 PHP 中使用 MySQL 数据库实现事务处理的经典方法。通过 mysql_query 发送 START TRANSACTION、ROLLBACK 和 COMMIT 指令,确保数据操作的原子性。重点解析 InnoDB 引擎要求及多回滚场景下的行为差异,帮助开发者掌握基础事务控制逻辑。
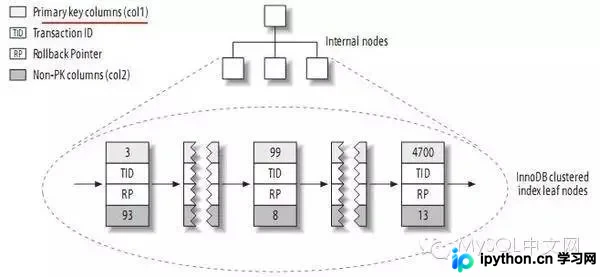
本文详解 MySQL InnoDB 存储引擎中的聚集索引(聚簇索引)概念。阐述其通过主键逻辑顺序决定数据物理存储顺序的特性,对比索引组织表(IOT)与堆组织表(HOT)的性能差异。梳理 InnoDB 自动选择聚集索引的三条核心规则,分析其对范围查询、更新碎片及回表开销的影响。
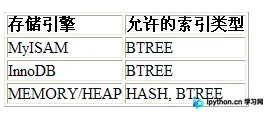
本文详细对比MySQL中常用的MyISAM、InnoDB和NDBCluster三种存储引擎的特性。重点分析它们在事务支持、锁定机制、缓存能力及适用场景上的差异,并提供针对各引擎的最佳实践配置建议,帮助开发者根据业务需求(如高并发读取、事务一致性或分布式部署)做出正确选型。
本文介绍在MySQL InnoDB引擎数据库中,针对没有设置主键或唯一索引的表进行异常数据恢复的方法。通过创建包含无主键模拟表的测试环境,利用innodb_file_per_table特性配合stream_parser等工具解析ibdata1文件,提取数据字典后定位GEN_CLUST_INDEX(隐式聚簇索引),最终使用c_parser将底层的page记录还原为可读文本及SQL插入语句,实现高效的数据找回。
本文详细解析MySQL外键约束的使用条件、定义语法及级联操作。重点说明只有InnoDB引擎支持外键,并通过代码演示如何通过ON DELETE/UPDATE实现数据完整性保护。涵盖外键添加、删除及实际应用场景,帮助开发者正确设计关系型数据库结构。
本文深入解析MySQL InnoDB存储引擎的锁机制,涵盖共享锁(S)、排他锁(X)及其兼容性,意向锁(IS/IX)的作用,以及MVCC非锁定读原理。详细对比Record Lock、Gap Lock和Next-Key Lock三种锁算法,阐述其在解决脏读、不可重复读和幻像问题中的应用,并介绍死锁检测与超时处理策略,帮助开发者优化高并发场景下的数据库性能。
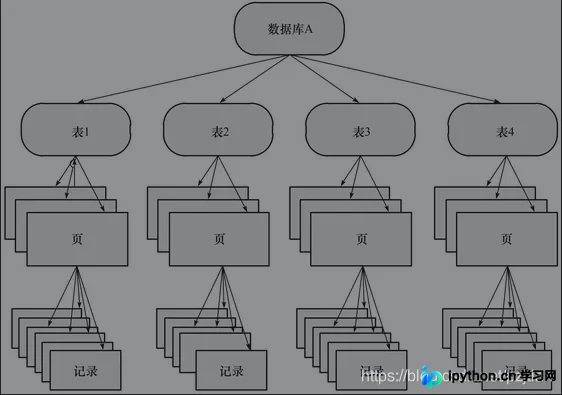
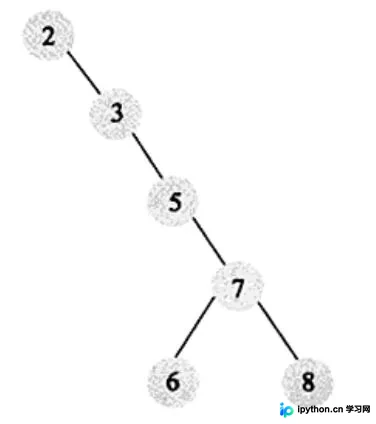
本文详细解析MySQL InnoDB存储引擎的索引机制,重点阐述为何选择B+树作为底层数据结构。通过对比二叉查找树、B树与B+树的区别,分析B+树在磁盘IO效率、查询稳定性及范围查询方面的优势,并深入讲解聚集索引与辅助索引(非聚集索引)的物理存储差异及其应用场景。
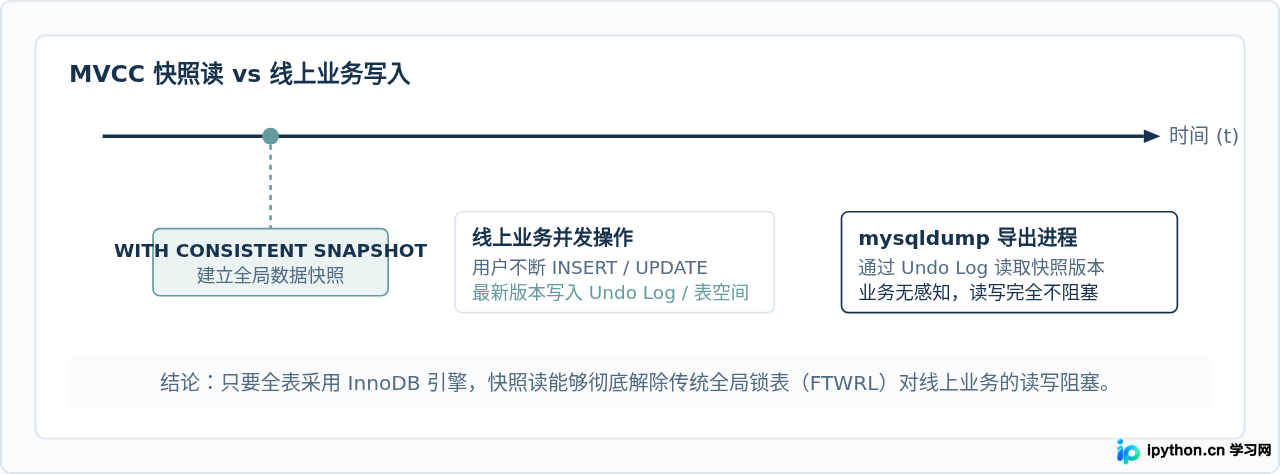
详细讲解在MySQL生产环境下,如何利用mysqldump的--single-transaction机制实现业务不停机、不锁表的一致性逻辑备份,涵盖核心原理、标准命令、操作步骤、潜在陷阱与排查避坑。
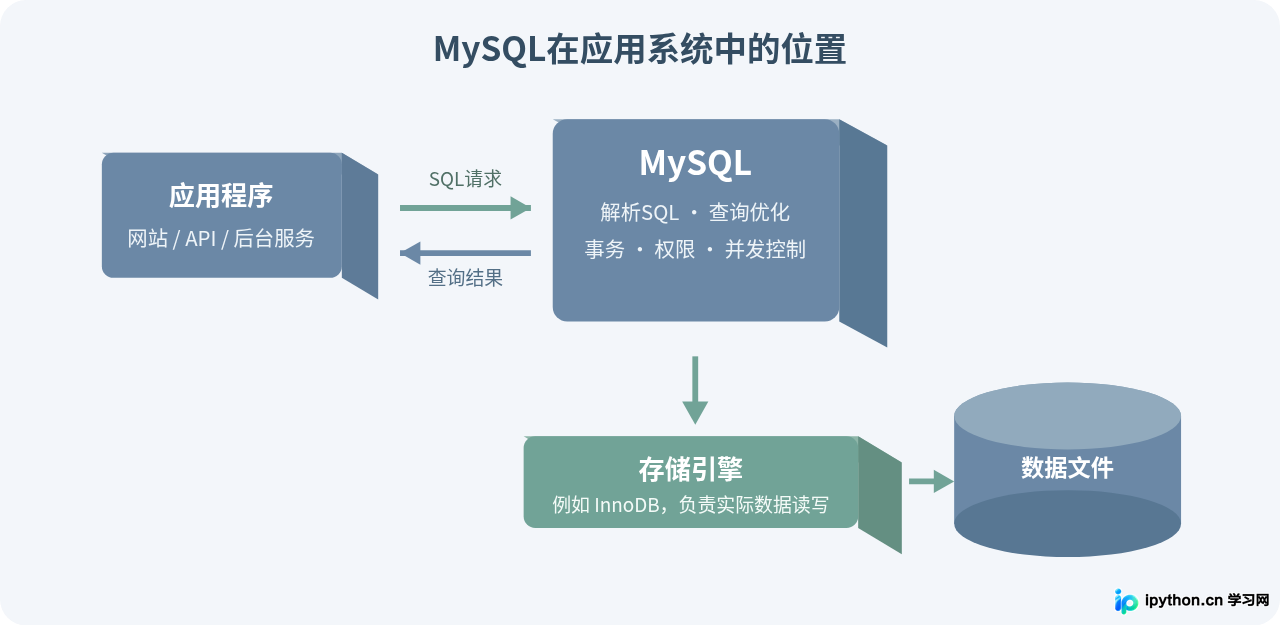
详细介绍MySQL是什么、关系型数据库如何存储数据、MySQL的基本架构、SQL执行过程、表与关系的概念,以及MySQL适合哪些应用场景和初学者应该掌握的基础操作。
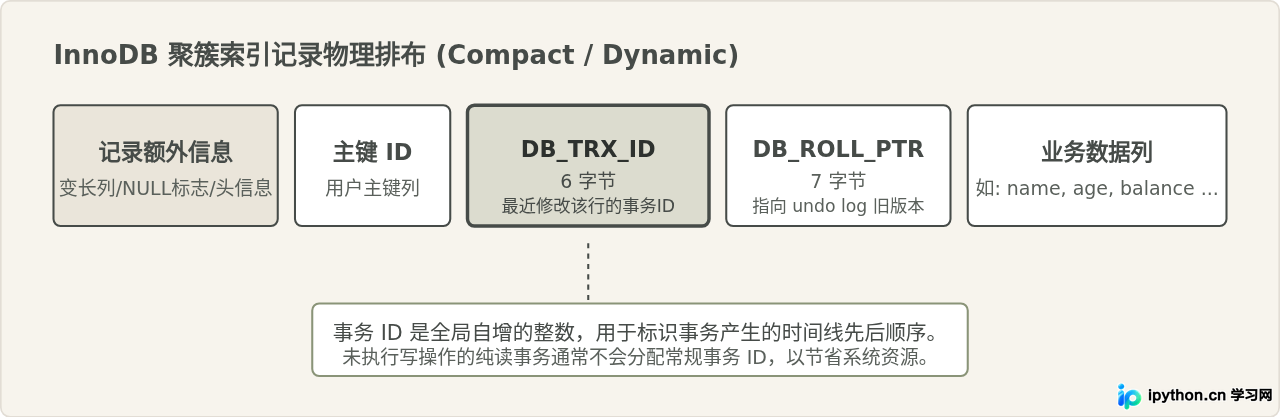
深入探讨MySQL InnoDB存储引擎中隐藏字段DB_TRX_ID的核心原理,结合undo log版本链与ReadView可见性判断规则,全面解析多版本并发控制的运行机制与边界细节。
深入解析为什么在业务架构中优先选择MySQL,从开源协议与成本控制、可插拔存储引擎、B+树聚簇索引以及内存缓冲机制四个维度,系统剖析其开源免费与高性能的核心技术支撑。