

MySQL 模拟自增序列(Sequence)实现方案
由于 MySQL 原生不支持 Sequence,可通过创建管理表及对应的获取当前值、下一个值、设置值的三个存储函数来模拟。本文提供完整的 SQL 代码及 Java 调用示例,解决多线程环境下流水号唯一性问题。
2026-10-13
6

由于 MySQL 原生不支持 Sequence,可通过创建管理表及对应的获取当前值、下一个值、设置值的三个存储函数来模拟。本文提供完整的 SQL 代码及 Java 调用示例,解决多线程环境下流水号唯一性问题。
本文详解如何在MySQL中使用触发器进行数据迁移和同步。重点解析从SQL Server移植逻辑时的常见错误,即AFTER更新导致的死循环问题。通过切换至BEFORE模式直接修改NEW值,成功解决自触发风险,并展示监控删除操作及备份日志的完整代码示例。
本文深入解析MySQL触发器的基本概念与核心应用场景,包括数据审计、完整性约束及自动计算。详细阐述CREATE TRIGGER语法结构、DEFINER权限控制以及NEW/OLD变量的使用规则。通过用户表同步实例演示触发器的创建、测试流程,并介绍SHOW TRIGERS命令及information_schema库进行触发器管理的标准方法,帮助开发者掌握数据库逻辑封装技巧。
本文详解MySQL主键索引(PRIMARY KEY)与辅助索引(SECONDARY KEY)的核心区别。重点阐述InnoDB引擎下主键作为聚集索引的性能优势,以及MyISAM与InnoDB在索引存储结构上的差异。提供基于自增列、唯一性的主键设计三原则,并对比不同索引类型在百万级数据检索中的性能损耗数据。
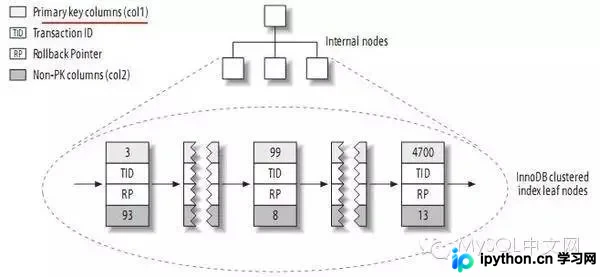
本文详解 MySQL InnoDB 存储引擎中的聚集索引(聚簇索引)概念。阐述其通过主键逻辑顺序决定数据物理存储顺序的特性,对比索引组织表(IOT)与堆组织表(HOT)的性能差异。梳理 InnoDB 自动选择聚集索引的三条核心规则,分析其对范围查询、更新碎片及回表开销的影响。
本文详细介绍MySQL查询缓存的开启条件,包括配置文件参数 query_cache_type 的三种模式(OFF、ON、DEMAND),以及通过 SHOW VARIABLES 查看状态。重点解析 show status like 'qcache%' 中 Qcache_free_blocks 等核心指标的含义。最后说明如何利用 FLUSH QUERY CACHE 清理碎片或 FLUSH TABLES 清空缓存,帮助开发者根据实际场景优化数据库性能。
在并发场景下,多个线程使用 SELECT ... FOR UPDATE 可能因索引锁定顺序不一致产生死锁。当未提交的事务修改了非主键索引值(如状态字段),后续查询即使过滤掉该行,也会因不确定性而阻塞。通过分析执行顺序、统一加锁路径及监控长事务,可有效避免此类问题。
本文详解MySQL中UPDATE语句的基础语法,包括单字段、多字段及空值更新。针对百万级数据更新导致的执行缓慢问题,通过对比测试验证使用INSERT...SELECT结合JOIN的方式可大幅缩短执行时间(从数十分钟降至十几秒),为高并发或大数据量场景下的表结构重构与数据填充提供高效解决方案。
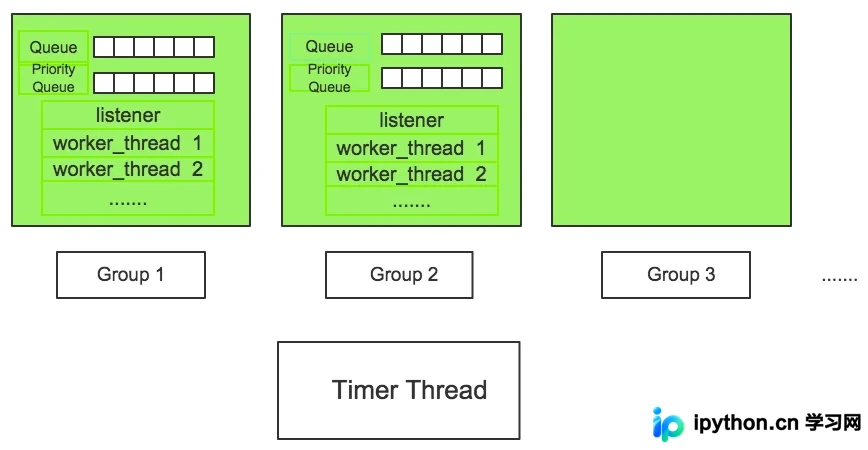
本文详细解析MySQL 5.6引入的线程池功能,对比传统的One-Connection-Per-Thread模型,阐明其如何通过预创建工作线程、多路复用IO(Epoll)及优先级队列机制,有效降低高并发下的上下文切换与系统抖动。同时探讨调度死锁解决策略、大查询处理优化以及线程池与客户端连接池的协同关系,为数据库高性能调优提供底层参考。
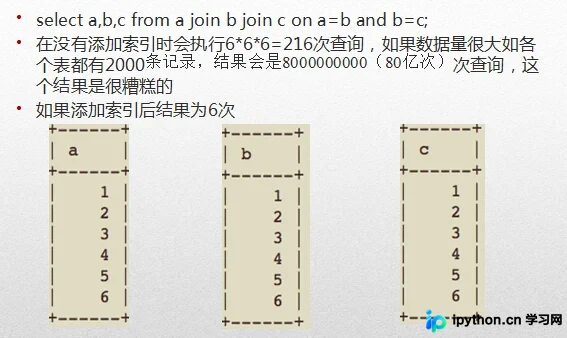
本文深入解析 MySQL 索引的底层原理,详细介绍 B-Tree、哈希等算法及四种索引类型。通过 EXPLAIN 命令详解执行计划各字段含义,指导开发者识别全表扫描并优化查询。重点阐述组合索引的最左前缀匹配原则、前缀索引技巧,以及函数运算、模糊查询和 OR 条件等导致失效的场景,帮助提升数据库检索性能。
针对MySQL中OR、IN与UNION ALL的查询效率,实测发现其表现高度依赖索引情况。在索引列上三者差异极小,EXPLAIN显示ref优于range;而在非索引列的全表扫描场景下,UNION ALL因多次扫描导致耗时成倍增加。建议根据是否使用索引选择最优语句,避免盲目使用UNION ALL。
本文详解MySQL中主键的声明方式,包括建表时添加和ALTER TABLE修改,以及单列与组合主键的应用。重点讲解如何利用AUTO_INCREMENT属性实现主键自动增长,并演示结合DEFAULT CURRENT_TIMESTAMP自动记录创建时间的完整实战案例,帮助开发者快速掌握唯一标识与时间戳的管理技巧。