

MySQL通过当前排序字段获取相邻数据项及同表计算
本文介绍如何在MySQL中利用UNION联合查询获取指定ID的上下相邻记录,适用于弹窗翻页场景。针对同一张表中关联订单的相邻数据计算(如首单与二单时间差),提供基于自连接、COUNT过滤及SUBSTRING_INDEX函数的多种解决方案,涵盖原理与完整示例代码。
2026-10-15
6

本文介绍如何在MySQL中利用UNION联合查询获取指定ID的上下相邻记录,适用于弹窗翻页场景。针对同一张表中关联订单的相邻数据计算(如首单与二单时间差),提供基于自连接、COUNT过滤及SUBSTRING_INDEX函数的多种解决方案,涵盖原理与完整示例代码。
面对高并发和数据量增长,MySQL 分库分表是提升性能的关键手段。本文详细解析垂直拆分与水平拆分的逻辑、优缺点及适用场景,对比 ShardingSphere 与 MyCAT 等主流中间件的直连与代理层差异,并提供分布式事务、全局 ID 及跨库 Join 等核心问题的处理思路,帮助开发者根据业务特性选择最佳架构方案。
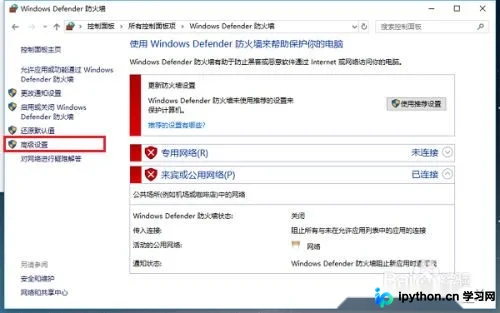
本文记录如何在本地及远程环境中开放MySQL数据库的外网访问权限。主要步骤包括通过SQL命令修改用户Host属性为'%'并赋予所有权限,以及在Windows系统防火墙中创建入站规则放行3306端口。操作前请务必备份数据,注意网络安全风险。
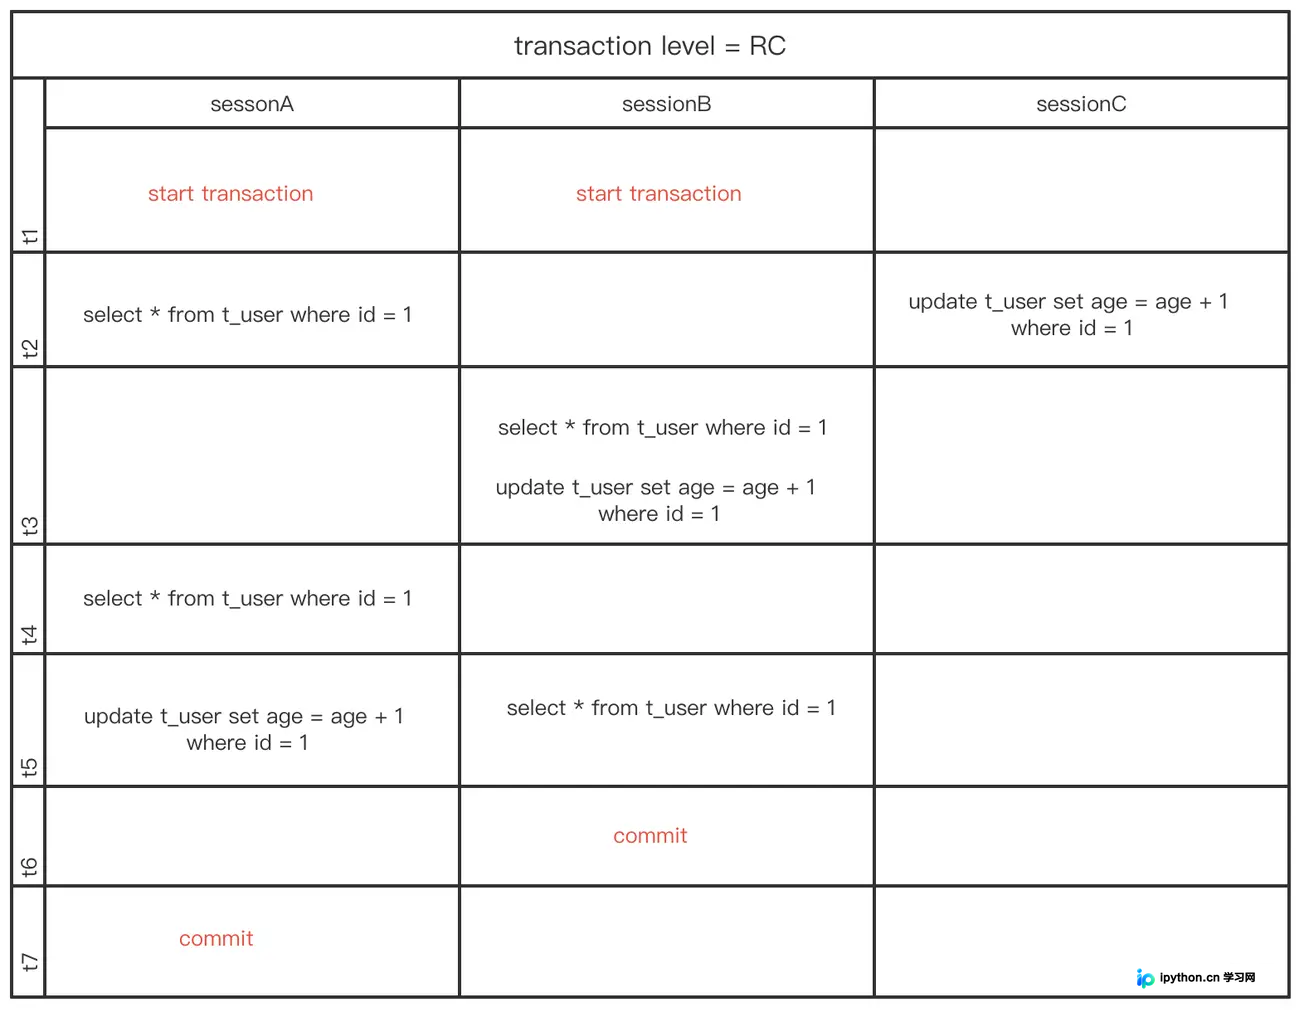
深入解析MySQL InnoDB引擎的MVCC(多版本并发控制)原理,区分当前读与快照读。通过Session A/B/C的并发操作案例,演示RC与RR隔离级别下的视图生成、一致性读及锁等待超时现象,揭示Undo Log、Redo Log在ACID中的角色。
在使用Pandas读取MySQL数据并进行处理后,若DataFrame中存在无穷大(inf)值,直接写入数据库会触发ProgrammingError。本文详细解析了inf产生的原因(如除以零),并提供了利用numpy和Pandas将正负无穷替换为空值或具体数值的具体代码方案,确保数据能顺利写入数据库。
本文详解MySQL字符集工作原理,重点解析client、connection、server及results四层交互机制。通过set names gbk指令统一客户端写入与服务器读取编码,解决乱码问题,并提供查看变量与插入中文数据的完整实操示例。
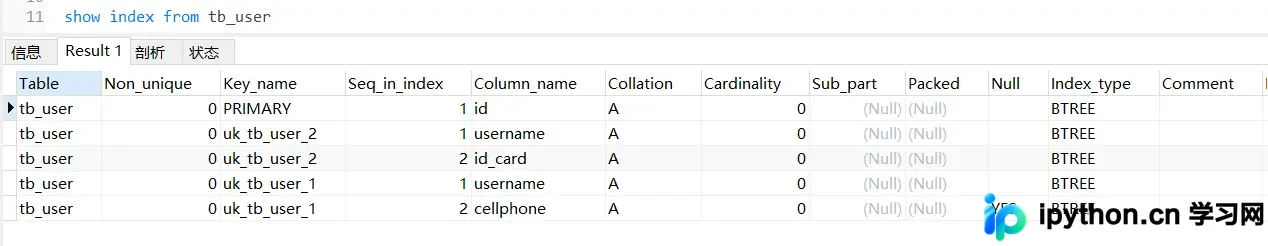
本文详细解析MySQL数据库索引的核心数据结构B+树,区分聚集索引与辅助索引的实现差异。通过SQL示例展示索引创建与管理,深入探讨联合索引的最左前缀原则及覆盖索引避免回表的优化技巧,帮助开发者提升查询效率。
本文介绍在 Linux CentOS 7 环境下,通过解压安装方式部署 MySQL 8.0.20 单机多实例(3306/3307/3308)的完整流程。涵盖目录规划、权限配置、my.cnf 多实例参数设置、初始化及环境变量配置,并提供启动检查与远程访问权限调整的安全操作指南。
本文详解 MySQL 分页查询的核心原理,对比真分页与假分页的适用场景。重点讲解 LIMIT 参数的计算逻辑及总页数公式,并总结 8 种常见分页 SQL 写法。针对数据量增长带来的性能瓶颈,提供基于索引定位、子查询等高效优化方案,帮助开发者在实际项目中实现快速、稳定的分页功能。
本文提供一个完整的MySQL存储过程开发示例,涵盖事务管理、OUT输出参数传递以及利用游标处理增量数据同步的核心逻辑。代码演示了如何通过嵌套调用分离主流程与数据处理,确保在发生异常时自动回滚,并根据操作类型(插入、更新、删除)精准执行数据变更,适用于需要同步影子表数据的场景。
在MySQL开发中,即使建立了指索,查询依然缓慢往往是因索引失效所致。本文深入剖析导致索引失效的七种典型场景:字段类型隐式转换、表达式计算、使用内置函数、左模糊匹配、违背最左前缀原则、OR条件缺失索引以及IN/NOT IN的影响。通过EXPLAIN分析执行计划,可精准定位问题并制定优化策略。
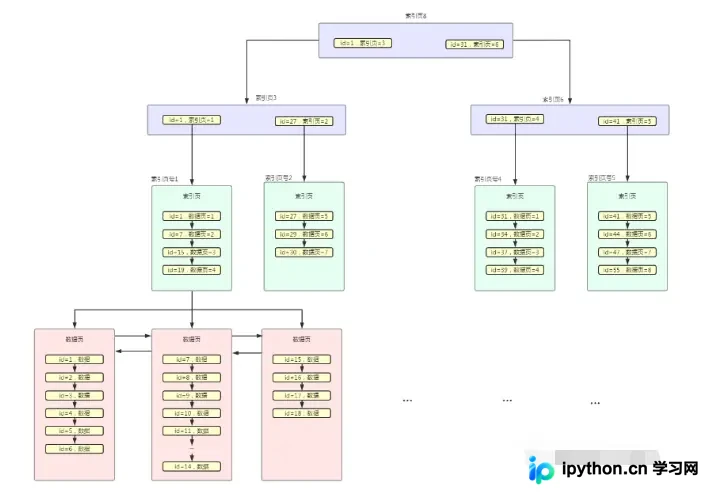
在MySQL数据库中,版本号字符串(如“2.7.6”)无法直接通过字符串比较判断大小。本文介绍一种利用SUBSTRING_INDEX、LPAD和CONCAT组合函数提取并填充各段数值的方法,将可变长度版本号转为固定格式字符串,从而实现准确的数值逻辑比对。