SQL Server数据库批量导入数据的四种常用方法详解

本文总结SQL Server中批量导入数据的四种核心方法。通过SELECT INTO实现同库表间快速复制;利用Excel作为中间工具进行数据清洗后导入;借助SQL Server Integration Services (SSIS)图形化界面或编程接口完成复杂转换与高效ETL;使用OPENQUERY与OPENROWSET直接连接Oracle等异构数据库并过滤数据。根据数据量、源库类型及清洗需求选择合适的导入策略。

SQL UNION 与 UNION ALL 的区别及用法详解

本文详细解析SQL中UNION与UNION ALL操作符的核心区别。UNION用于合并结果集并自动去除重复行,而UNION ALL则保留所有数据包括重复值。文章通过Employees_China与Employees_USA表的对比示例,清晰展示两种语法在实际应用中的不同表现及注意事项。

SQL Server bcp 命令详解与高效数据导入导出实战

bcp是SQL Server提供的高效命令行批量复制工具,适用于大批量数据的快速导入导出。本文详细解析bcp的核心参数(如in/out/queryout、-c/-w字符类型、认证连接等),演示如何通过控制台直接执行或使用xp_cmdshell在存储过程中调用。内容涵盖整表/视图导出、SQL查询过滤导出、XML/普通格式文件的生成与利用,以及导入时的行范围控制和空值处理,帮助DBA和开发人员实现自动化数据迁移。

SQL Server中EXCEPT与NOT IN的性能差异及最佳实践

本文深入解析 SQL Server 中 EXCEPT 与 NOT IN 运算符在数据去重场景下的性能差异。通过实际测试发现,在小数据量下两者差异不大,但随着数据量增加,EXCEPT 凭借 Merge Join 机制展现出更优的执行效率,而 NOT IN 则可能因 Null 值处理产生额外开销。文章结合执行计划分析,揭示了统计数据和索引对性能的关键影响,为生产环境中的查询优化提供实操建议。

Go语言实现雪花算法分布式ID与分布式锁

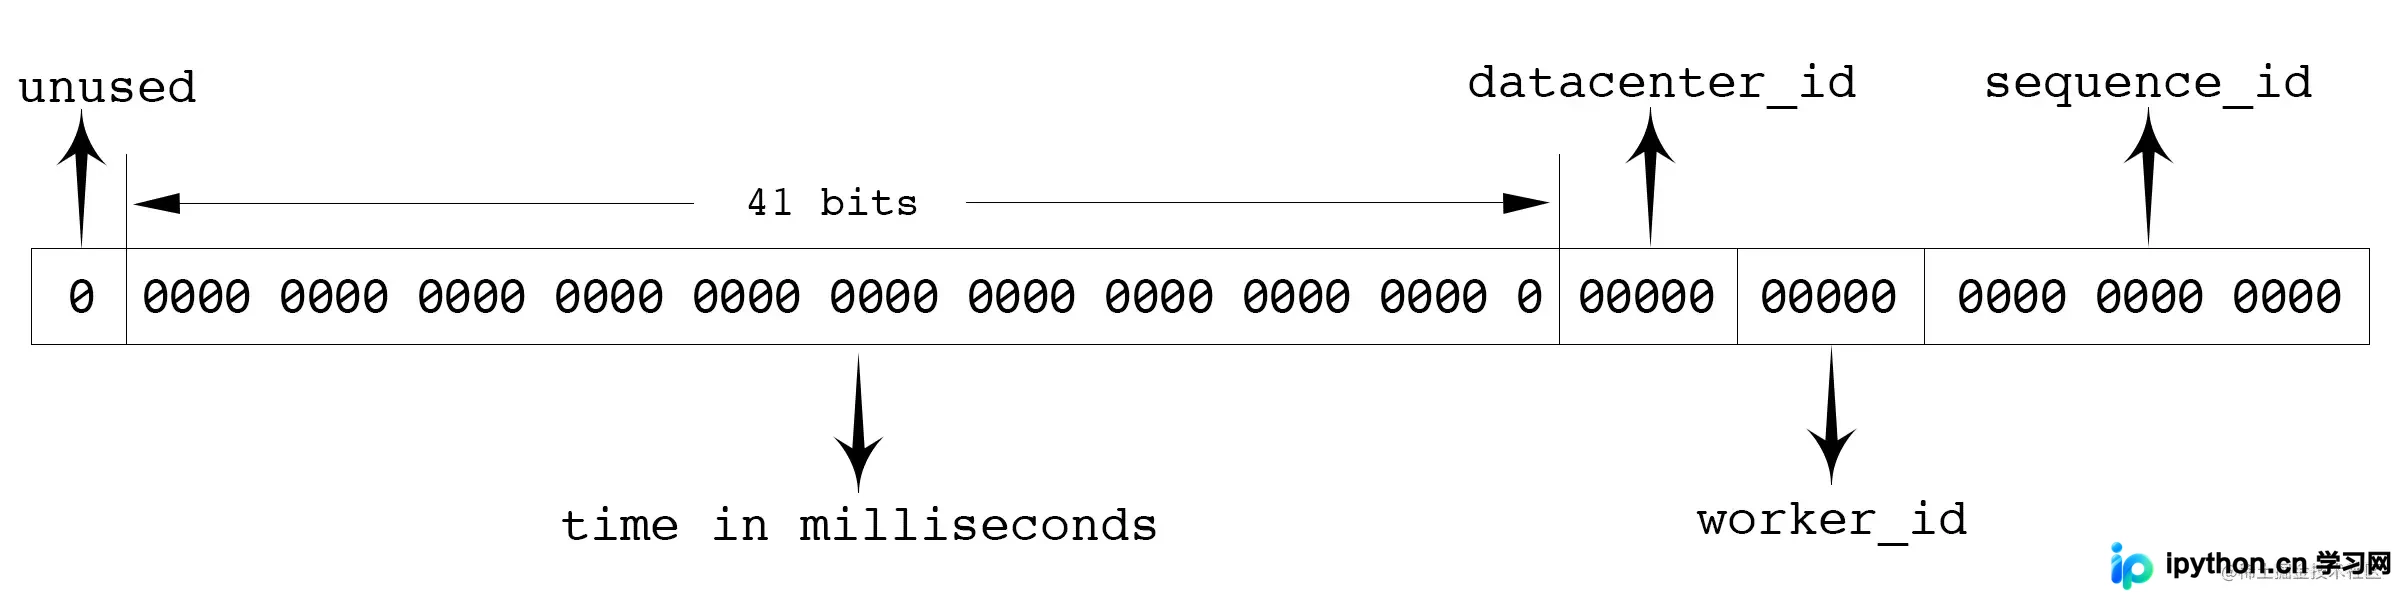
本文详解在Go语言中实现高并发场景下的唯一ID生成与资源竞争控制。重点介绍Snowflake(雪花算法)的64位ID结构原理,包括时间戳、机器ID分配策略及bwmarrin/snowflake库的使用。同时对比三种分布式锁方案:进程内互斥锁、基于Redis SETNX的非阻塞锁以及基于ZooKeeper的强一致阻塞锁,分析各自适用场景与代码实现。

Go语言实现雪花算法分布式ID与分布式锁