

Go语言实现雪花算法分布式ID与分布式锁

在电商大促等高并发分布式系统中,生成全局唯一且有序的业务ID,以及精准控制并发资源的访问是核心需求。本文将深入解析Go语言中经典的雪花算法(Snowflake),涵盖其64位ID构成、Worker ID获取策略及主流开源库用法,并详细对比进程内Mutex、Redis SETNX和ZooKeeper三种分布式锁的实现逻辑与性能差异。
分布式ID生成器
在微服务架构或大型分布式系统中,数据库分库分表导致单点自增ID不再可用。此时需要一种机制,在保证高性能的前提下,生成全局唯一的业务ID。理想的分布式ID应满足单调递增、包含时间信息(便于排序)以及高可用的特点。
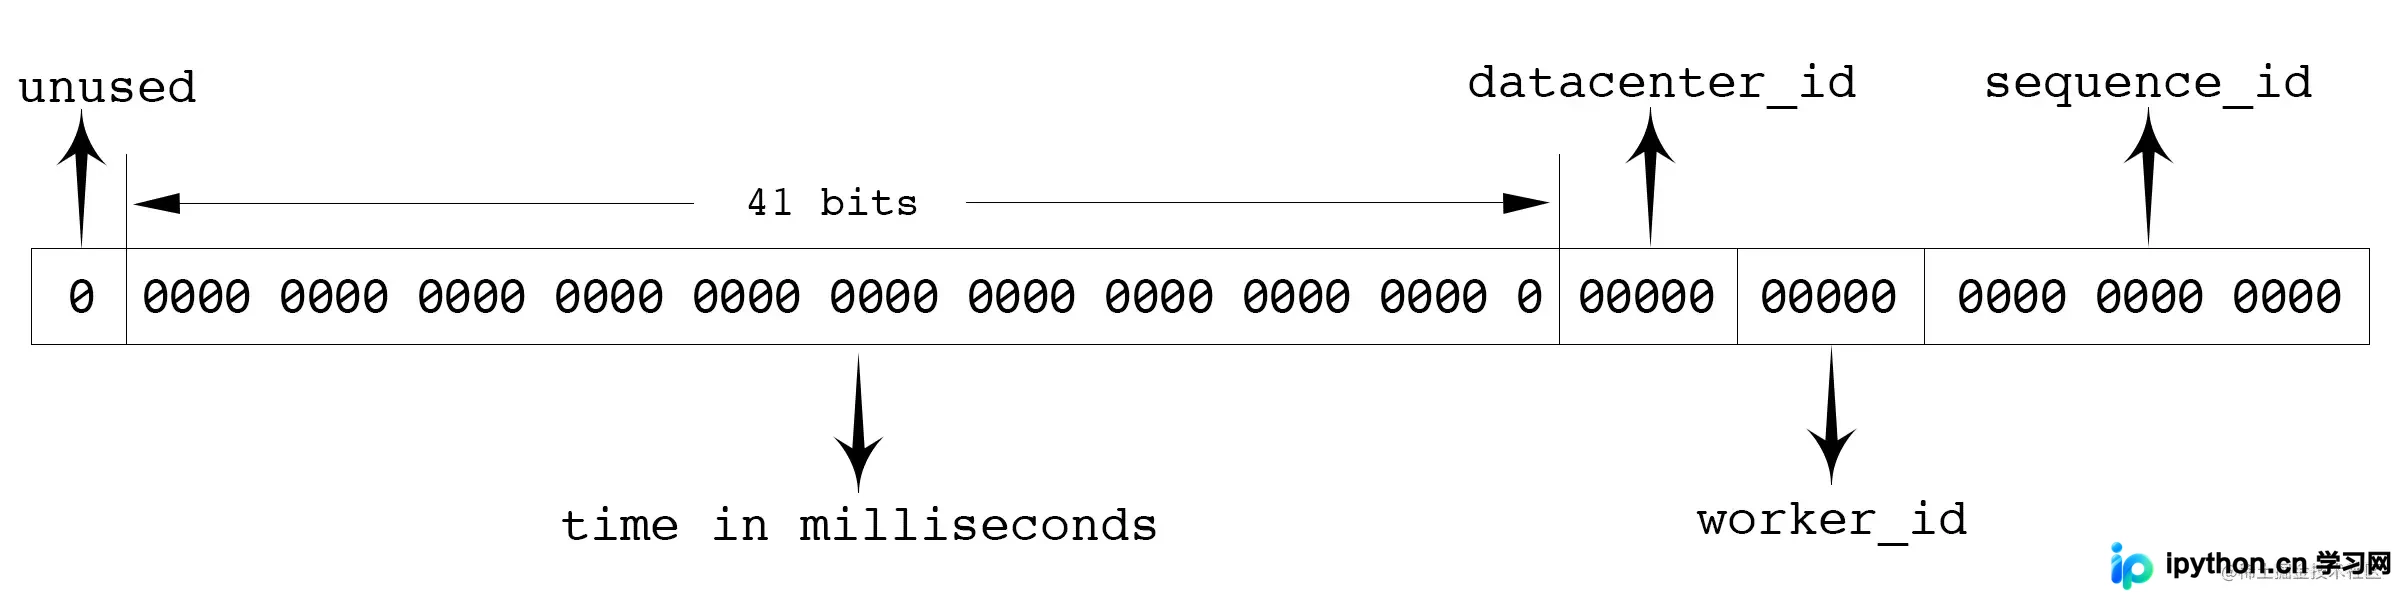
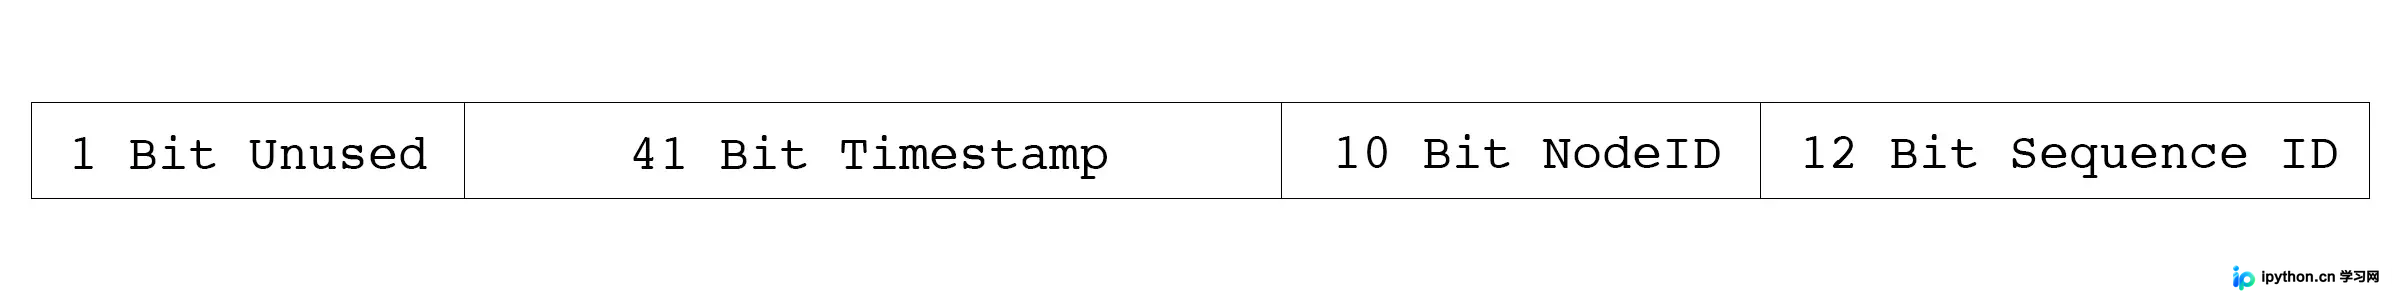
目前业界最主流的解决方案是Twitter提出的雪花算法(Snowflake)。该算法生成的ID是一个64位的long型数据,除去最高位的符号位为0,剩余63位用于实际标识。标准的结构划分如下:
- 1位符号位:固定为0,确保生成的数字为正数。
- 41位时间戳:记录毫秒级时间戳。由于41位二进制可表示约2的41次方毫秒,理论上可使用约69年而不发生回绕。
- 10位机器ID:由5位数据中心ID和5位工作节点ID组成。这意味着最大支持32个数据中心,每个中心最多部署32台机器,总计可容纳1024台节点。
- 12位序列号:在同一毫秒内产生的多个ID通过此序列号区分。12位二进制允许单机在一毫秒内生成4096个不同ID,足以应对每秒数百万次的请求压力。
Worker ID 的配置与管理
Snowflake算法要求 timestamp 和 sequence_id 由程序运行时动态生成,而 datacenter_id 和 worker_id 必须在部署阶段确定,且在整个生命周期内保持唯一且不可变。如果同一集群中出现重复的 Worker ID,必然导致ID冲突。
常见的配置获取方式有以下两种:
- 依赖外部存储(如MySQL):利用数据库的主键自增特性或自定义的ID生成表来获取 Worker ID。例如使用
SELECT LAST_INSERT_ID()插入本机IP并返回ID,随后将该ID持久化到本地文件或注册中心,以避免每次重启时重新申请。 - 硬编码配置:对于中小规模集群,最简单的方法是在部署脚本或配置文件(如
.yaml或.json)中直接指定worker_id。这种方式无额外依赖,运维成本低,但需人工确保各实例ID不重叠。
开源示例:标准雪花算法实现
在Go生态中,github.com/bwmarrin/snowflake 是目前广泛使用的轻量级Snowflake库实现。它遵循标准协议,开箱即用。
以下是使用该库生成唯一ID的核心代码示例:初始化Node时传入唯一的节点ID(即前文讨论的 worker_id),随后调用 Generate() 方法即可。
package main

import (
	"fmt"
	"os"
	"github.com/bwmarrin/snowflake"
)

func main() {
	// 创建 snowflake node,参数为节点ID (worker_id),取值范围 0-1023
	node, err := snowflake.NewNode(1)
	if err != nil {
		fmt.Println(err.Error())
		os.Exit(1)
	}

	// 循环生成20个ID进行展示
	for i := 0; i < 20; i++ {
		id := node.Generate()
		fmt.Printf("Int64 ID: %d\n", id)
		fmt.Printf("String ID: %s\n", id)
		fmt.Printf("ID Time : %d\n", id.Time())
		fmt.Printf("ID Node : %d\n", id.Node())
		fmt.Printf("ID Step : %d\n", id.Step())
		fmt.Println("--------- end ----------")
	}
}
分布式锁基础与挑战
当多线程或协程并发修改共享变量时,必须保证操作的原子性,否则会产生竞态条件(Race Condition)。在Go语言中,这通常通过互斥锁解决。
package main

import (
	"fmt"
	"sync"
)

func main() {
	var wg sync.WaitGroup
	var count = 0
	// 启动999个Goroutine增加计数器
	for i := 1; i < 1000; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			// count++ 在没有锁保护下是非线程安全的
		}()
	}
	wg.Wait()
	fmt.Println(count) // 预期999,实际结果往往小于999
}
上述多次运行结果往往是不确定的,这是因为多个Goroutine同时读取了同一个旧值并执行加1操作,覆盖了彼此的结果。
进程内加锁 Mutex
若要在单机多核或多Goroutine环境下得到精确结果,需引入 sync.Mutex 对临界区加锁保护:
// ... 部分省略
func main() {
	var wg sync.WaitGroup
	var lock sync.Mutex
	var count = 0

	for i := 1; i < 1000; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			lock.Lock()  // 获取互斥锁
			count++      // 临界区操作
			lock.Unlock() // 释放锁
		}()
	}
	wg.Wait()
	fmt.Println(count) // 稳定输出 999
}
尝试非阻塞锁 tryLock
在某些业务场景中(如抢购),如果请求无法获得许可,应立即放弃执行而不是排队等待,这时需要用到“尝试加锁”。在单机内存环境中,可以通过大小为1的Channel来模拟:
type MyLock struct {
	lockCh chan struct{}
}

func NewLock() *MyLock {
	l := &MyLock{
		lockCh: make(chan struct{}, 1),
	}
	l.lockCh <- struct{}{} // 填充信道,初始状态为未锁
	return l
}

func (l *MyLock) Lock() bool {
	// 非阻塞发送,default分支立即返回false
	select {
	case <-l.lockCh:
		return true
	default:
		return false
	}
}

func (l *MyLock) Unlock() {
	l.lockCh <- struct{}{} // 解锁后再次放入令牌
}
注意:虽然Channel模拟可以实现tryLock,但在高并发争抢时,大量失败的Goroutine会频繁触发调度,造成CPU空转(活锁),因此在Go中不建议将此方式用于高频短时的核心锁逻辑。
基于 Redis 的分布式锁 (SETNX)
当服务扩容到多台机器时,单机锁失效。此时通常借助中间件实现分布式锁。SETNX (SET if Not eXists) 是实现此类锁的基础原子命令。如果Key存在则失败,不存在则设置并成功。
以下示例展示了如何使用Go和Redis实现简单的分布式锁:
package main

import (
	"time"
	"fmt"
	"github.com/go-redis/redis/v8"
	"context"
	"sync"
)

func setnx() {
	client := redis.NewClient(&redis.Options{})
	ctx := context.Background()
	var lockKey = "counter_lock"
	var counterKey = "counter"

	// 尝试获取锁,设置6秒过期时间防死锁
	resp := client.SetNX(ctx, lockKey, 1, time.Second*6)
	lockStatus, err := resp.Result()
	if err != nil || !lockStatus {
		fmt.Println("lock failed")
		return
	}

	// 业务逻辑:读取并累加
	getResp := client.Get(ctx, counterKey)
	cntValue, err := getResp.Int64()
	if err == nil || err == redis.Nil {
		// 处理nil情况
		if err == redis.Nil { cntValue = 0 }

		// 先获取再设置非原子操作,此处仅为演示,实际高并发应Lua或Redis INCR
		val, _ := client.Incr(ctx, counterKey).Result()
		fmt.Println("current counter is ", val)
	}

	// 释放锁
	delResp := client.Del(ctx, lockKey)
	unlockStatus, _ := delResp.Result()
	if unlockStatus > 0 {
		fmt.Println("unlock success")
	}
}

func main() {
	var wg sync.WaitGroup
	for i := 0; i < 10; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			setnx()
		}()
	}
	wg.Wait()
}风险提示:上述简单示例中,业务逻辑(Get + 修改 + Set)并非原子操作。在生产环境中使用Redis做分布式锁,强烈建议结合 Lua脚本 将判断与设置合并,或使用成熟的工具库(如Redlock或Lettuce/RediSonic封装)来处理续期(Watchdog)问题,以防主从切换或网络延迟导致锁提前释放。
基于 ZooKeeper 的分布式锁
相比于Redis的弱一致性,ZooKeeper提供的是强一致性协调服务。基于ZK的锁通常采用“临时顺序节点”机制:
package main

import (
	"time"
	"fmt"
	"github.com/go-zookeeper/zk"
)

func main() {
	c, _, err := zk.Connect([]string{"127.0.0.1"}, time.Second)
	if err != nil {
		panic(err)
	}

	// 创建分布式锁对象,路径为 /distributed_lock_demo
	l := zk.NewLock(c, "/distributed_lock_demo", zk.WorldACL(zk.PermAll))

	// 加锁(默认阻塞等待,直到拿到锁)
	err = l.Lock()
	if err != nil {
		panic(err)
	}

	fmt.Println("lock success, do your business logic")
	time.Sleep(time.Second * 2) // 模拟耗时业务

	// 释放锁
	l.Unlock()
	fmt.Println("unlock success")
}原理说明:客户端在锁目录 /lock 下创建临时顺序节点。所有客户端监听该节点的子节点变化。当某个节点创建完毕后,它会检查自己是否是列表中序号最小的节点。如果是,则获得锁;如果不是,则监听比自己小一号的节点。一旦前一个客户端断开连接(删除临时节点),监听到通知的客户端再次检测自己是否为最小,从而完成锁的转移。
ZooKeeper分布式锁属于阻塞式锁,适合对强一致性要求较高、持有时间较长的粗粒度锁场景(如任务调度)。对于秒杀等高频、短时抢占场景,ZK的性能开销(大量Watches建立与销毁)相对较高,不如Redis灵活。
总结
- 分布式ID:推荐采用Snowflake算法,兼顾自增有序性与高吞吐量,需注意
worker_id的唯一性分发。 - 单机并发:使用
sync.Mutex保证线程安全。 - 分布式锁选型:
- Redis SETNX:高性能,适用于抢单、限流等高频场景,但需注意原子性与过期时间管理。
- ZooKeeper:强一致性,可靠性高,适用于后台系统任务防重、粗粒度资源配置。
以上就是Go语言实现雪花算法分布式ID及分布式锁的详细内容,更多关于Go语言并发编程与分布式架构设计的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









