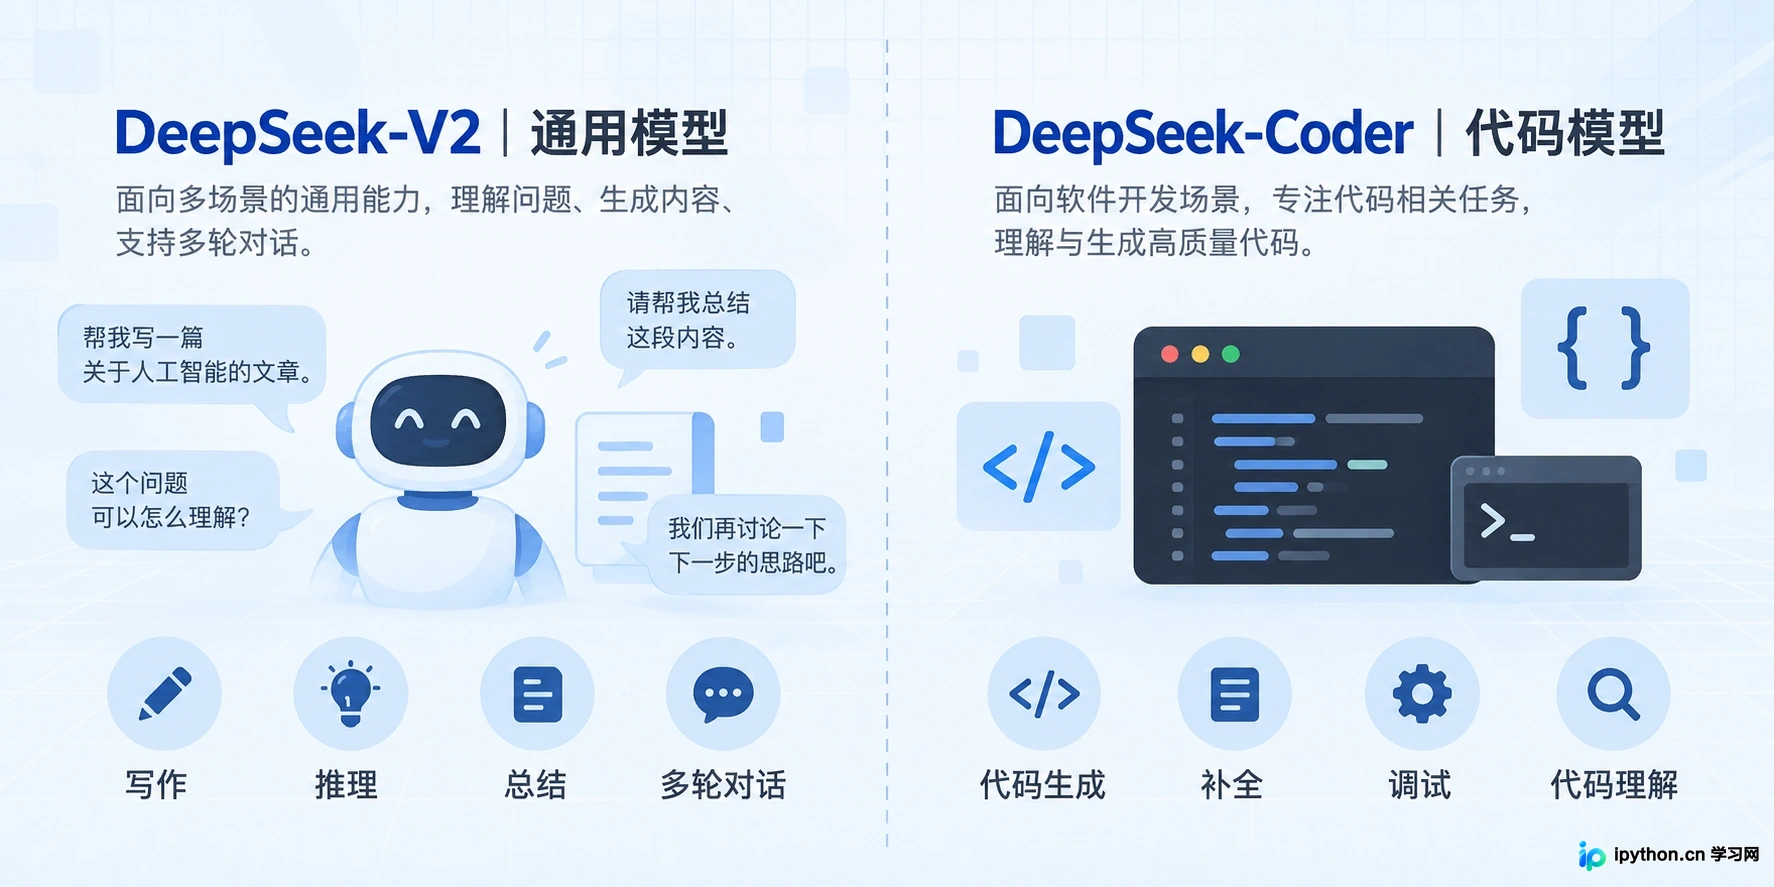
DeepSeek-V2与DeepSeek-Coder有什么区别?选型建议
本文对比DeepSeek-V2通用大模型与DeepSeek-Coder代码专用模型的核心差异,从技术架构、擅长场景及成本效率三个维度解析,帮助开发者根据实际需求做出精准选型。
2026-09-20
9

本文对比DeepSeek-V2通用大模型与DeepSeek-Coder代码专用模型的核心差异,从技术架构、擅长场景及成本效率三个维度解析,帮助开发者根据实际需求做出精准选型。
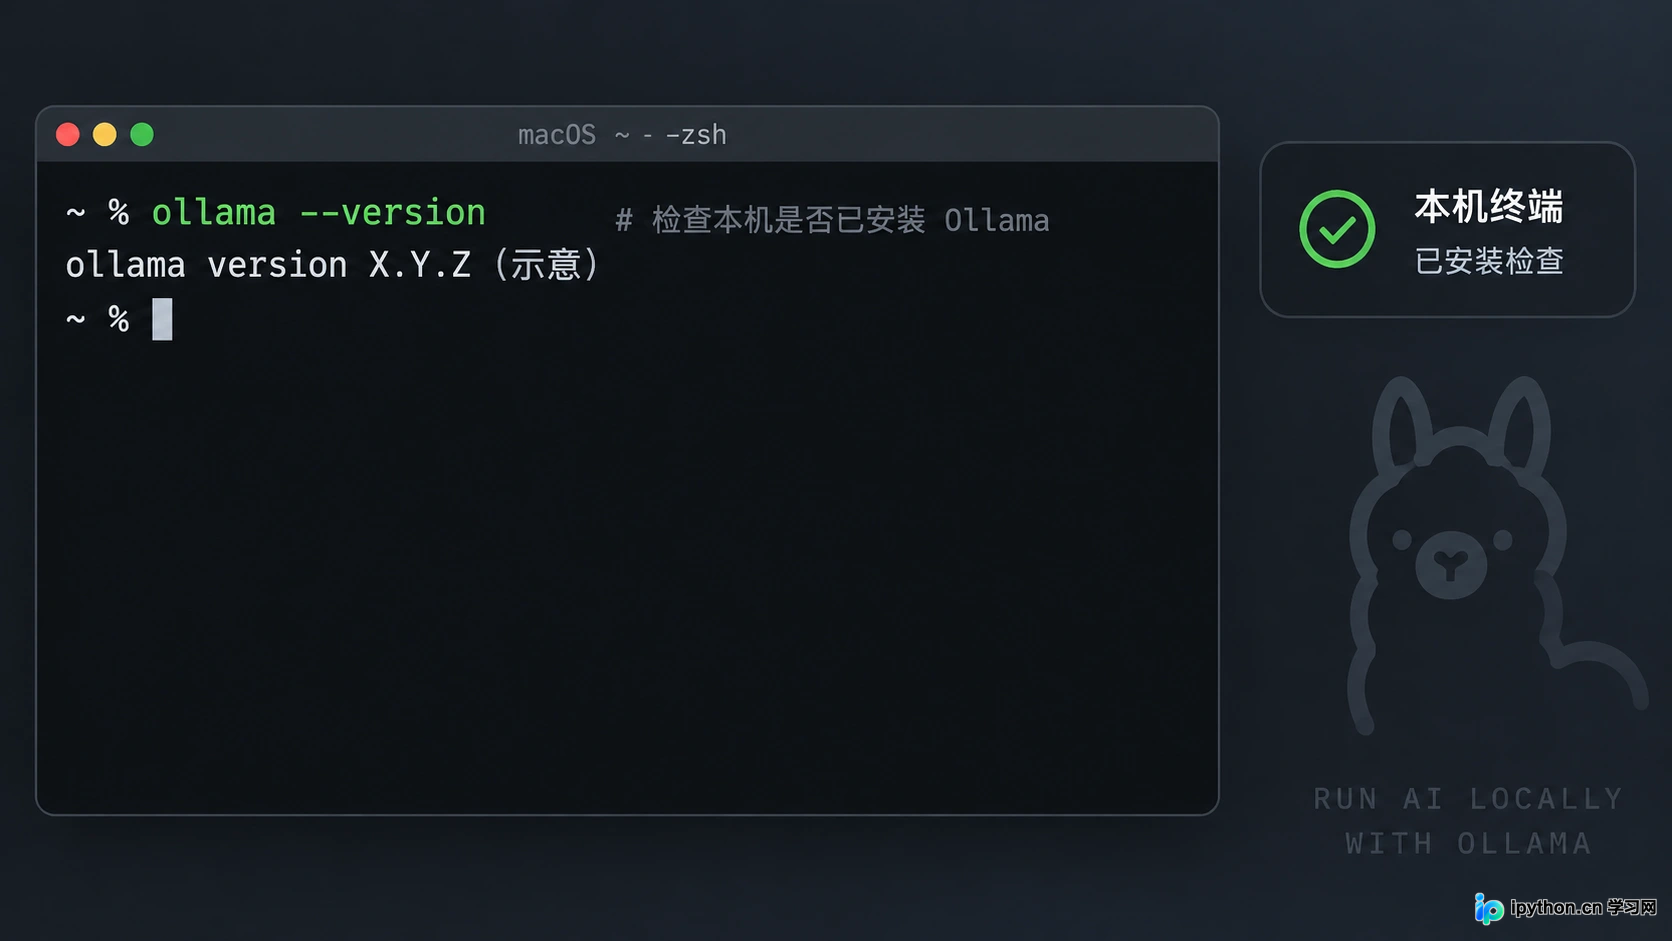
本文介绍如何使用Ollama在本地计算机上快速部署和运行DeepSeek大语言模型。涵盖Ollama安装、模型拉取、命令行交互及基础参数调整,帮助用户低门槛体验本地AI能力。
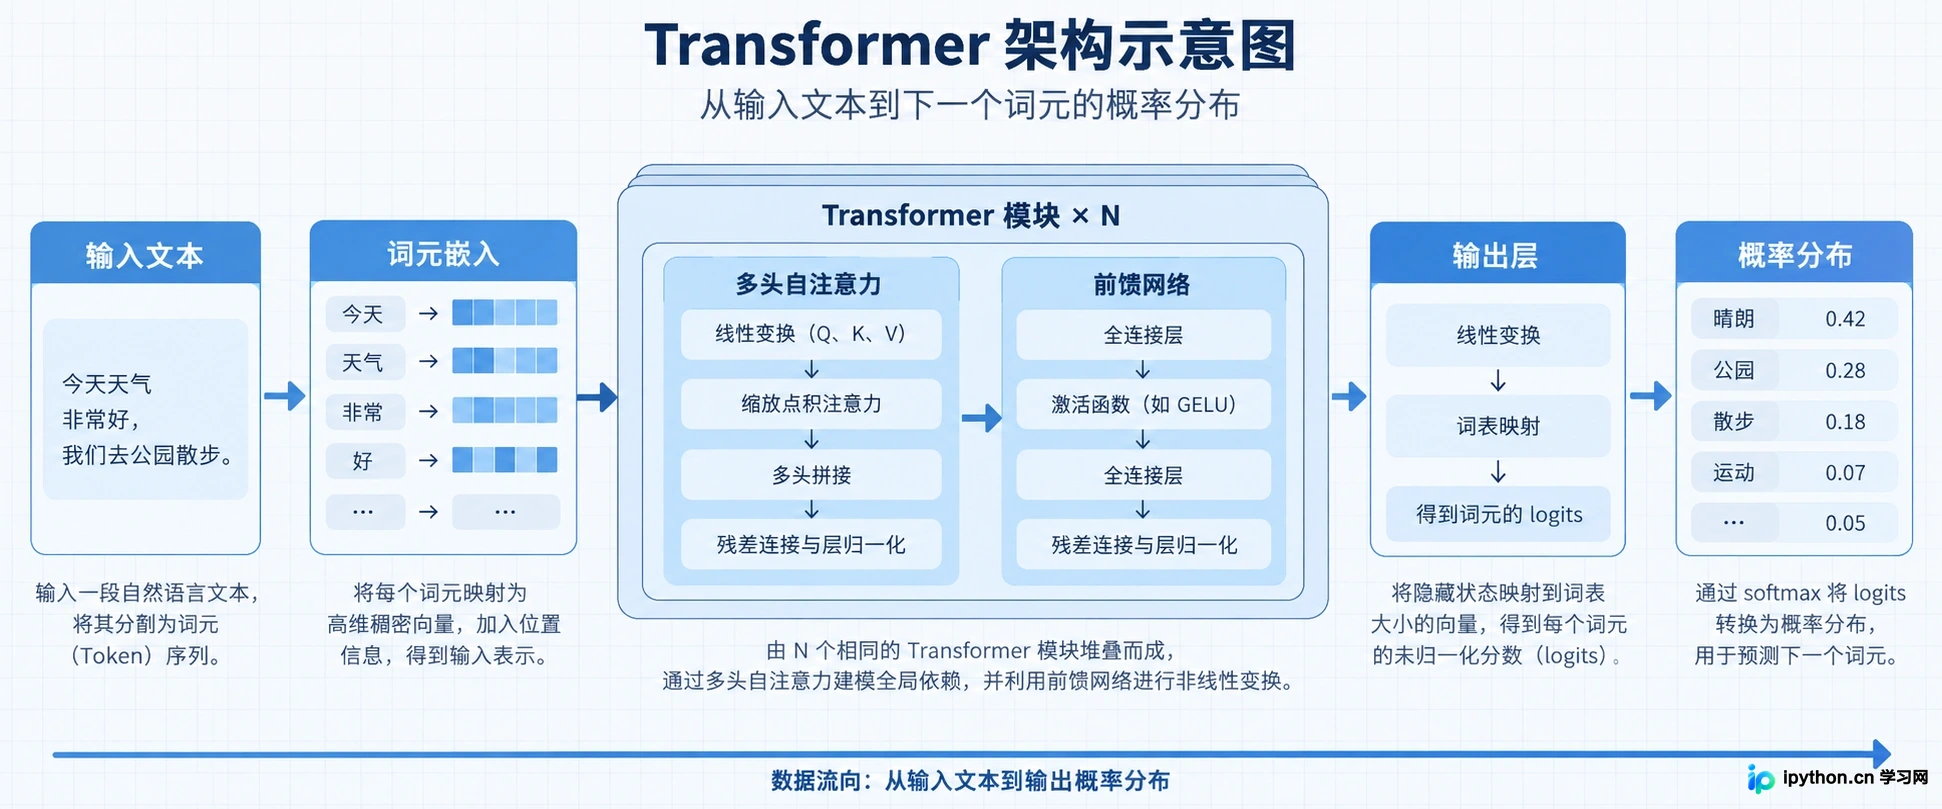
本文以入门视角解析大语言模型的底层逻辑,重点介绍Transformer架构中的自注意力机制如何捕捉语义关联,以及“预训练+微调”如何让模型从通用知识走向特定任务能力。
本文详细介绍如何在本地环境通过 Docker Compose 快速部署 Dify,涵盖环境准备、配置文件修改、服务启动及初始设置,帮助开发者搭建私有化的 LLM 应用开发平台。
面对琳琅满目的AI会议,开发者如何避开纯商业宣讲,找到真正硬核的技术分享?本文筛选了全球范围内聚焦大模型、系统架构与工程落地的顶级技术大会,并重点推荐了其中适合开发者深入交流的分会场与议题方向,助你高效获取前沿技术洞察。
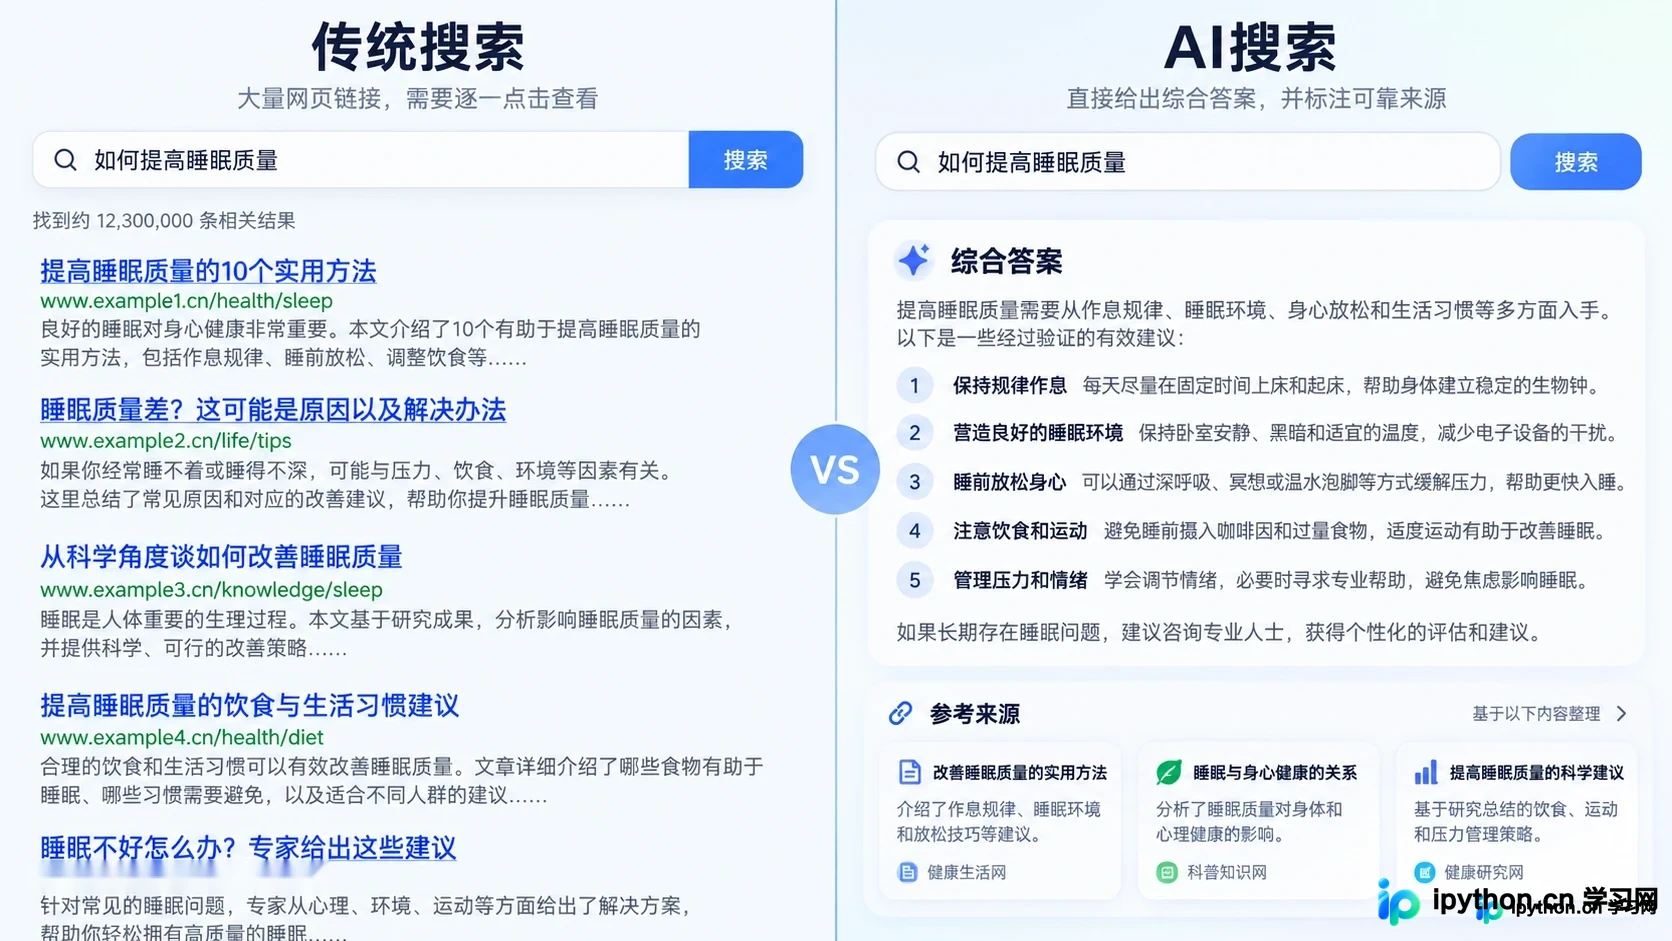
本文深入解析AI搜索引擎(如Perplexity、Bing Copilot)的排名逻辑,对比传统关键词匹配SEO,阐述语义理解、实体关系及内容可信度在AI搜索中的核心作用,帮助读者适应从“流量获取”到“答案提供”的思维转变。
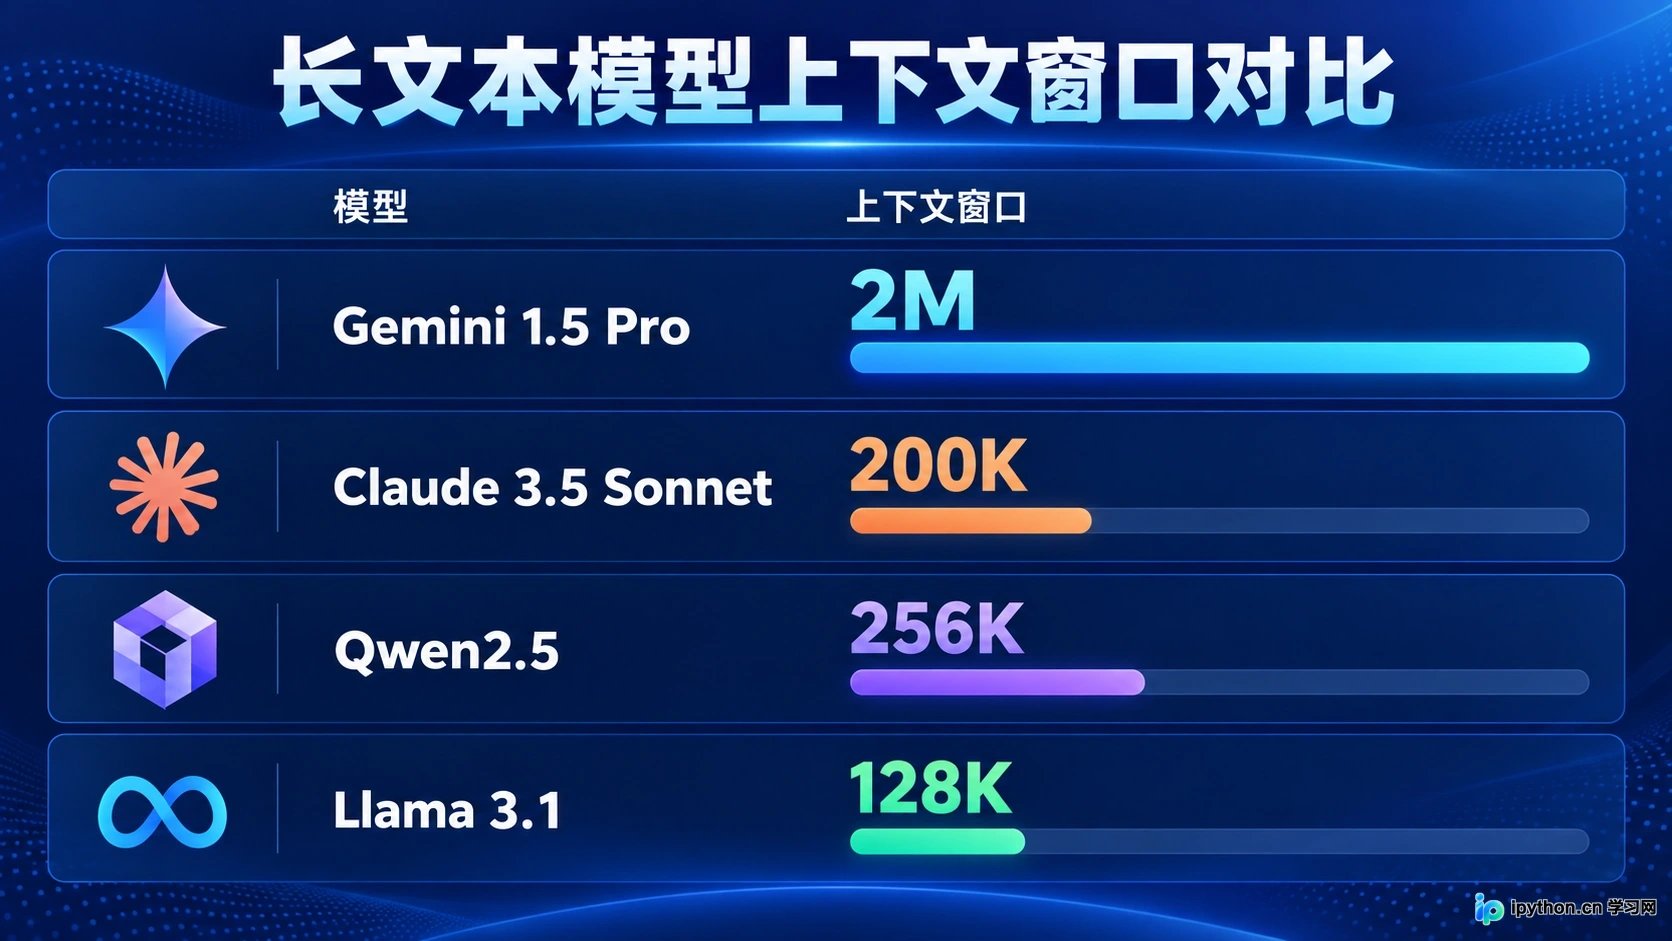
本文梳理当前支持超长上下文(100K-1M+ Token)的主流大模型,基于官方参数与“大海捞针”测试表现进行对比。重点分析Claude 3.5 Sonnet、Gemini 1.5 Pro、Qwen2.5等模型在长文档检索中的准确率差异,帮助开发者根据实际业务需求选择最合适的基座模型。
本文详细介绍 LangChain 框架对接大语言模型(LLM)的核心用法,涵盖文本补全与对话模式的底层逻辑、基础接口调用、自定义模型继承方法,以及异步调用、内存缓存、流式响应和 Token 统计等高级配置指南。
大语言模型(LLM)是擅长处理文本的“大脑”,而AI智能体(Agent)则是能调用工具、自主规划并执行任务的“完整系统”。本文通过日常场景对比,厘清二者在自主性、工具使用及任务闭环能力上的核心差异,帮助你理解为何智能体被视为AI应用的下一站。
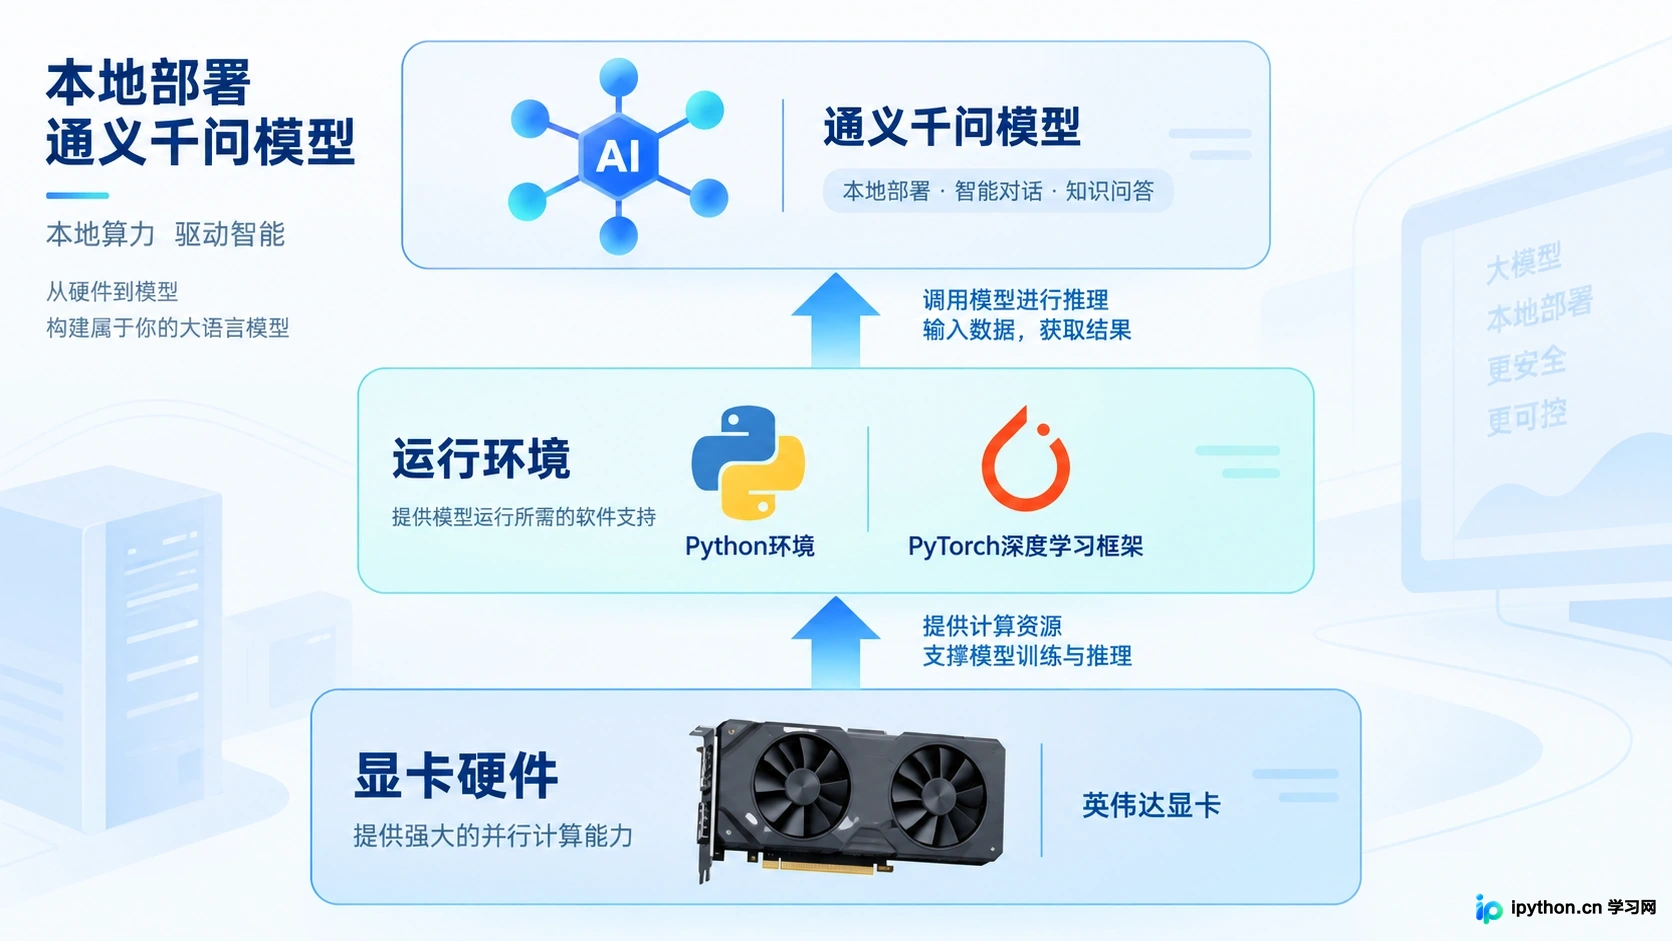
本文介绍如何在本地环境部署通义千问(Qwen)开源大语言模型。内容涵盖Qwen-7B与Qwen-72B的硬件配置门槛,以及基于Python环境和Hugging Face Transformers库的基础加载流程,帮助开发者快速搭建本地推理环境。
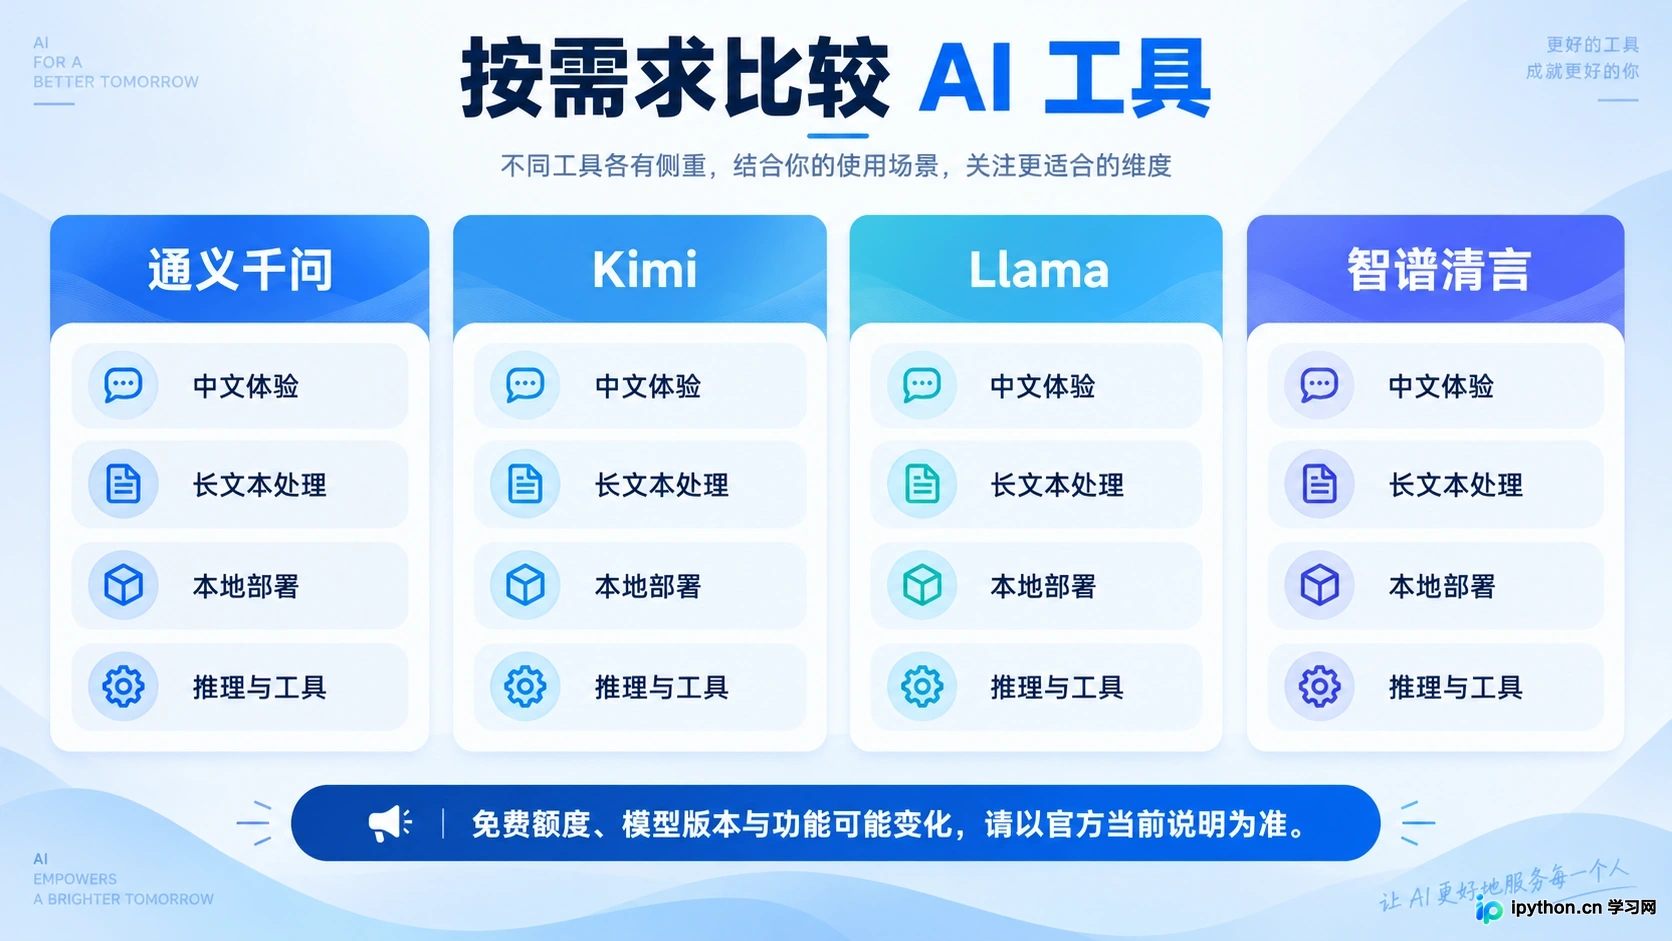
本文汇总了当前市场上真正免费或提供免费额度充足的顶级大语言模型,涵盖在线网页版与本地部署方案。通过对比Qwen、Kimi、Llama 3等主流模型的上下文长度、推理速度及适用场景,帮助用户在不花费一分钱的情况下,获得接近付费级的AI辅助体验。