

大模型的核心原理简述:Transformer架构与预训练机制

当我们谈论“大模型”时,往往被其惊人的对话能力和创作效率所吸引。但剥去应用层的外衣,大模型本质上是一个基于海量数据训练出来的概率预测引擎。它之所以能理解上下文并生成连贯文本,核心在于两大技术支柱:Transformer架构提供的并行处理能力,以及“预训练+微调”带来的知识迁移路径。理解这些基础概念,有助于我们更理性地看待人工智能的能力边界。
概述:从序列到智能的映射
传统深度学习模型处理文本时,往往像阅读一样逐个单词顺序处理,效率较低且难以捕捉长距离依赖。Transformer架构的出现改变了这一局面。它不再依赖循环结构,而是通过一种名为“自注意力”的机制,让模型在处理每个词时都能同时“看到”句子中的所有其他词。
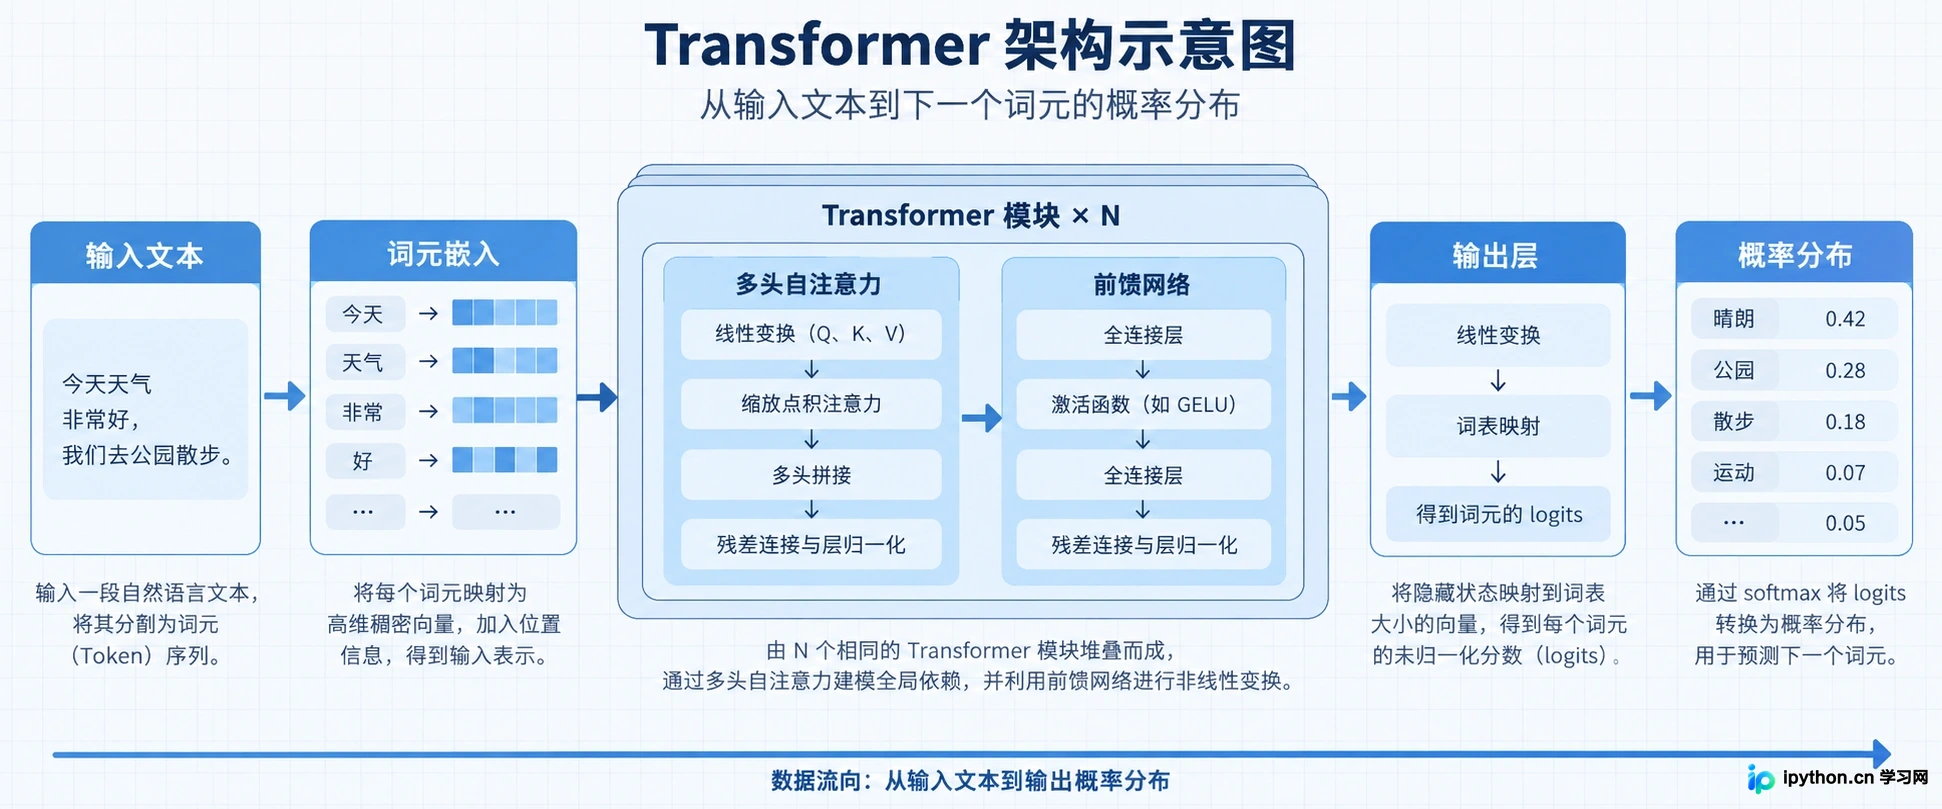
Transformer架构数据流向示意图
这种架构允许模型在大规模数据集上进行高效并行训练,从而孕育出参数量达到千亿级别的巨型模型。整体来看,大模型的工作流程可以简化为:输入文本被转化为向量,经过多层Transformer块的加工,最终输出下一个最可能出现的词的概率分布。
关于【自注意力机制】
自注意力机制(Self-Attention)是Transformer的灵魂。如果把一句话比作一个团队,自注意力就是让团队中的每个成员在发言前,先快速扫视其他所有成员,判断谁的信息对自己当前要说的话最重要。
在具体计算中,每个词会被映射为三个向量:查询(Query)、键(Key)和值(Value)。
- 查询(Q):代表当前词想要寻找的信息类型。
- 键(K):代表其他词所携带的特征标签。
- 值(V):代表其他词的实际内容信息。
模型通过计算Q和K的相似度得分,来决定在生成当前词的表达时,应该从其他词的V中提取多少信息。例如,在句子“银行位于河边”中,当模型处理“银行”这个词时,它会通过注意力机制给予“河”更高的权重,从而推断出这里的“银行”指的是河岸而非金融机构。这种动态加权能力,使得模型能够精准捕捉语境中的细微差别。
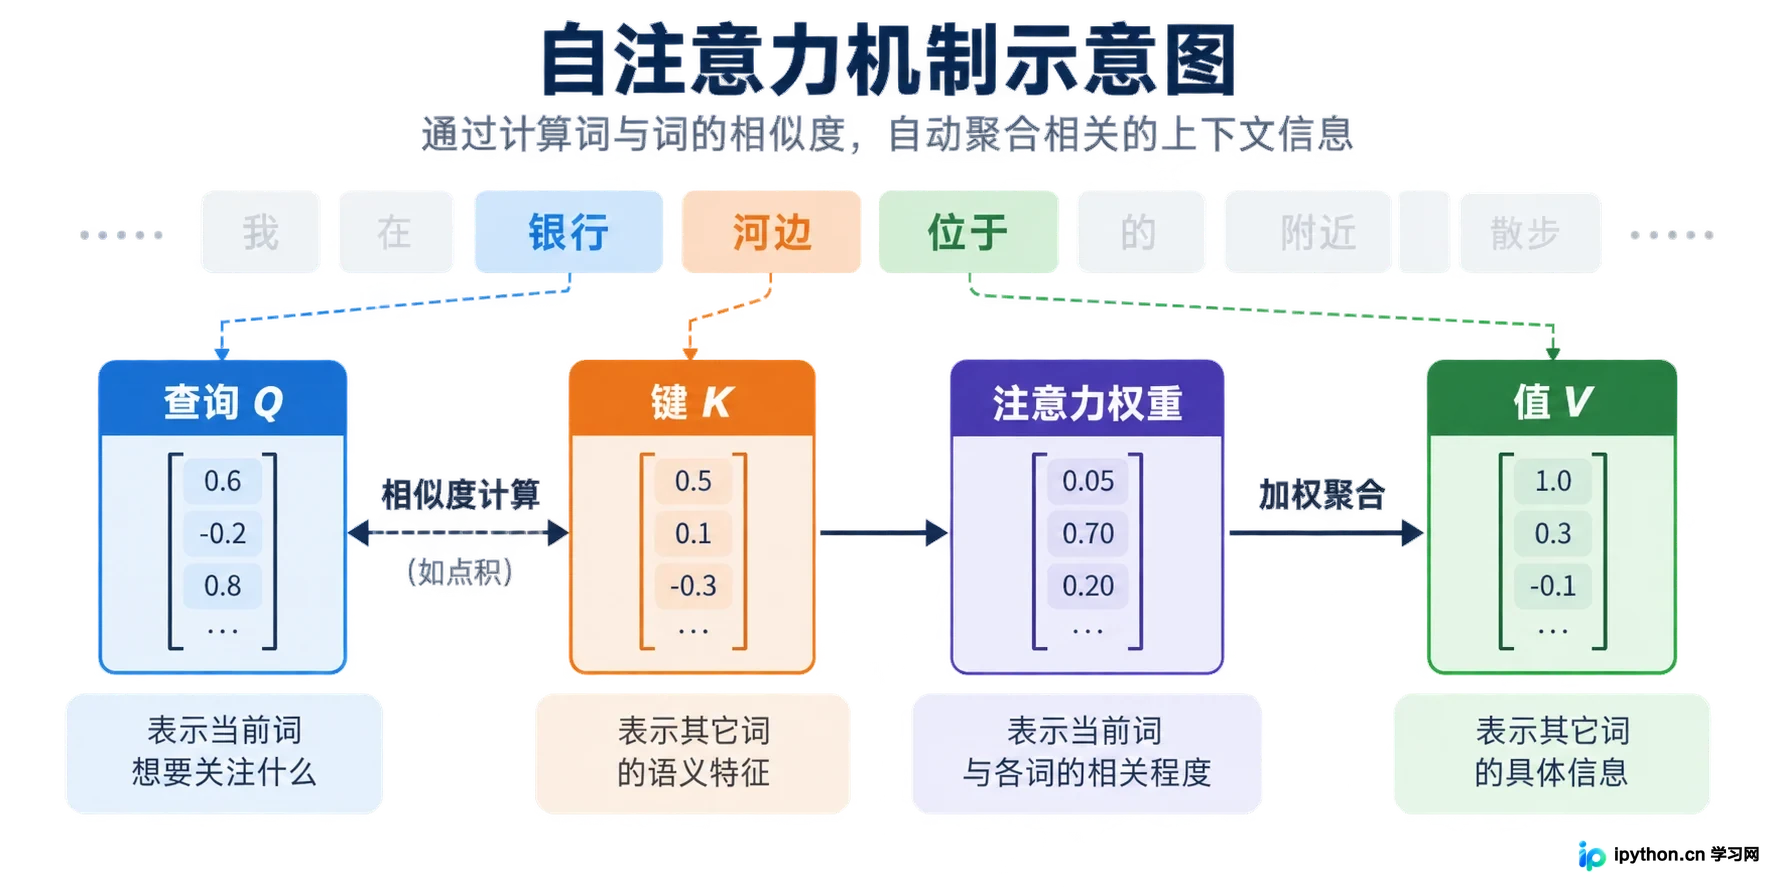
自注意力机制中Query、Key、Value的交互关系
关于【Transformer编码器与解码器】
标准的Transformer由编码器(Encoder)和解码器(Decoder)两部分组成,但在现代大语言模型中,大多采用仅解码器(Decoder-only)的结构。
编码器主要负责“理解”。它将输入文本转化为包含丰富语义信息的向量表示。在机器翻译等任务中,编码器读完整个源句子后,将其压缩成一个上下文向量。
解码器主要负责“生成”。它根据已有的上文和编码器的输出,逐个预测下一个词。在大模型中,由于采用了自回归的方式,模型在生成每一个新词时,都会重新关注之前生成的所有词,确保逻辑的连贯性。这种结构虽然计算量大,但非常适合开放式的文本生成任务。
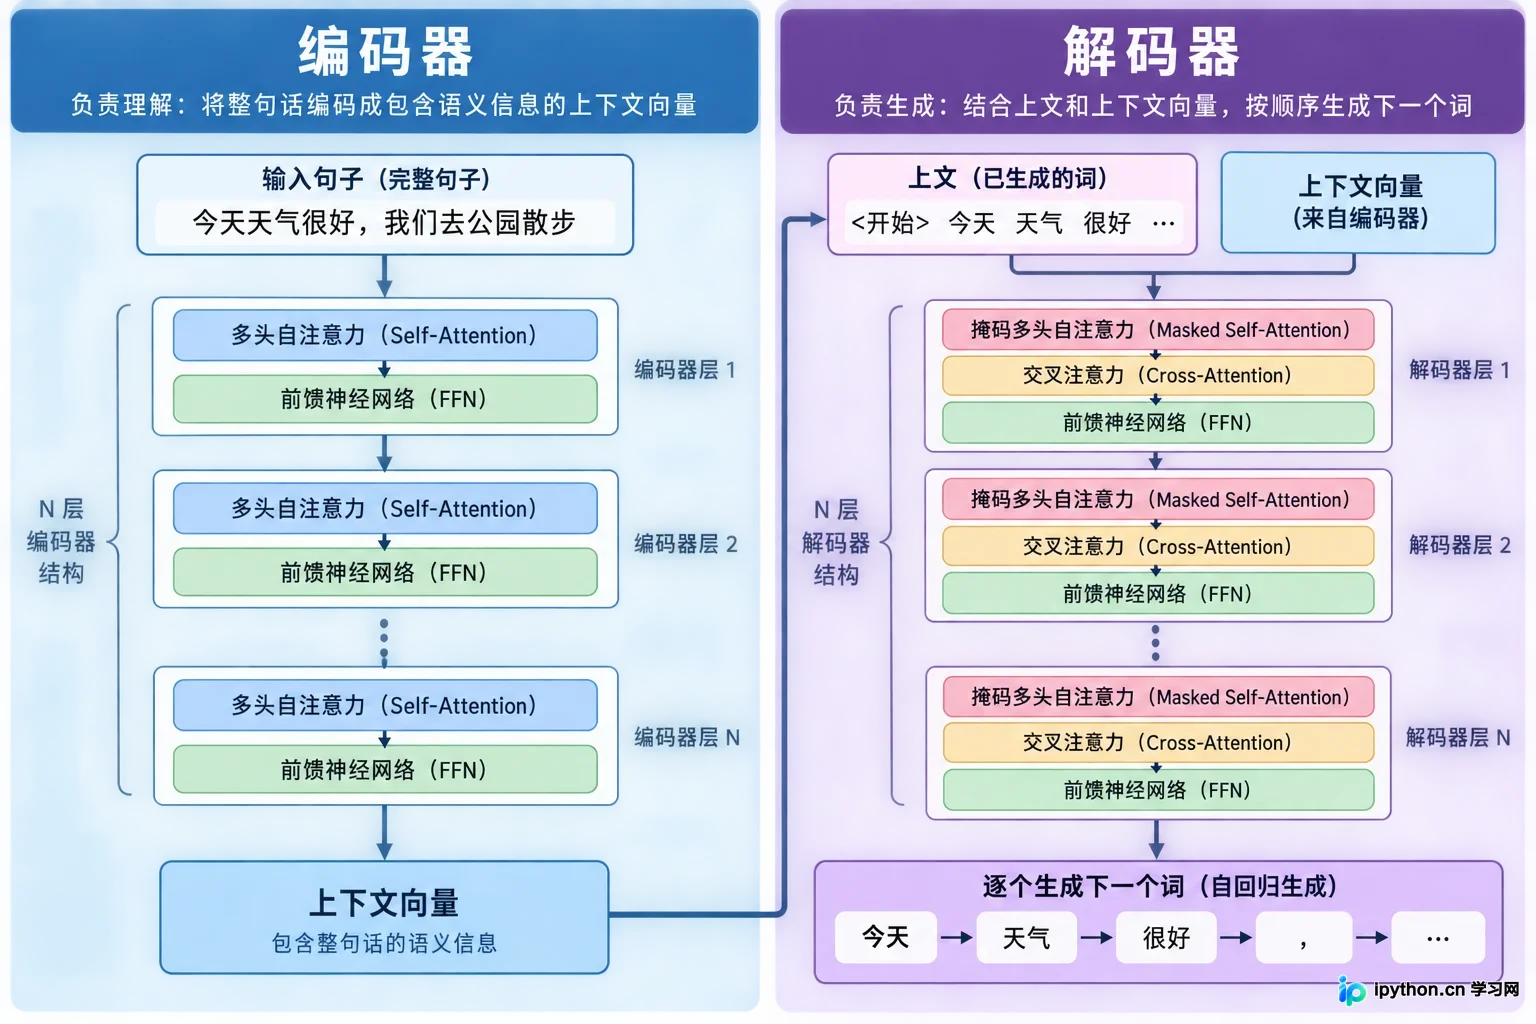
编码器与解码器的功能分工示意
关于【预训练阶段】
预训练是大模型获得“通用智慧”的关键步骤。在这个阶段,模型会在数以万亿计的词符上进行无监督学习。所谓的无监督,是指不需要人工标注答案,模型的任务非常简单:根据前面的词,猜下一个词是什么。
这个过程类似于让一个学生阅读图书馆里所有的书,虽然没有老师逐句讲解,但通过海量的阅读,学生逐渐掌握了语法结构、事实知识甚至逻辑推理模式。预训练的目标是构建一个通用的语言底座,让模型具备广泛的世界知识。
值得注意的是,预训练消耗巨大的算力资源,通常只有少数机构能够承担。这一阶段决定了模型能力的上限,即它的“智力潜能”。
关于【微调阶段】
如果说预训练是让模型博览群书,那么微调(Fine-tuning)就是让模型接受专业特训。预训练后的模型虽然知识渊博,但可能不懂得如何遵循指令,或者在特定领域表现不够专业。
微调通常分为两个子阶段:
- 有监督微调(SFT):使用高质量的问答对数据,教模型如何以人类期望的格式回答问题。例如,当用户问“请总结这篇文章”时,模型学会直接给出摘要,而不是继续续写文章。
- 人类反馈强化学习(RLHF):引入人类评估员对模型的多个回答进行排序,通过奖励模型引导大模型生成更符合人类价值观、更安全、更有用的内容。
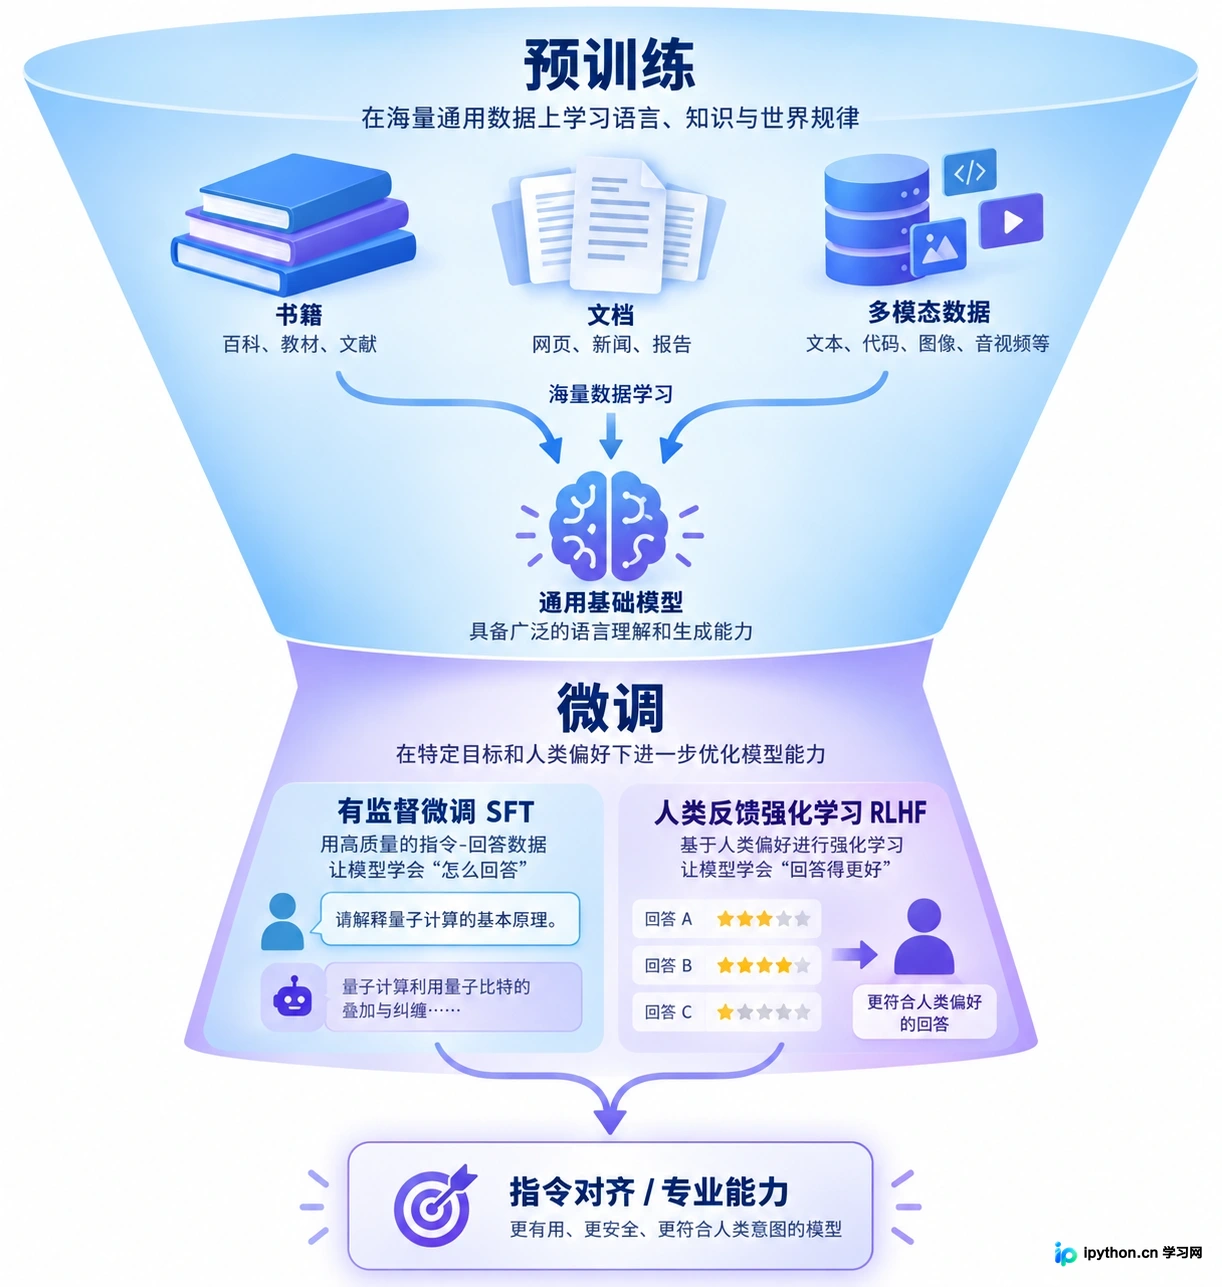
从预训练到微调的技术路径
通过微调,通用大模型可以转化为医疗助手、编程专家或法律顾问。这一过程成本相对较低,使得企业和开发者能够基于开源基座模型,定制属于自己的垂直领域应用。
关于【推理与生成】
当用户向大模型提问时,模型进入推理阶段。它并非真正“思考”,而是在高维空间中进行复杂的数学运算。模型接收输入提示,经过层层Transformer块的注意力计算,输出一个概率表,列出词汇表中每个词作为下一个词出现的可能性。
为了增加生成的多样性和自然度,系统通常会引入采样策略,如温度参数(Temperature)。较高的温度会让模型更倾向于选择概率稍低但更具创意的词,而较低的温度则让模型更保守、更确定。最终,这些被选中的词逐个拼接,形成了我们看到的流畅回复。
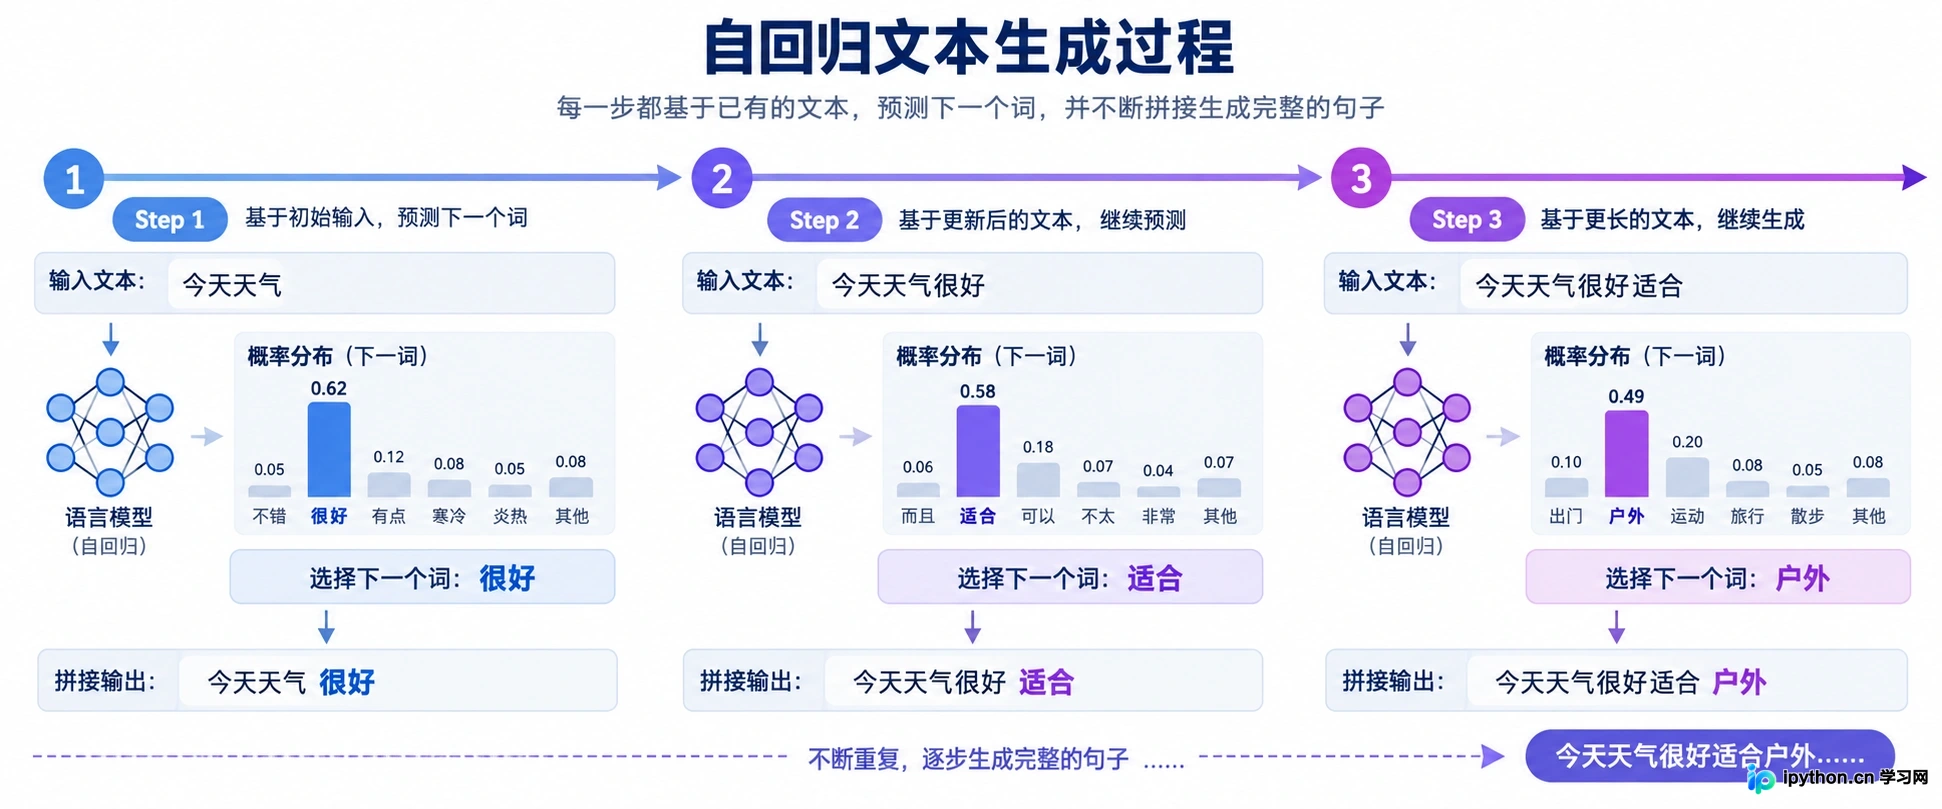
大模型逐个预测下一个词的推理过程
从Transformer的并行架构到自注意力的语境捕捉,再到预训练与微调的知识注入,大模型的技术路径清晰而严密。它不是魔法,而是统计学、线性代数与大规模工程结合的产物。随着算法的优化和算力的提升,这一基础架构仍在不断演进,支撑着人工智能向更深层的认知能力迈进。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









