

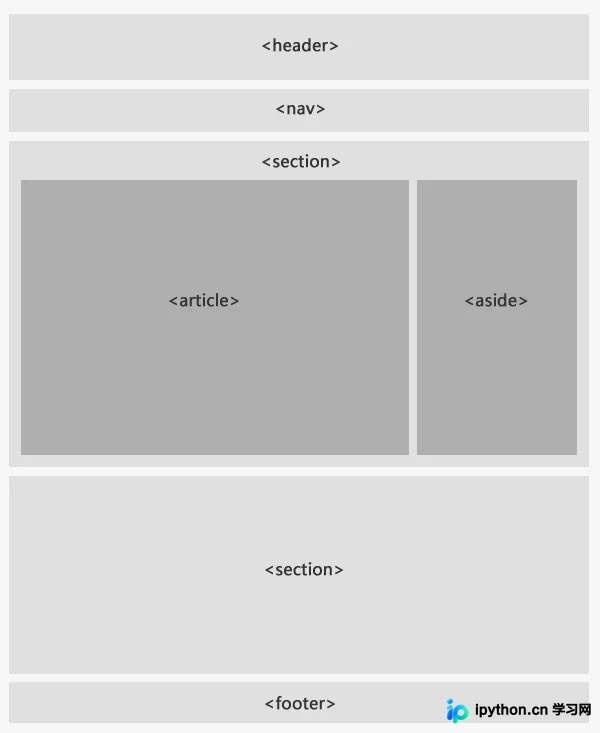
解决 IE6/IE7/8 不兼容 HTML5 标签的多种方法
针对IE6/7/8无法识别HTML5语义化标签的问题,本文提供原生JavaScript创建元素、调用Google Html5Shiv库(含国内CDN镜像)及CSS块状初始化三种解决方案。同时补充了禁用脚本用户的容错处理建议。
2026-10-13
6

针对IE6/7/8无法识别HTML5语义化标签的问题,本文提供原生JavaScript创建元素、调用Google Html5Shiv库(含国内CDN镜像)及CSS块状初始化三种解决方案。同时补充了禁用脚本用户的容错处理建议。
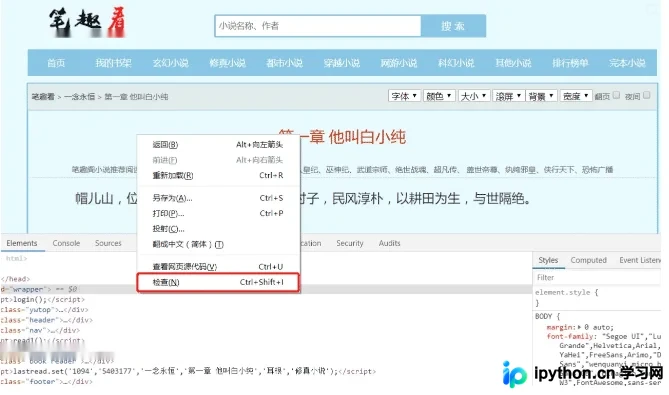
本文详细介绍如何使用Python编写爬虫程序,从笔趣网爬取小说《一念永恒》。重点讲解BeautifulSoup库的安装与使用,包括通过开发者工具定位HTML元素、构造带User-Agent的HTTP请求以及解析响应数据的具体步骤。旨在帮助初学者掌握基础的网络数据采集技巧,同时强调支持正版阅读的重要性。
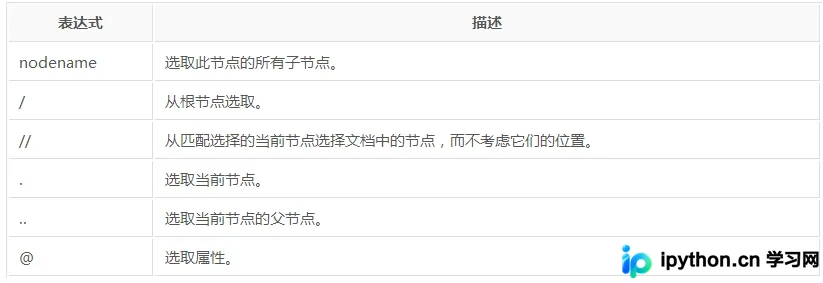
本文详细介绍Python中lxml库解析HTML文件的方法。涵盖DOM节点创建与属性获取、XPath绝对与相对路径筛选、文本提取及Scrapy爬虫实战示例。重点强调UTF-8解码必要性及常见解析错误处理,帮助开发者高效处理网页数据。
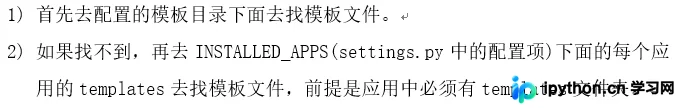
本文详细介绍Python Django框架中的模板渲染功能,涵盖settings.py中模板路径配置、views.py中视图函数的编写(包括传统loader方式与简化的render方式),以及HTML模板文件的创建与变量、代码段和循环语句的使用。
本文介绍Django框架中模板继承的核心机制,通过定义base.html基础模板,利用{% extends %}和{% block %}标签实现代码复用。文章详细讲解了如何在子模板中重载标题、JS、CSS及内容区块,并强调静态文件引用的特殊性,旨在帮助开发者减少前端代码冗余,提升维护效率。
本文介绍如何利用Python的Jinja2库通过FileSystemLoader加载模板并渲染生成HTML文件。同时提供了一段处理大文件的示例代码,演示如何通过计算已处理字节数与总文件大小比例,在控制台动态刷新显示进度条,适用于需要监控文件IO操作的场景。
本文深入解析Django模板系统的核心功能,涵盖ROOT_URLCONF配置、三种静态文件引入方式、模板导入与母版继承机制,以及通过自定义inclusion_tag返回HTML片段的完整步骤。通过具体代码示例,帮助开发者掌握页面布局复用与动态内容生成的最佳实践。
本文介绍了在Python Web框架中实现原生分页的具体方法。通过定义Pagination类,处理当前页码、数据总量、每页显示条数及最大显示页码等参数,动态生成分页HTML代码。文章提供了完整的代码示例,涵盖页码计算、边界处理及Bootstrap样式兼容,适用于需要自定义分页逻辑的Web开发场景。
本文介绍了使用Python3将视频转换为字符动画的完整实现方案。通过OpenCV处理视频帧,提取颜色与字符映射信息,并结合JavaScript在前端渲染彩色字符画面。代码包含视频处理核心类及HTML生成逻辑,支持自定义帧率与宽度,最终输出可直接在浏览器播放的HTML文件。
本文介绍如何使用Python的Beautiful库解析HTML字符串,重点演示通过textarea标签定位内容,并利用get_text()方法清除所有HTML标签,从而高效提取纯净文本数据。
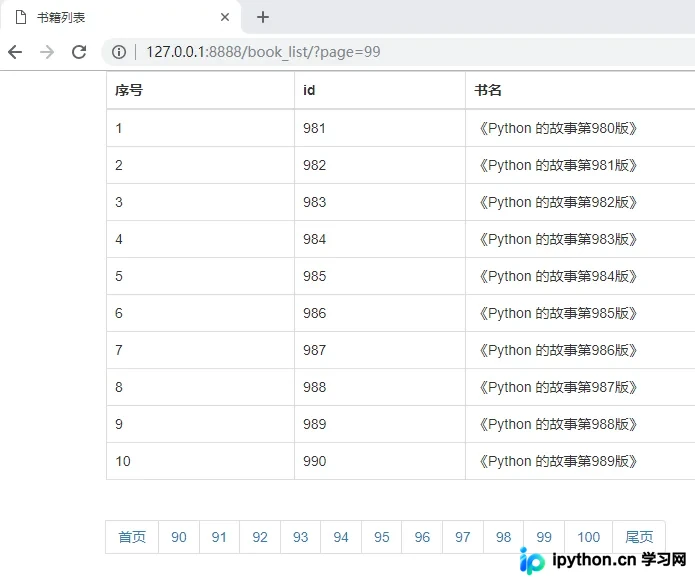
本文详细介绍如何在 Python Django 框架中实现高效的分页功能。通过修改 views.py 与 book_list.html,演示如何添加首页、尾页、上一页及下一页按钮。重点讲解如何处理 URL 中 page 参数的异常值(如非数字或负数),确保系统稳定运行。
本文详细解析Django框架下实现HTML页面跳转的完整流程。从项目创建命令入手,深入讲解MVT架构中路由(urls)与视图(views)的协作机制,并通过具体代码示例展示如何配置路径、编写视图函数以及渲染HTML模板,帮助开发者快速掌握Django基础页面跳转逻辑。