Python实现优先级队列:基于heapq模块的完整指南
本文介绍如何使用Python标准库heapq模块构建优先级队列。通过元组(-priority, index, item)结构解决同优先级元素排序问题,确保先进先出。代码示例展示Push和Pop操作,并探讨线程安全扩展方案,适合需要高效排序队列的开发者参考。
2026-10-13
6

本文介绍如何使用Python标准库heapq模块构建优先级队列。通过元组(-priority, index, item)结构解决同优先级元素排序问题,确保先进先出。代码示例展示Push和Pop操作,并探讨线程安全扩展方案,适合需要高效排序队列的开发者参考。
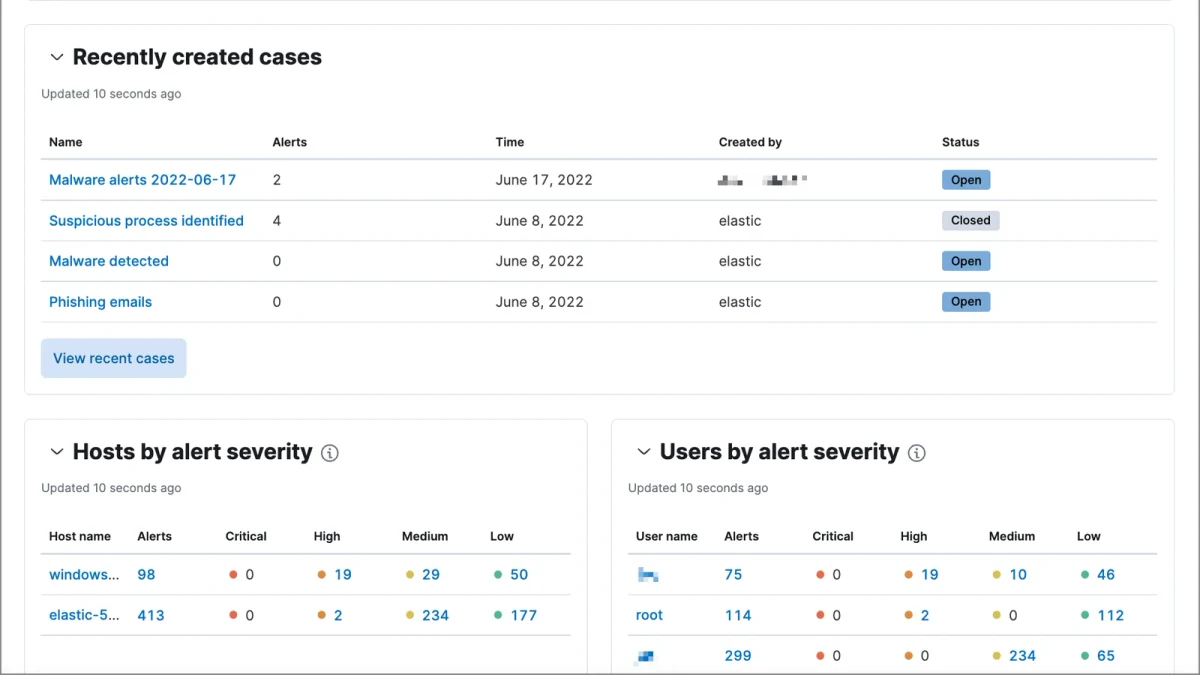
围绕安全日志采集、入侵检测告警与异常排查,系统梳理日志缺失、解析异常、告警误报、检测失效等高频问题,帮助读者建立从现象识别到原因定位、修复验证及风险规避的完整排查思路。
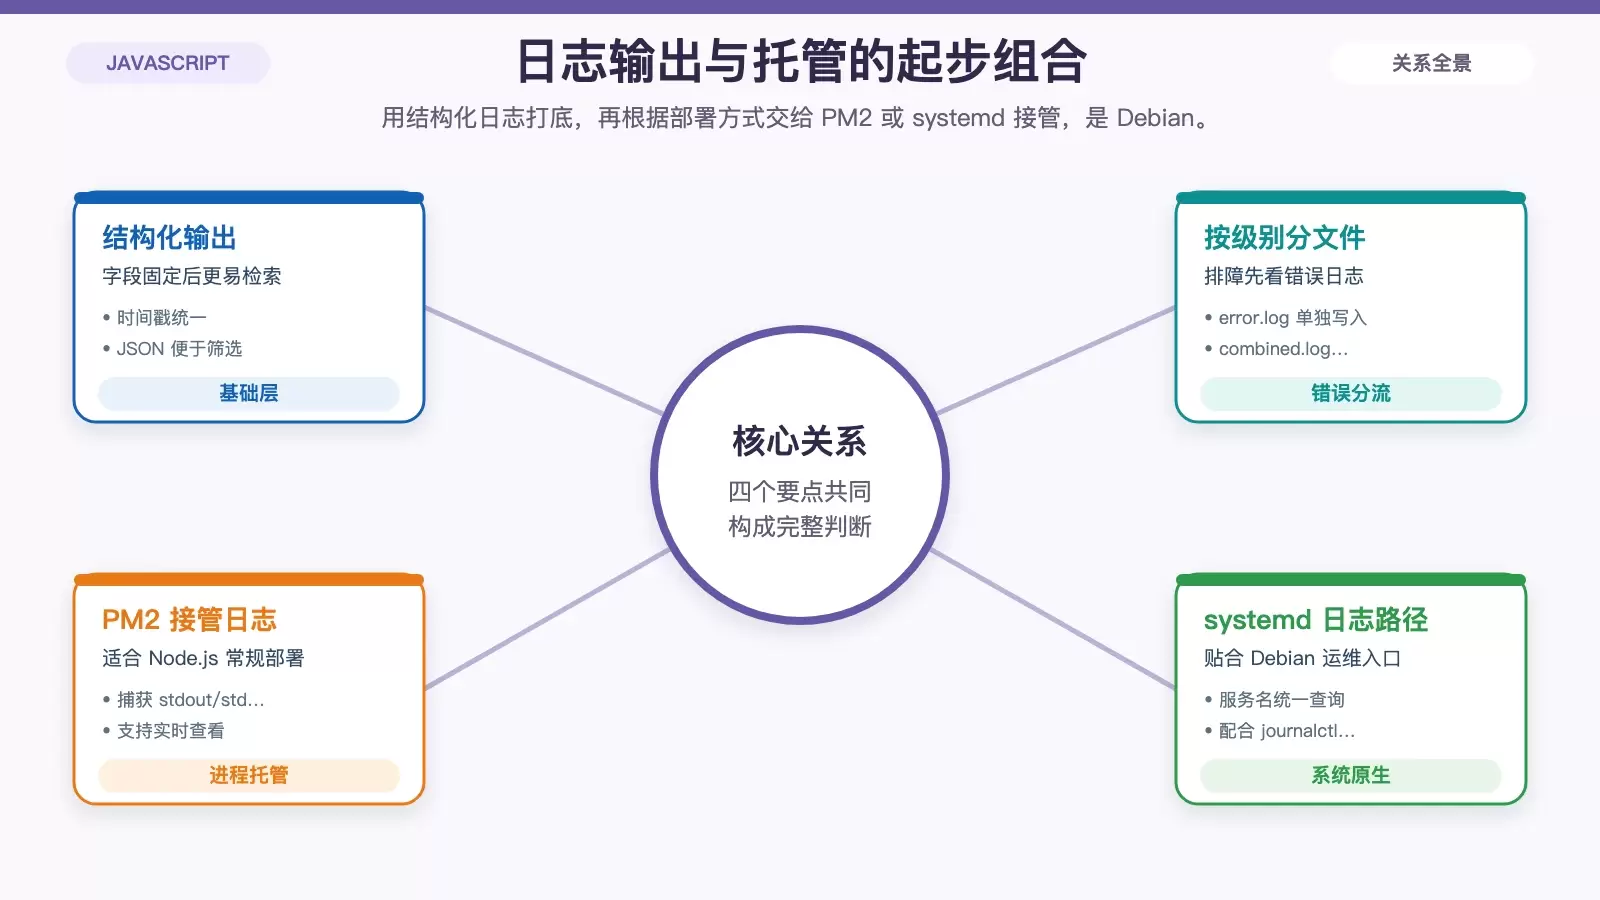
在 Debian 上维护 JavaScript 应用,日志不能只停留在 `console.log()`。这篇文章按“应用产生日志、系统接管、文件轮转、集中分析、异常告警”的顺序,梳理一套可落地的监控链路,并给出适合不同规模部署的判断方法。
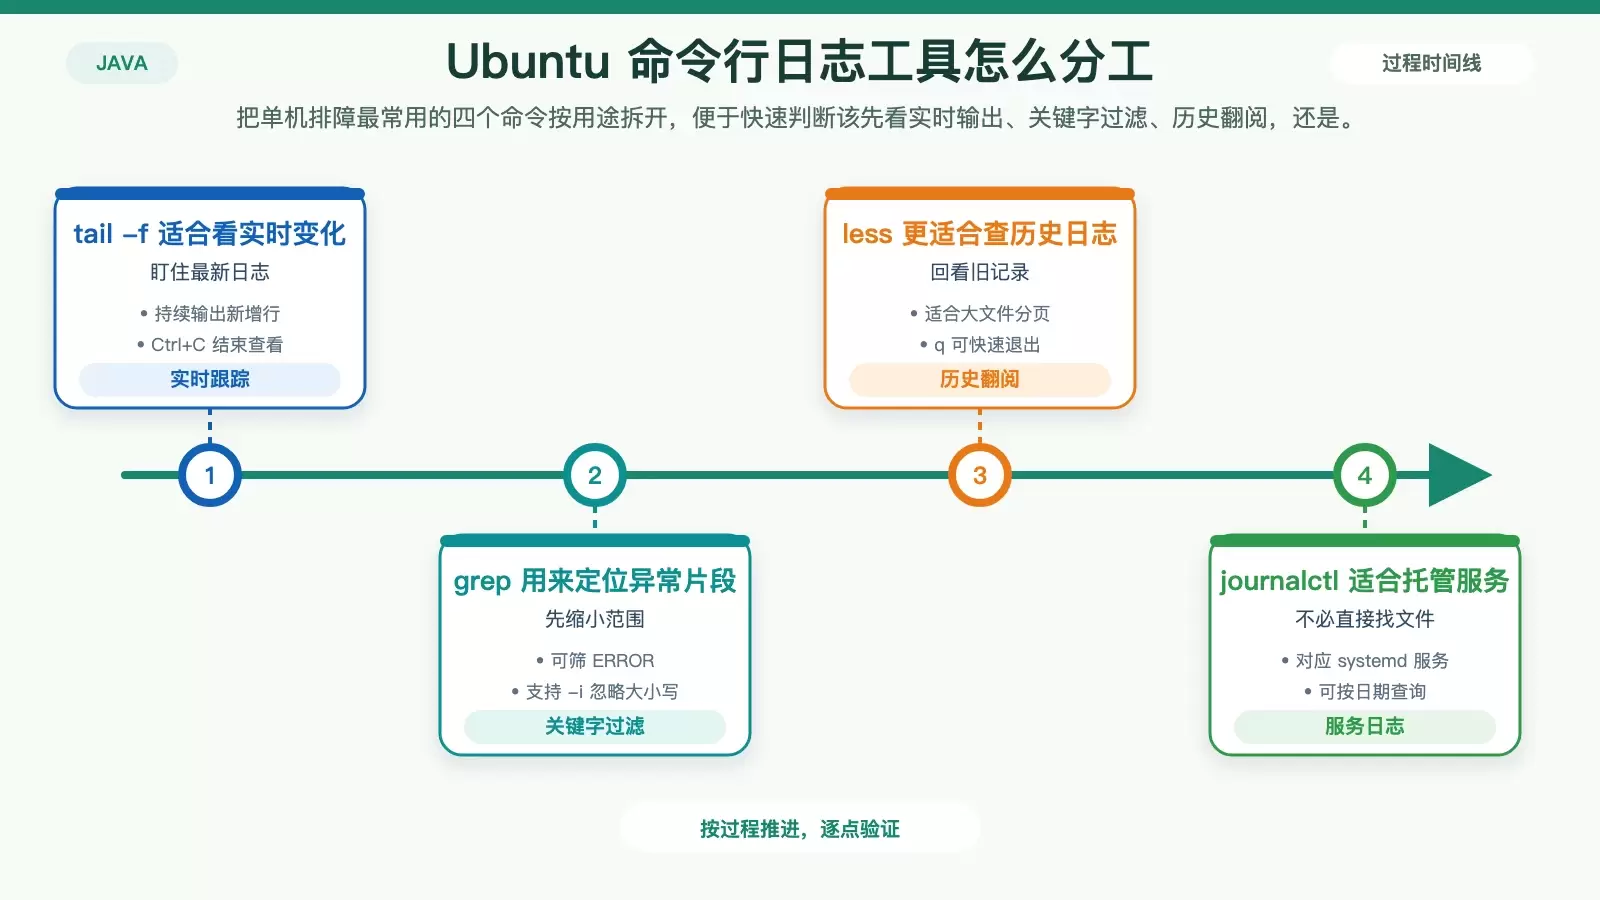
在 Ubuntu 上监控 Java 日志,常见做法可以分成四层:命令行排查、集中化日志平台、性能与异常监控、日志轮替。本文按使用场景梳理每种方案的适用边界、关键命令和配置要点,方便你根据应用规模与排障目标快速选型。
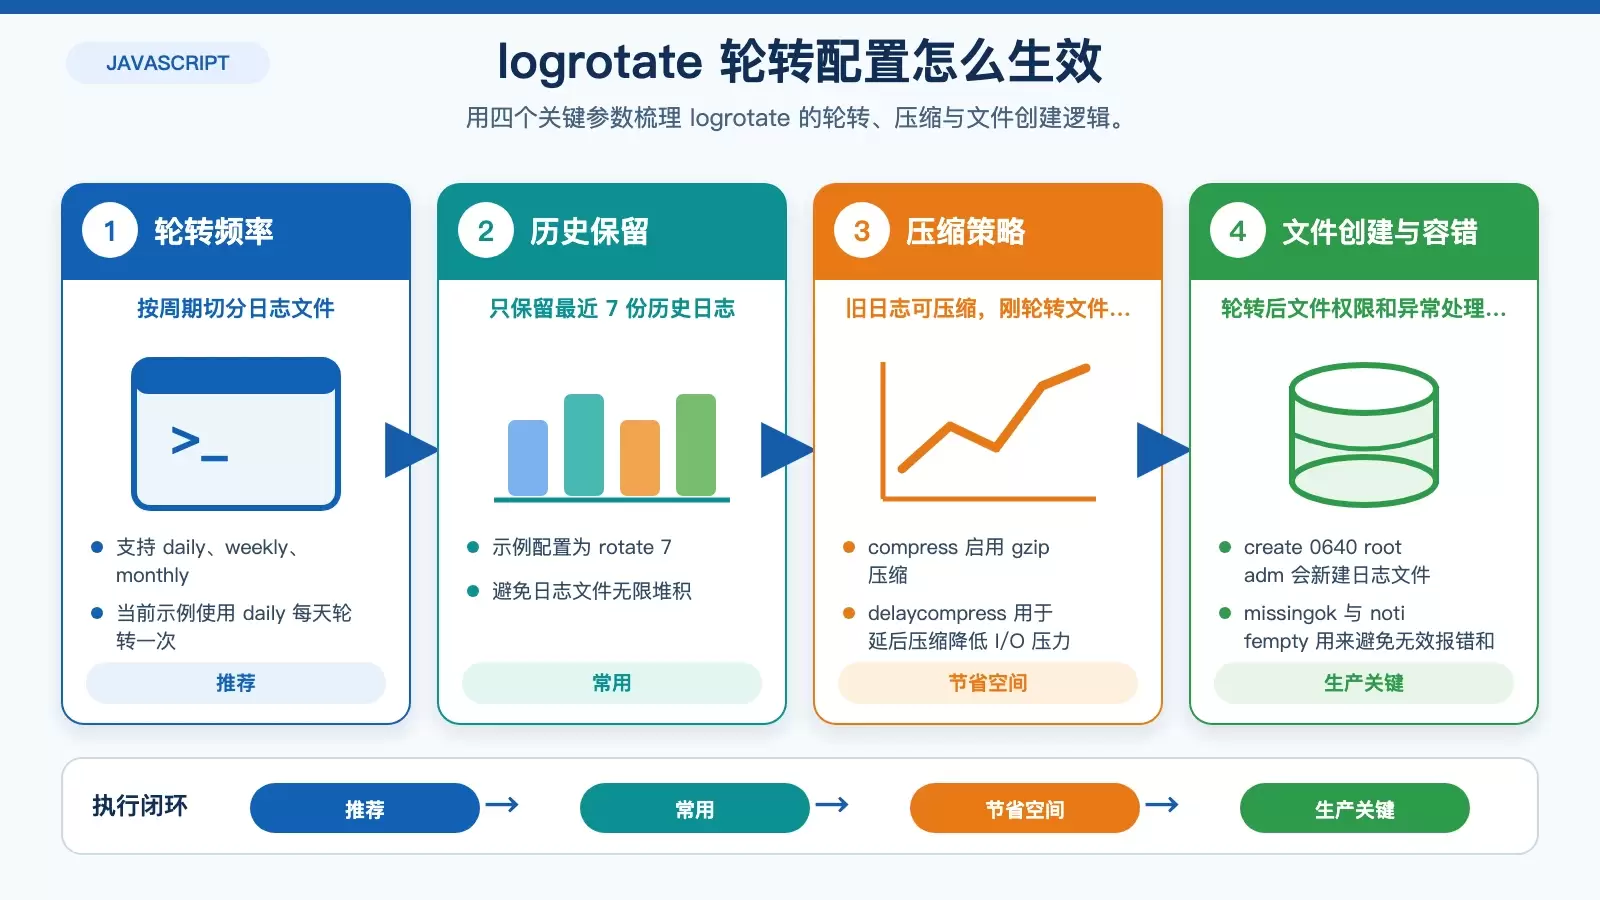
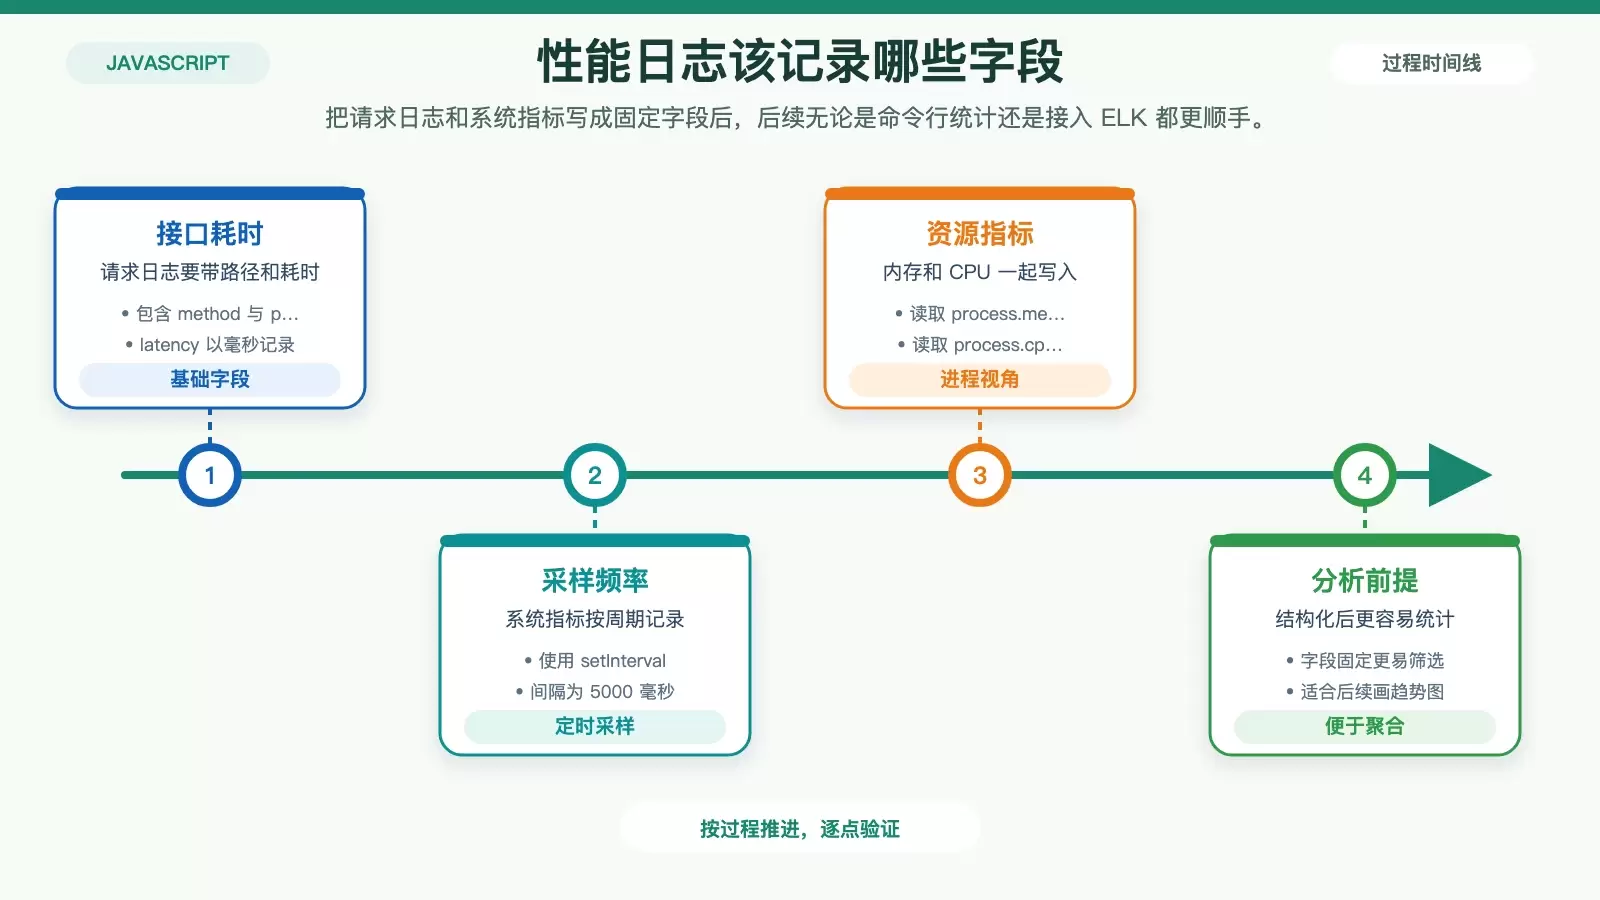
在 Ubuntu 上分析 Node.js 性能,关键不只是“把日志记下来”,而是让日志具备可检索、可统计、可追踪的能力。本文从结构化日志、核心指标埋点、命令行筛查,到 ELK、PM2、Logrotate 和 APM 的组合方式,梳理一套适合日常排障与持续监控的做法。
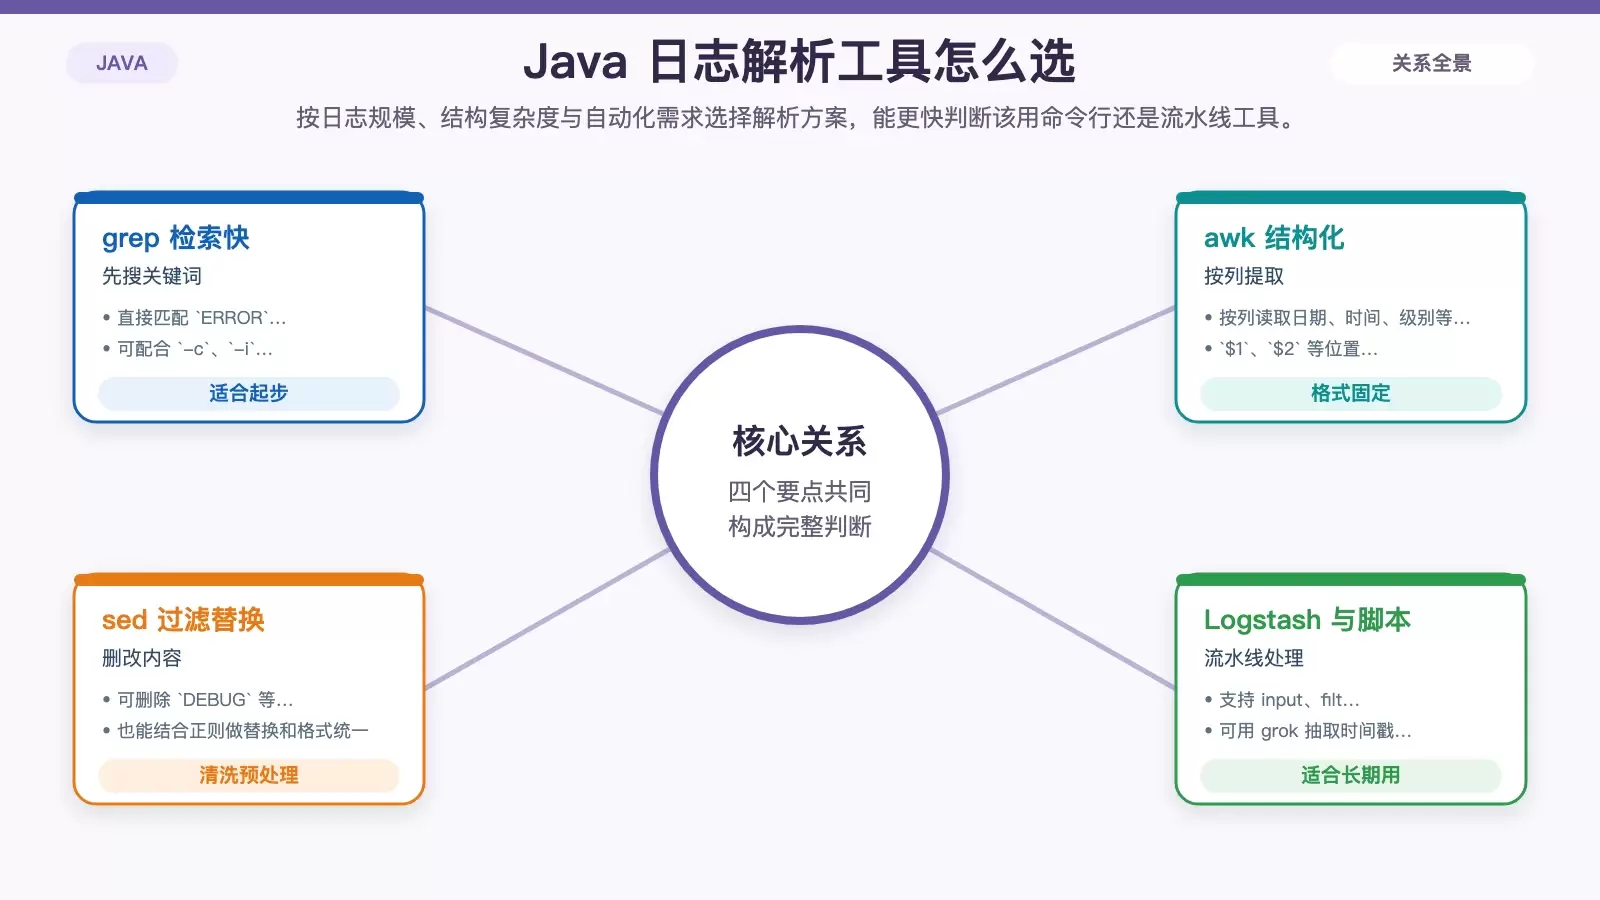
在 Linux 上解析 Java 日志,常见做法从 `grep`、`awk`、`sed` 到 Logstash 与自定义脚本各有分工。本文按使用场景梳理这些方案的适用边界、典型命令与配置,帮助你根据日志规模、格式复杂度和自动化需求选择合适工具。
Ubuntu 上给 Node.js 日志做自动化处理,常见做法主要分成系统轮转、进程管理器内置方案、集中收集和分析平台几类。本文按部署方式拆解各方案的适用场景、配置方法和取舍点,并补充旧日志自动清理的落地方式。