

网络安全指南:安全日志与入侵检测常见问题排查:高频错误、原因与解决方法

识别安全日志与入侵检测的常见故障表现
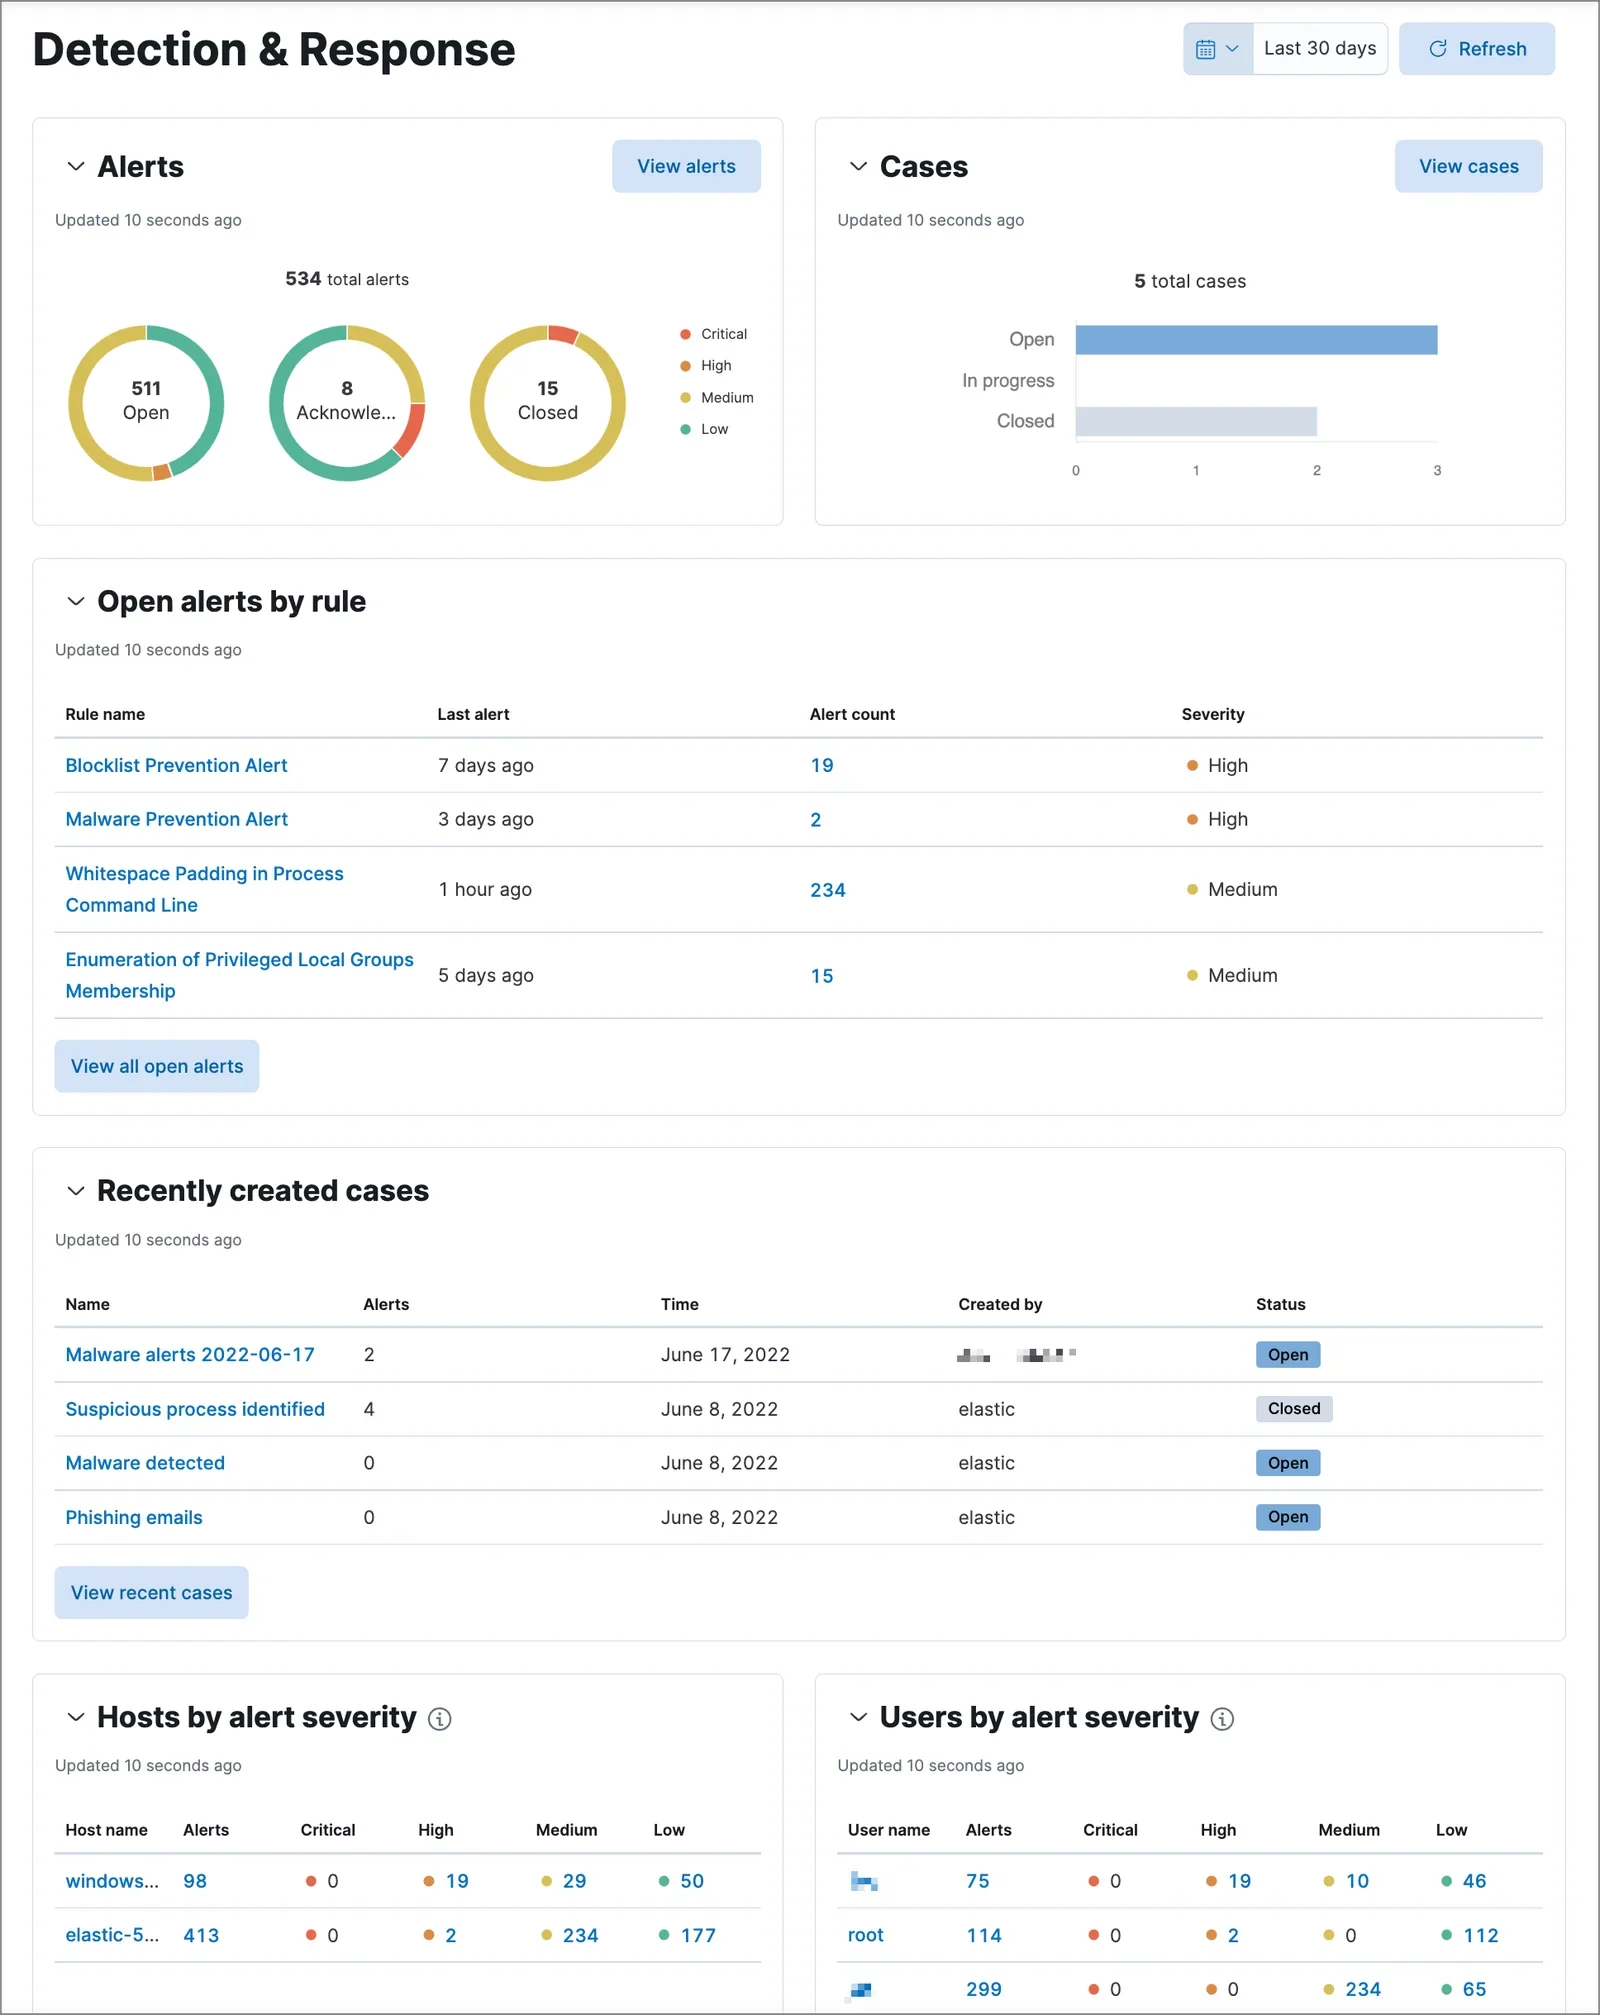
在安全运营中,日志与入侵检测系统的故障往往表现为隐蔽且连锁的反应。典型现象包括:终端或网络设备未生成预期日志、采集端出现分钟级甚至小时级延迟、上报字段缺失(如缺失源IP或用户标识)、解析引擎因格式不匹配而丢弃数据、检测规则在明确攻击流量下未触发,以及告警风暴或静默异常。排查时需首先划定边界:日志源负责产生原始数据,采集端负责抓取与转发,分析端负责标准化与存储,检测规则引擎负责匹配与告警。例如,当发现某Web服务器访问日志未进入SIEM时,应先确认应用层是否开启访问日志记录(日志源),再检查采集Agent进程是否存活(采集端),最后核对SIEM解析管道是否适配新日志格式(分析端)。明确故障表现与责任边界,是避免盲目排查、快速定位根因的第一步。
排查日志采集、解析与传输异常
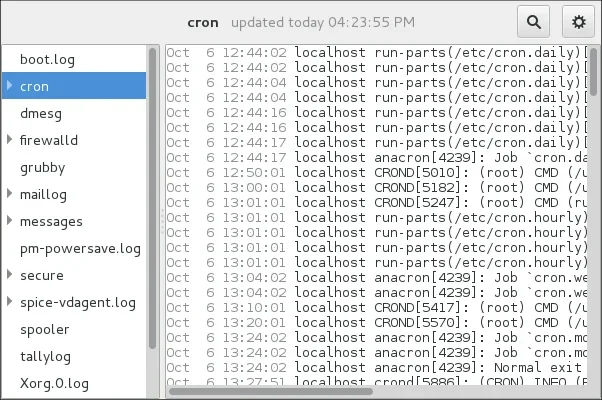
日志链路的排查需遵循自底向上的逐层验证逻辑。首先检查日志源配置,确认系统或应用已正确开启日志输出,例如Linux的/etc/rsyslog.conf或Nginx的access_log指令是否生效。其次验证采集服务状态,通过systemctl status filebeat或journalctl -u rsyslog查看进程是否异常退出或报错。权限与传输链路是高频故障点,需确保采集用户具备日志文件读取权限,且防火墙未拦截514/5044等Syslog或Beats端口。时间同步异常会导致日志乱序与关联失败,必须通过chronyc sources确认NTP同步状态。针对解析失败,需核对正则表达式或Grok模式是否覆盖实际日志结构,例如多行Java堆栈日志需配置multiline.pattern。修复时,建议采用增量配置与语法校验(如filebeat test config),避免全量覆盖导致服务中断。
定位入侵检测告警异常与规则不生效问题
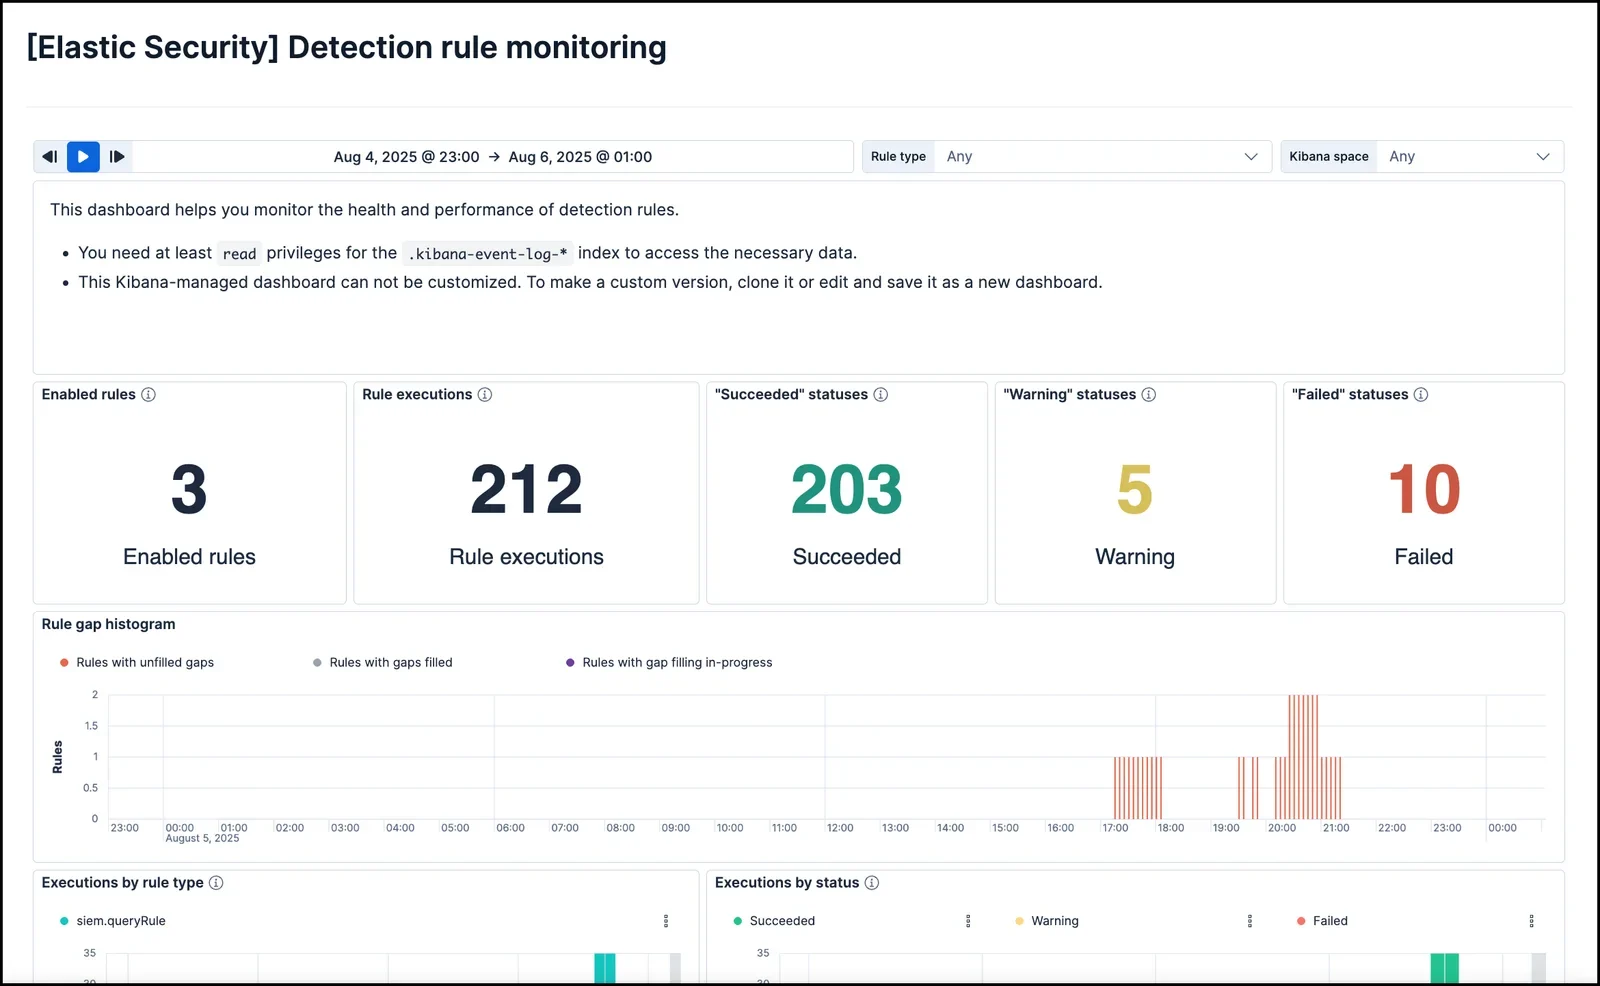
入侵检测告警异常的核心在于规则引擎与数据流的匹配度。排查时首先确认规则是否已正确加载并处于启用状态,许多平台存在规则版本未同步或冲突导致静默失效的情况。其次检查匹配条件与数据源完整性,例如规则依赖的src_ip或http.uri字段若在前置解析阶段被丢弃,规则将无法命中。阈值与时间窗口配置不当常引发误报或漏报,如将单IP登录失败阈值设为1次,极易触发正常运维误报;而时间窗口过长则可能掩盖低频慢速攻击。区分真实攻击与误报需结合上下文流量特征与业务基线。安全验证方法应避免直接在生产环境注入恶意流量,推荐使用隔离沙箱回放PCAP流量,或使用合规的测试工具构造特定请求触发规则,观察控制台是否生成对应事件ID与时间线记录。
验证修复结果并避免日志与检测系统的常见坑
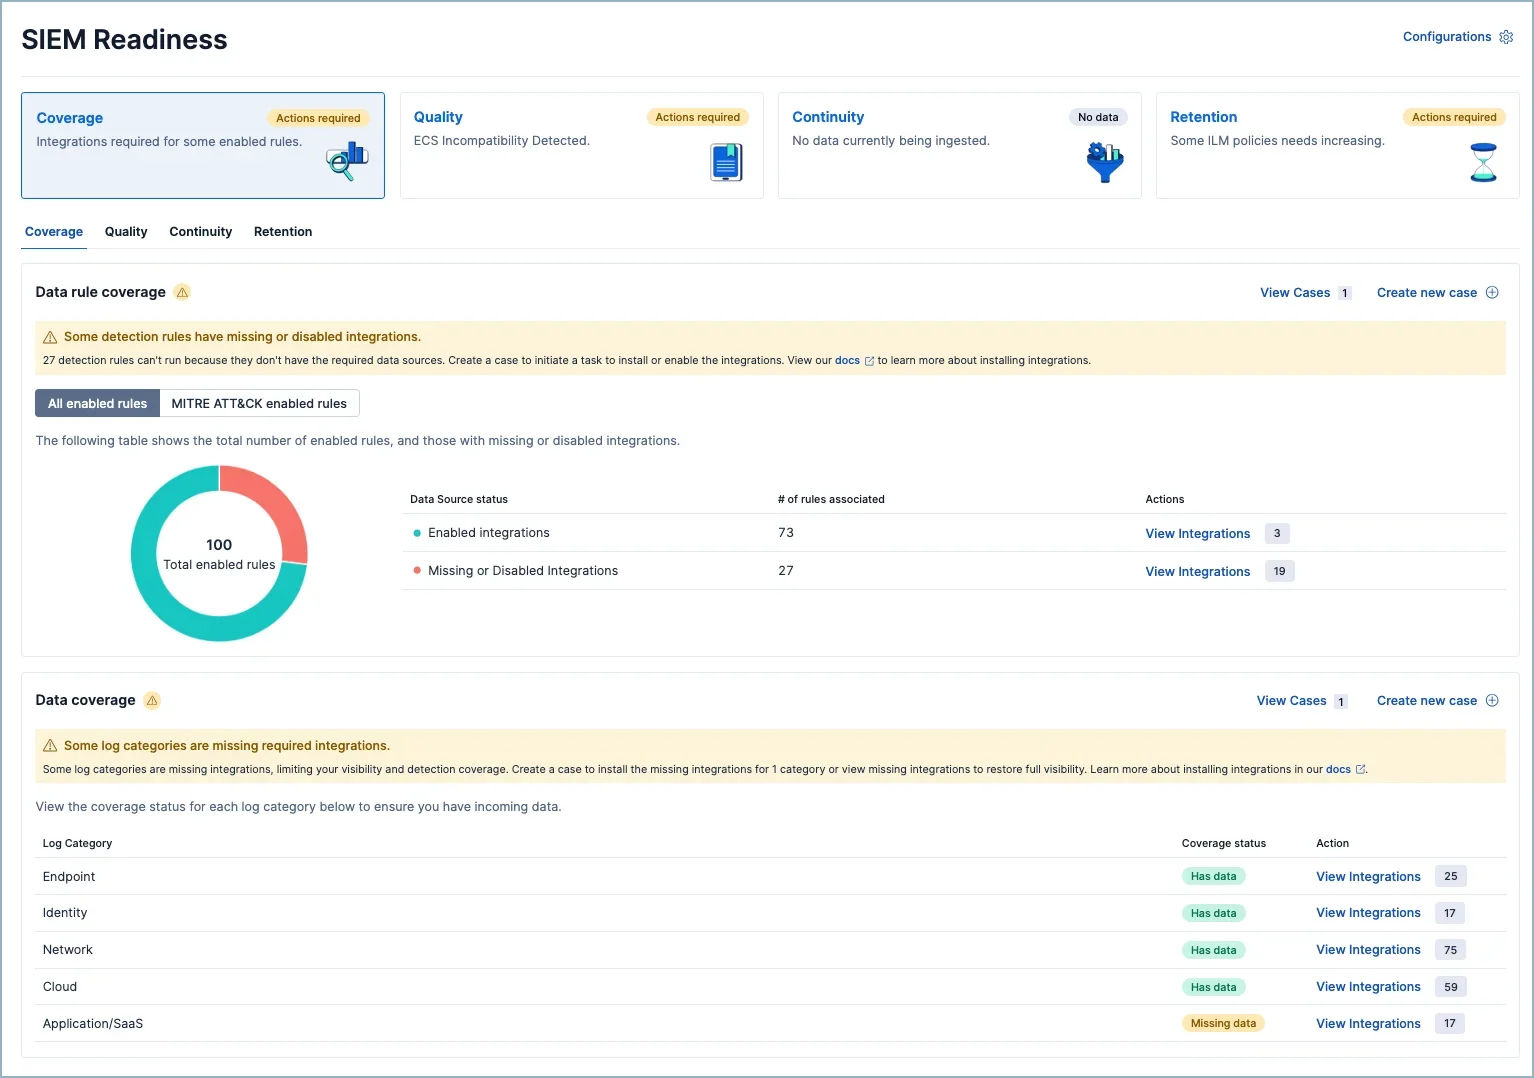
修复完成后必须进行闭环验证,确保系统恢复预期能力。可通过模拟正常业务事件(如使用logger命令生成测试日志)检查日志是否完整上报至分析端,并在SIEM中查询对应时间戳与字段。随后验证检测链路,确认规则命中后告警能否正确路由至工单或通知渠道。日常运维中需重点规避以下常见陷阱:一是权限与磁盘空间,日志目录权限过严会导致采集失败,磁盘满则引发日志截断或轮转异常,建议配置logrotate与监控告警;二是时间同步漂移,跨节点时间差超过5分钟将导致事件关联断裂;三是规则误配与日志洪泛,未加白名单的宽泛规则易引发告警风暴,应结合业务流量基线调优;四是敏感信息暴露,采集前需对密码、身份证号等字段进行脱敏或哈希处理,防止合规风险。定期开展健康巡检与演练是维持检测效能的关键。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









