突破封装边界:读懂 Go 里的 go:linkname 及其代价
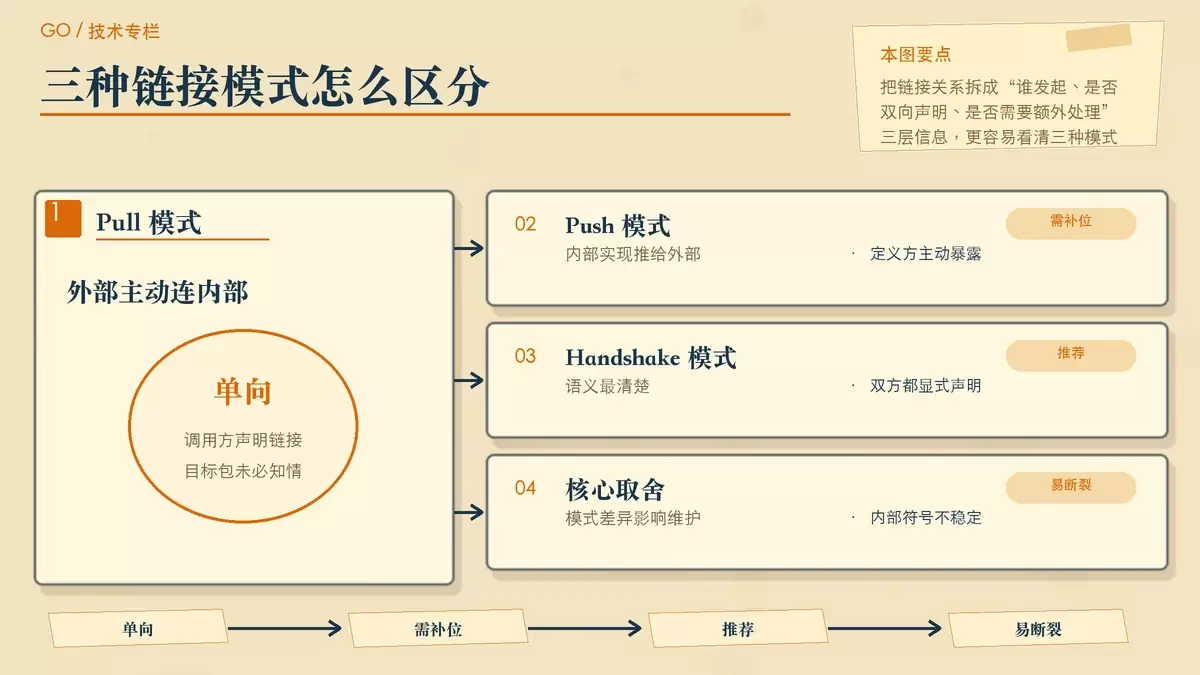
`//go:linkname` 是 Go 提供的一条非常规编译指令,能把当前包符号直接绑定到另一个包的函数或变量,甚至包括未导出符号。它常见于标准库和底层优化场景,但会破坏封装并引入明显的版本与维护风险,理解它的适用边界比会写语法更重要。
2026-08-25
164
`//go:linkname` 是 Go 提供的一条非常规编译指令,能把当前包符号直接绑定到另一个包的函数或变量,甚至包括未导出符号。它常见于标准库和底层优化场景,但会破坏封装并引入明显的版本与维护风险,理解它的适用边界比会写语法更重要。
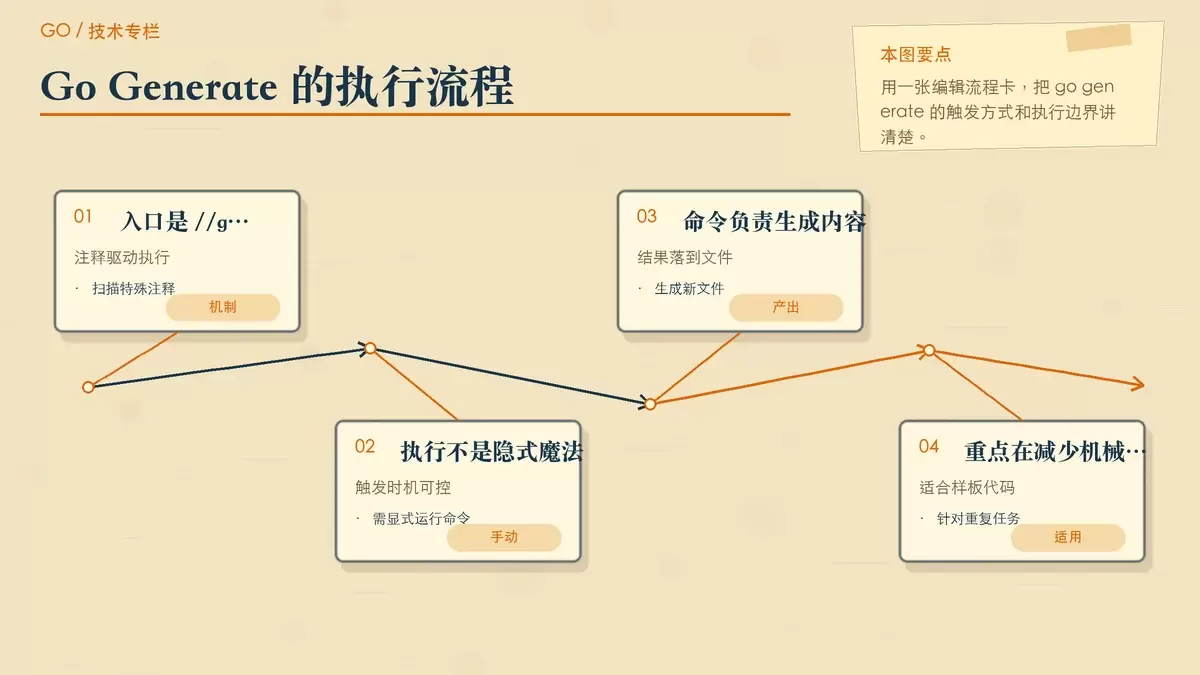
`go generate` 是 Go 1.4 引入的官方代码生成机制,适合处理枚举字符串、Protobuf、Mock、文档等重复工作。它不会在编译时自动执行,优点是流程透明、可控。本文从基本用法、典型场景到落地细节,帮你判断它该在项目里怎么用、该用到什么程度。
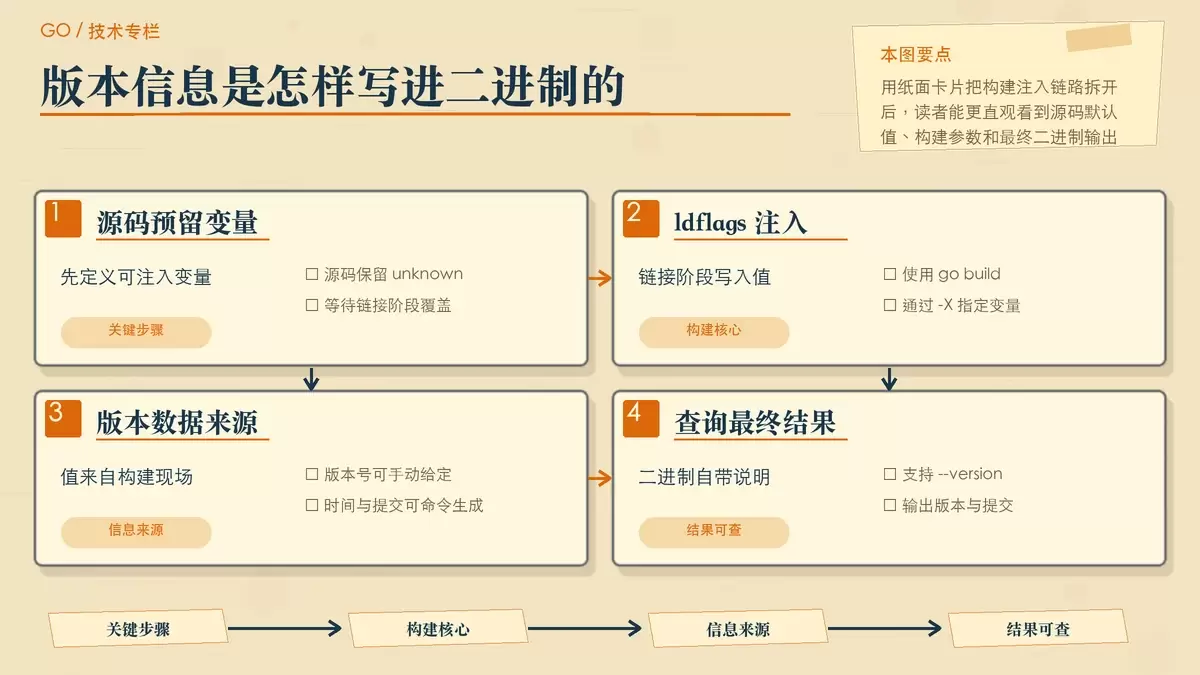
给 Go 程序加上可查询的版本号,不一定要引入第三方库。本文用标准库配合 `go build -ldflags`,演示如何在构建阶段注入版本号、构建时间和 Git 提交,并进一步补上 JSON 输出与 Makefile 自动化构建。 线上排查 Go 程序时,最常见的问题不是服务起不来,而是程序已经在跑,却说不清自己来自哪次构建。
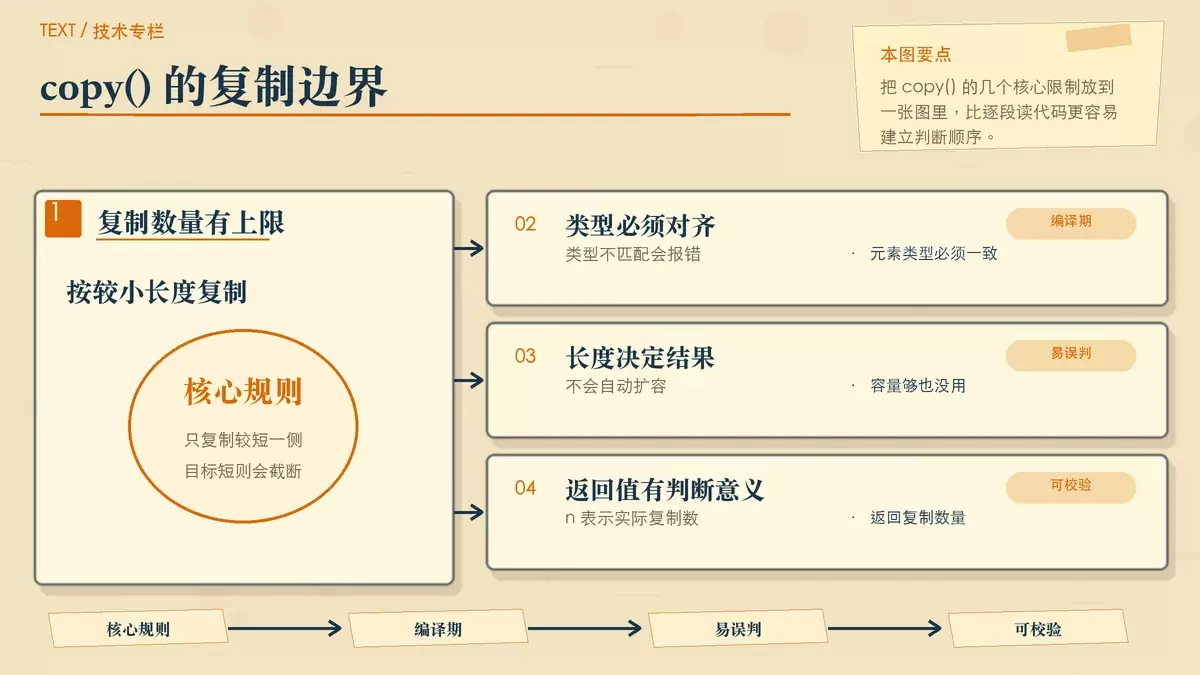
Go 里的 `copy()` 看起来简单,真正容易踩坑的却是切片长度、底层数组共享,以及多维切片只做浅复制这几件事。本文把 `copy()` 的返回值、边界行为和几类高频用法拆开讲清,帮助你判断什么时候直接复制就够,什么时候必须手动做深复制。
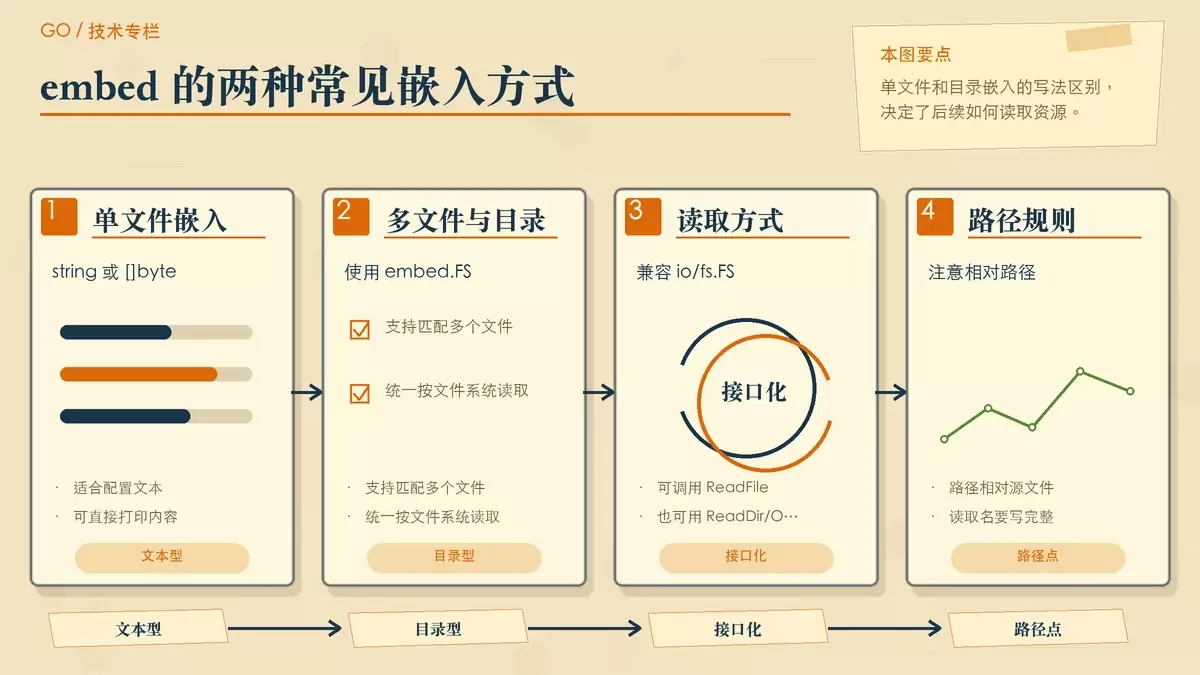
Go 1.16 引入的 `embed` 包,解决了 Go 程序分发时“二进制和静态资源分离”的老问题。本文从单文件、目录嵌入到 Web 服务和 CLI 场景,梳理它的常见用法,并说明体积、只读特性和路径管理这些实际开发里最容易踩到的边界。
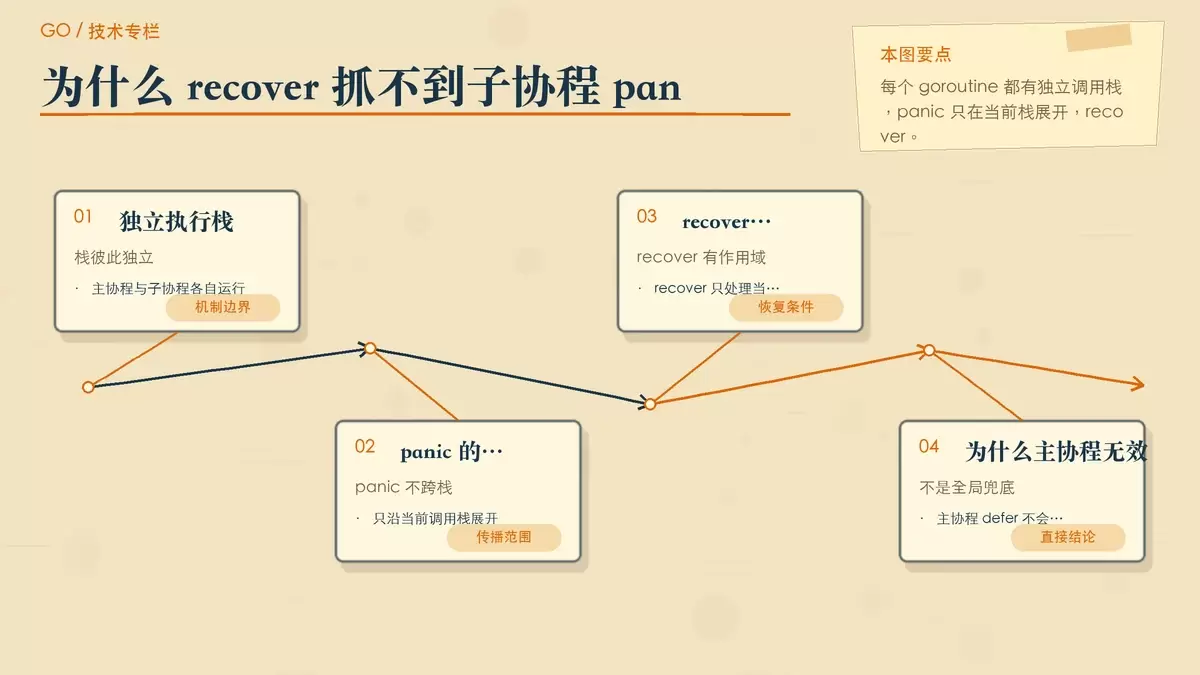
很多 Go 开发者都会遇到这个现象:子协程里明明 panic 了,主协程里也写了 recover,程序却还是直接崩。问题不在 recover 失效,而在 panic 只沿当前 goroutine 的调用栈展开。本文用示例、底层机制和几种常见处理方式,把这个边界讲清楚。
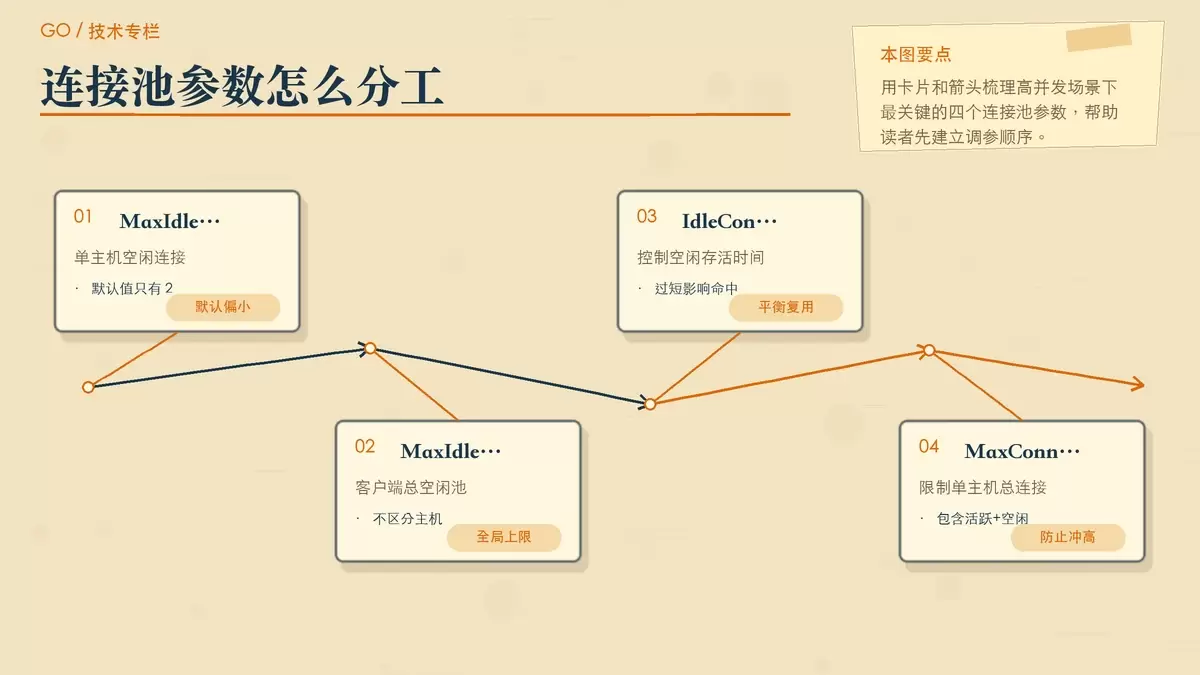
Go 的 `net/http` 自带连接复用,但默认连接池与超时配置偏保守,到了高并发场景很容易拖慢吞吐,甚至引发 `too many open files`。本文围绕关键参数、生产级配置、分层超时和常见误区,梳理一套更适合线上服务的调优思路。
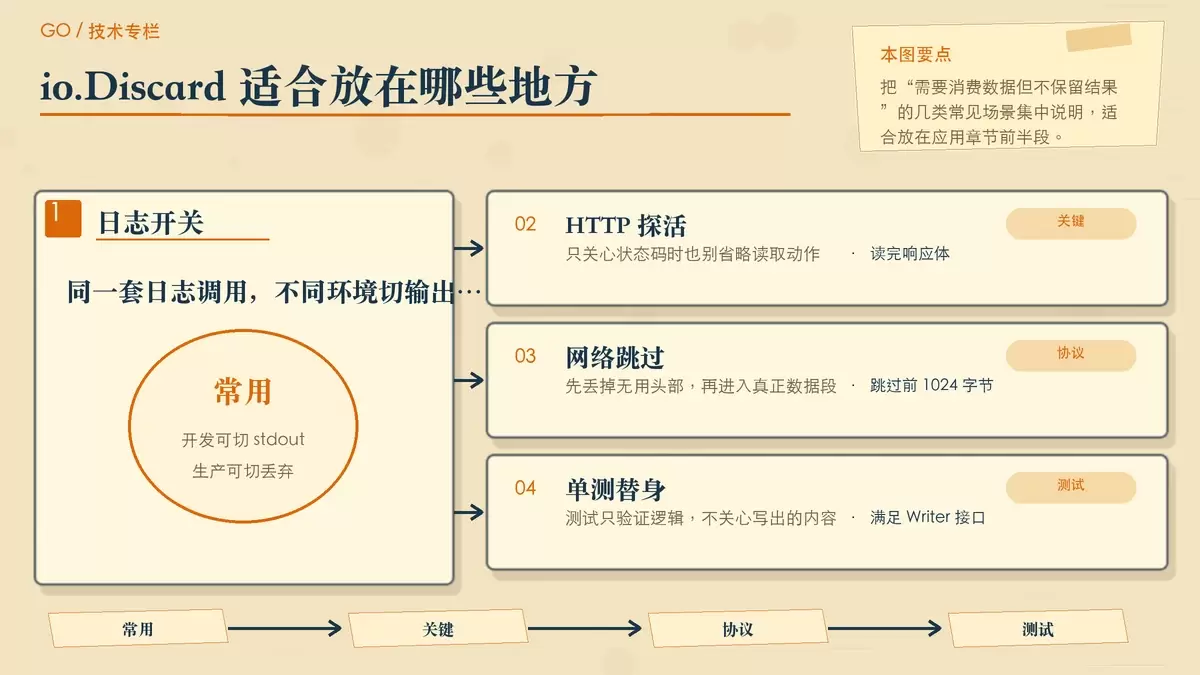
`io.Discard` 是 Go 标准库里一个很小却很常用的对象:它实现了 `io.Writer`,但会把写入的数据直接丢掉。真正值得关注的不是“丢弃”本身,而是它在 HTTP 连接复用、日志开关、网络读取和测试替身中的实际价值,以及 `ReadFrom` 带来的性能收益。
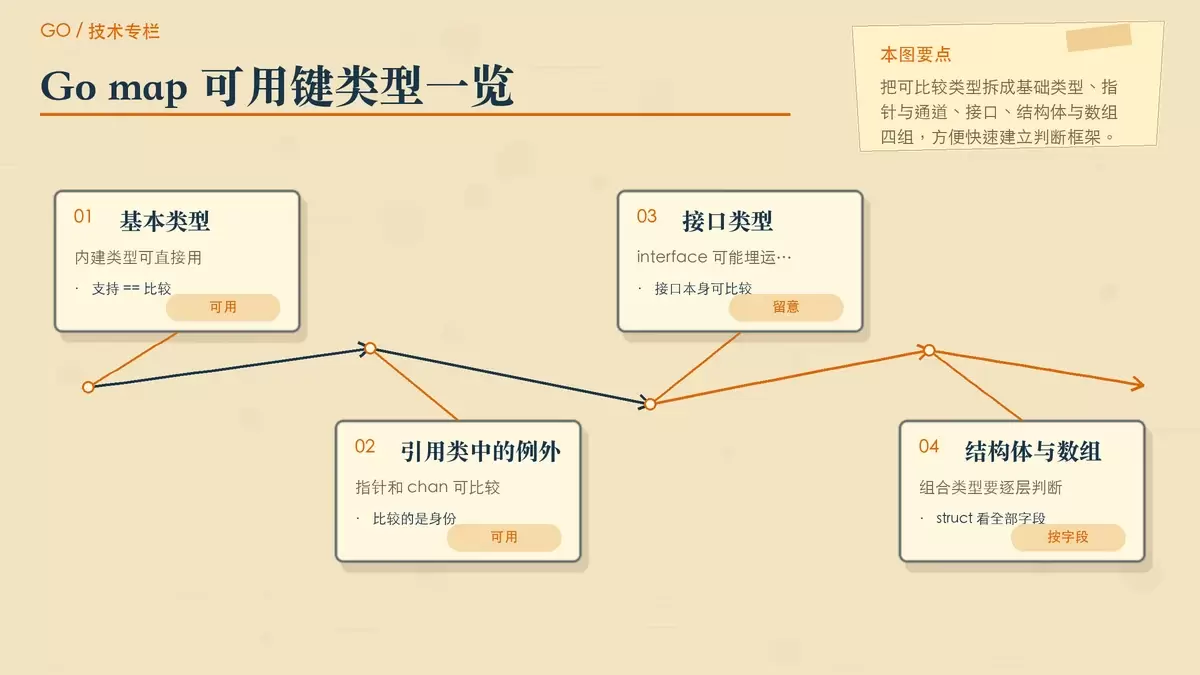
Go 的 map 并不是“什么类型都能当 key”。判断标准只有一个核心:这个类型必须可比较,能参与 == 和 !=。本文按可用、不可用和常见陷阱三部分拆开讲清,顺带给出 struct、interface、slice 替代方案等实用判断方法。 在 Go 里写 map 时,很多人并不是一开始就搞清楚 key 的限制,而是在编译报错或运行时 panic 后才回头排查。
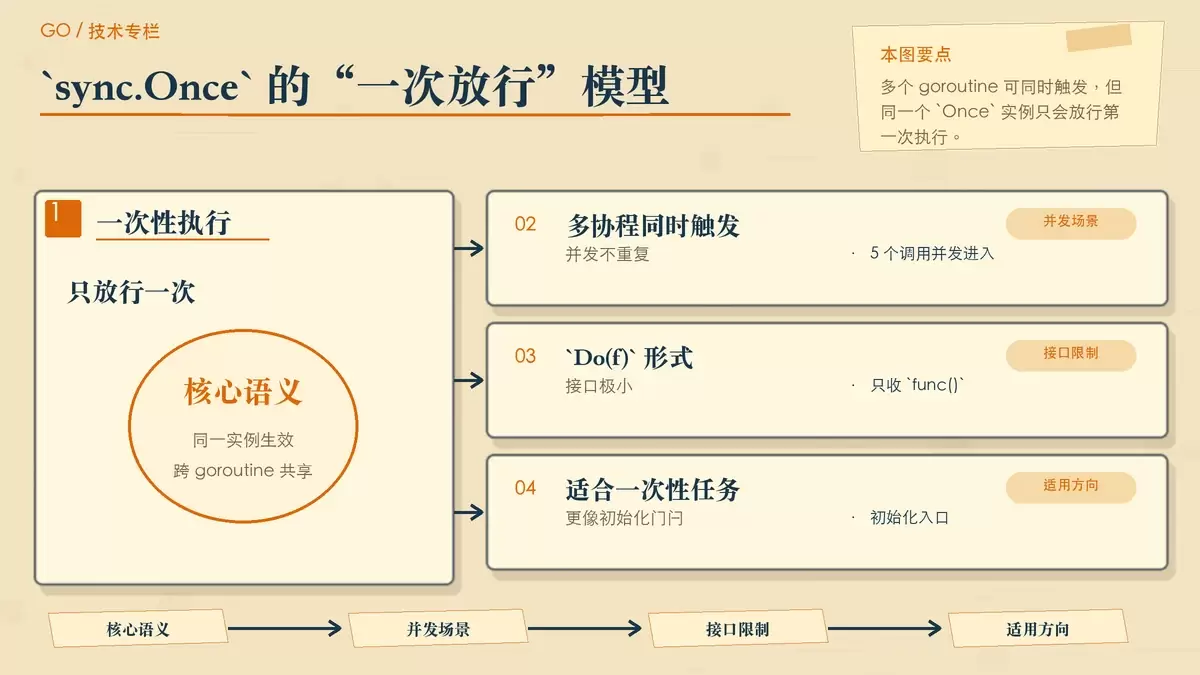
在 Go 并发场景里,很多初始化逻辑既要只执行一次,又不能因为多协程竞争带来额外风险。本文围绕 `sync.Once` 的用法、内部机制、典型场景和踩坑点展开,帮助你判断它适不适合当前任务,以及该怎样安全落地。
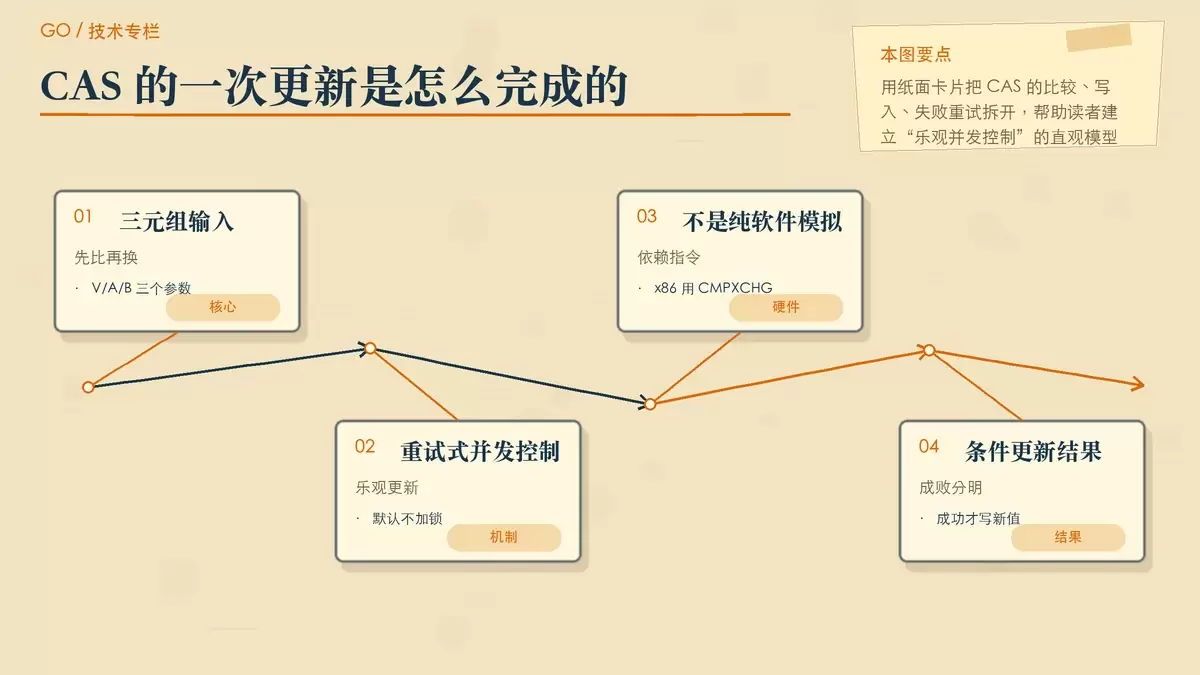
CAS 是 Go 并发里常见的无锁原子操作,适合计数器、状态位和部分轻量同步场景。本文从原理、Go 的 `sync/atomic` 用法、典型案例到适用边界展开,帮助你判断什么时候该用 CAS,什么时候继续用 `Mutex` 更稳妥。
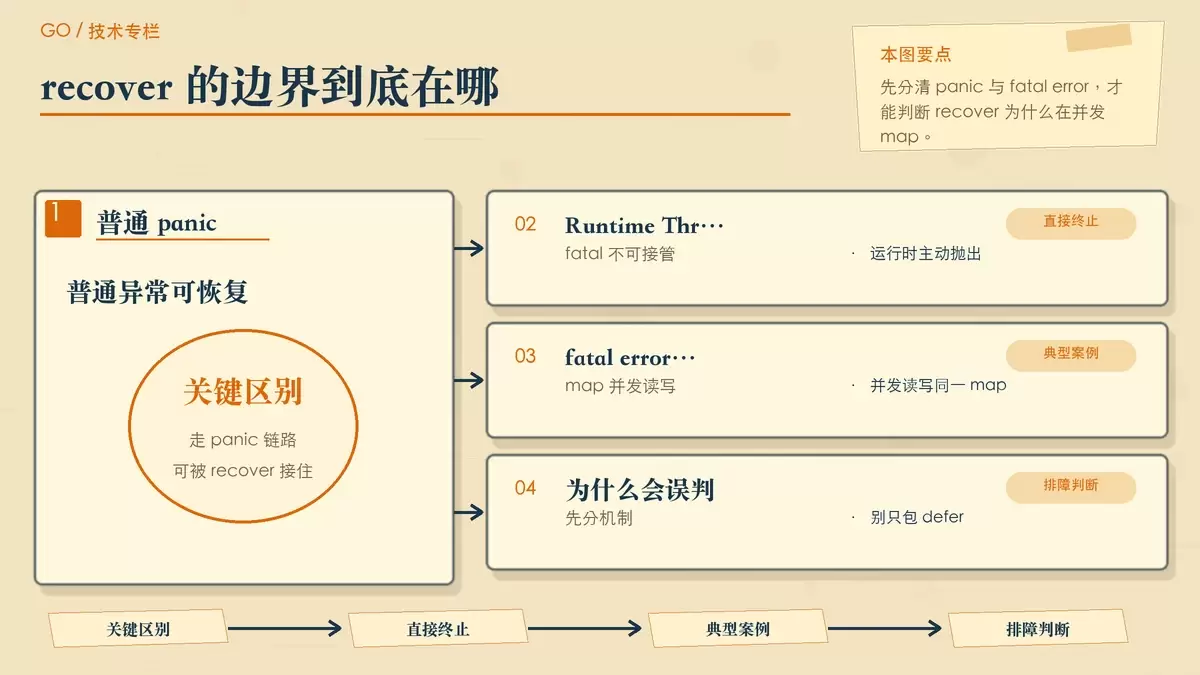
很多人把 `recover()` 当成 Go 的通用兜底手段,但它并不能拦住所有运行时错误。以 `fatal error: concurrent map read and map write` 为例,这类问题属于 Go 运行时直接抛出的致命错误,不走 `panic/recover` 流程。理解这一区别,才能正确判断该靠异常恢复,还是该从并发设计上解决问题。