如何在 CentOS 上分析 Golang 日志:从定位日志到筛选定位
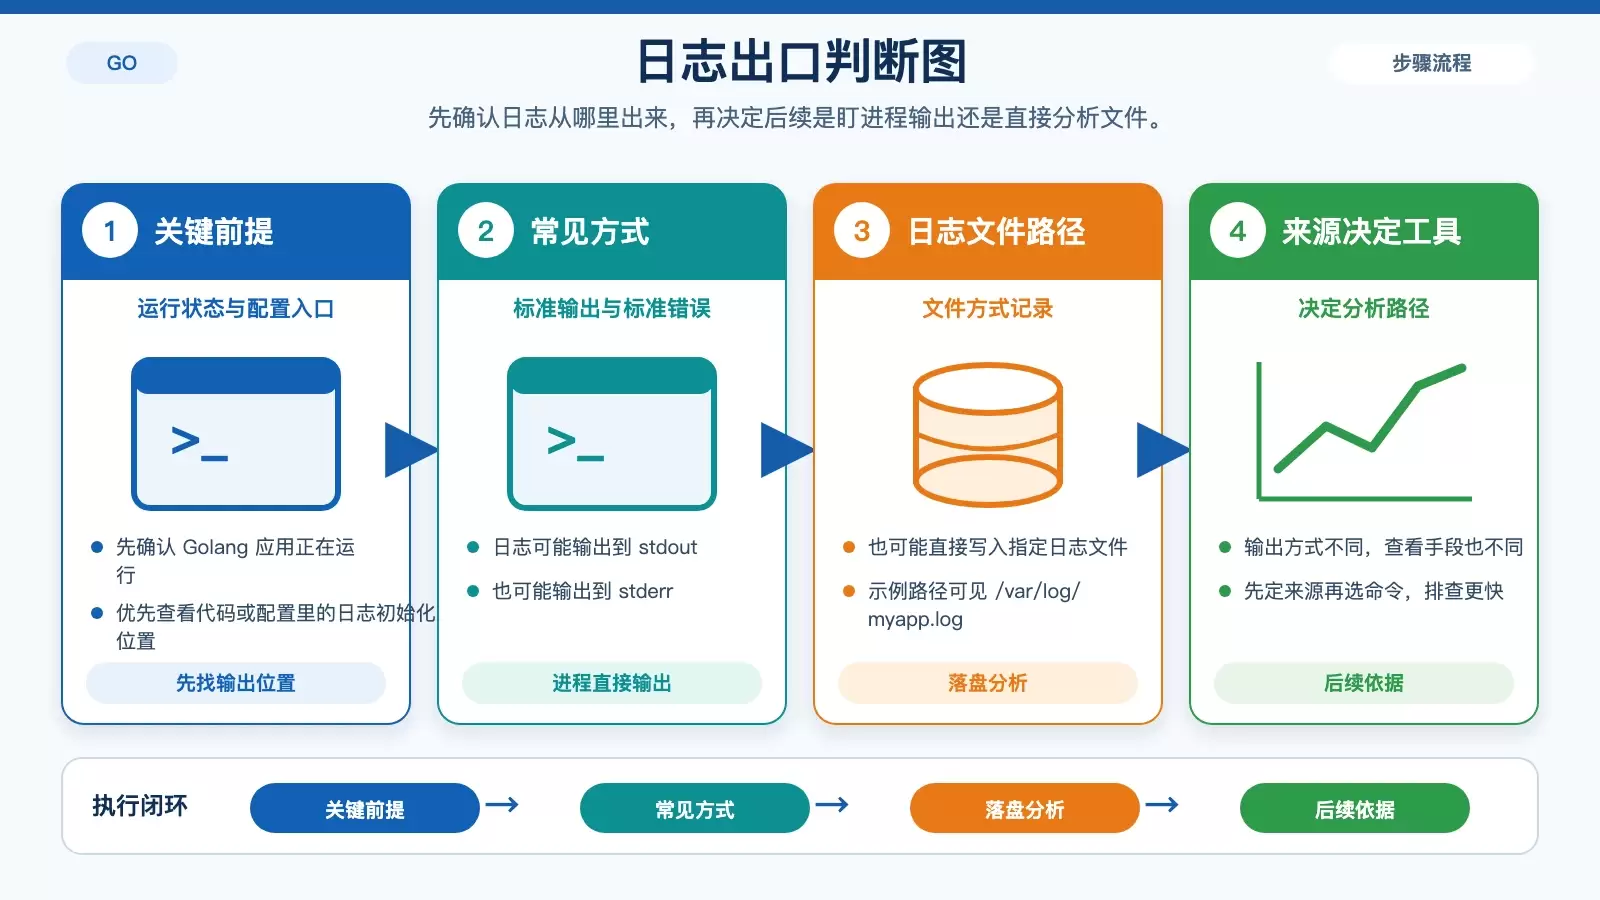
在 CentOS 上排查 Golang 日志,关键不是“看一眼文件”,而是先确认日志出口,再按查看、跟踪、筛选的顺序逐步缩小问题范围。本文整理了常用命令、适用场景,以及使用 logrus、zap 等日志库时更高效的分析思路。
2026-08-24
113
在 CentOS 上排查 Golang 日志,关键不是“看一眼文件”,而是先确认日志出口,再按查看、跟踪、筛选的顺序逐步缩小问题范围。本文整理了常用命令、适用场景,以及使用 logrus、zap 等日志库时更高效的分析思路。
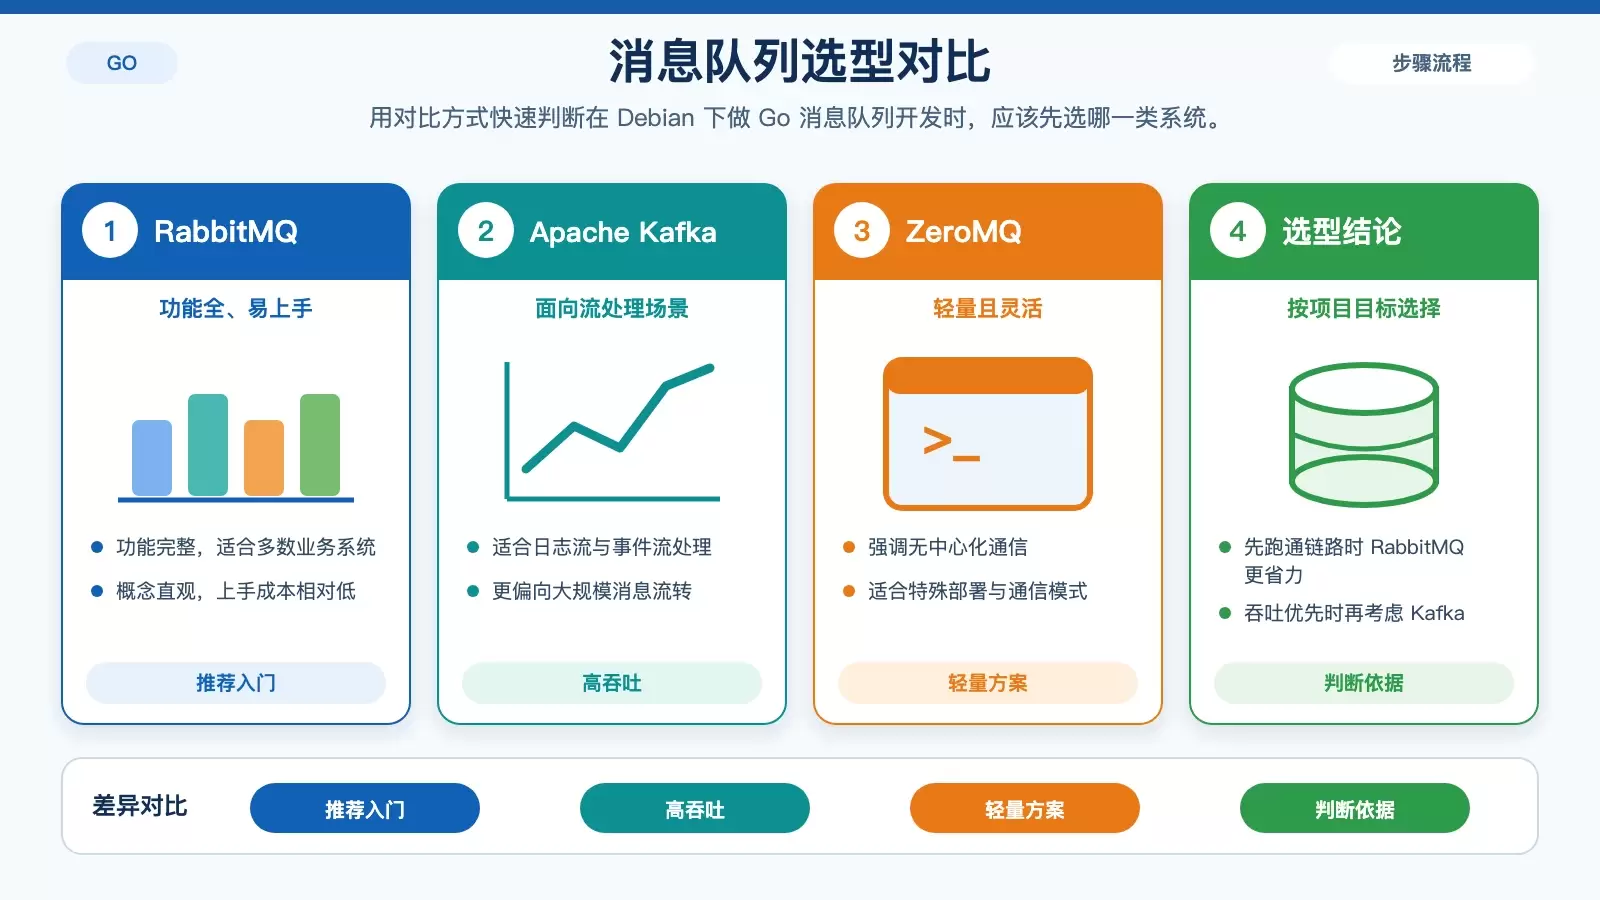
这篇文章用 RabbitMQ 示例梳理 Debian 下 Go 消息队列开发的最短上手路径:先做队列选型,再安装服务端与 Go 客户端库,最后通过生产者、消费者代码完成一次消息收发,并说明跑通后的验证方式与后续加固方向。
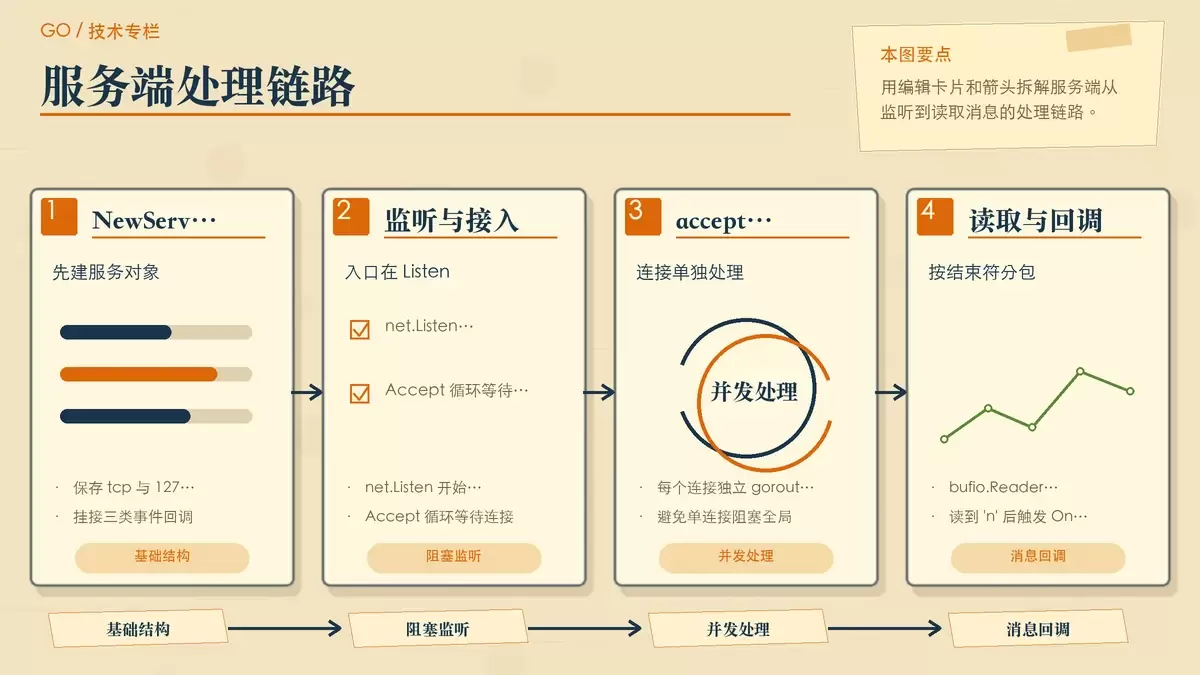
这篇文章用一个简化的 Go TCP Socket 示例,拆开说明服务端、客户端和事件回调的基本写法,并结合源码指出连接建立、消息收发和关闭处理的实际流程。读完后,你可以判断这套封装适合做什么,以及示例里有哪些细节需要留意。
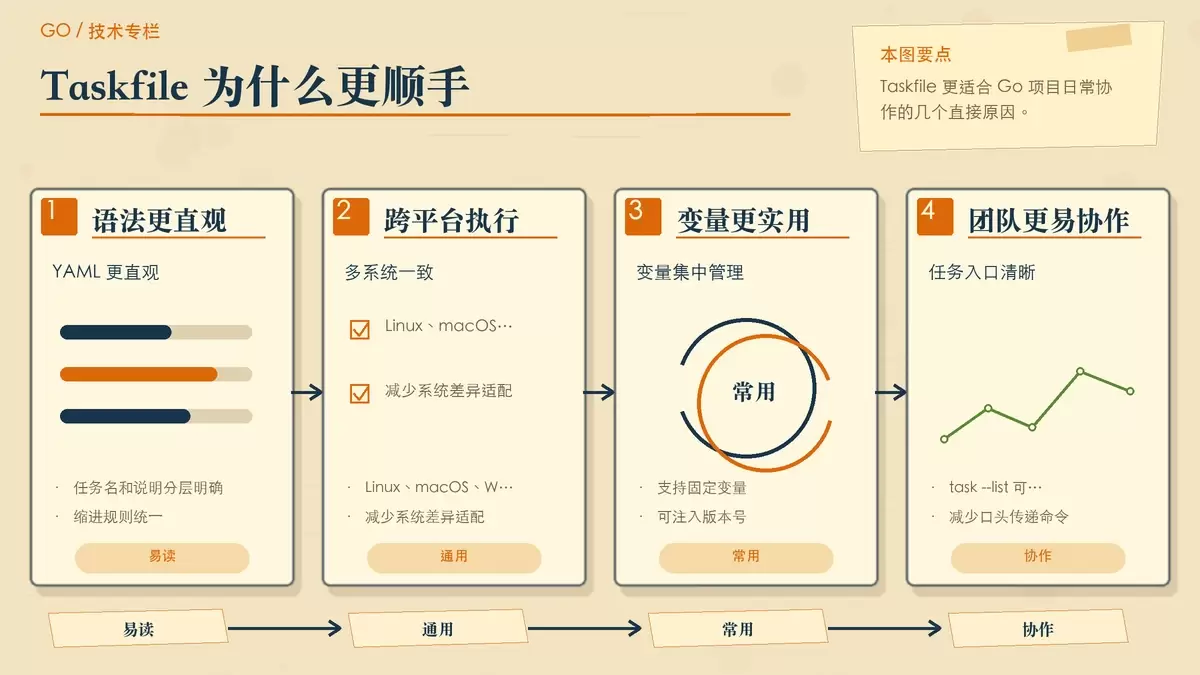
Taskfile 是用 Go 编写的任务运行器,主打用 YAML 管理构建、测试和发布流程。对常写 Go 项目的人来说,它在可读性、跨平台和变量管理上都比 Makefile 更省心,但生态成熟度仍不如后者,是否替换更适合结合项目阶段和团队习惯来判断。
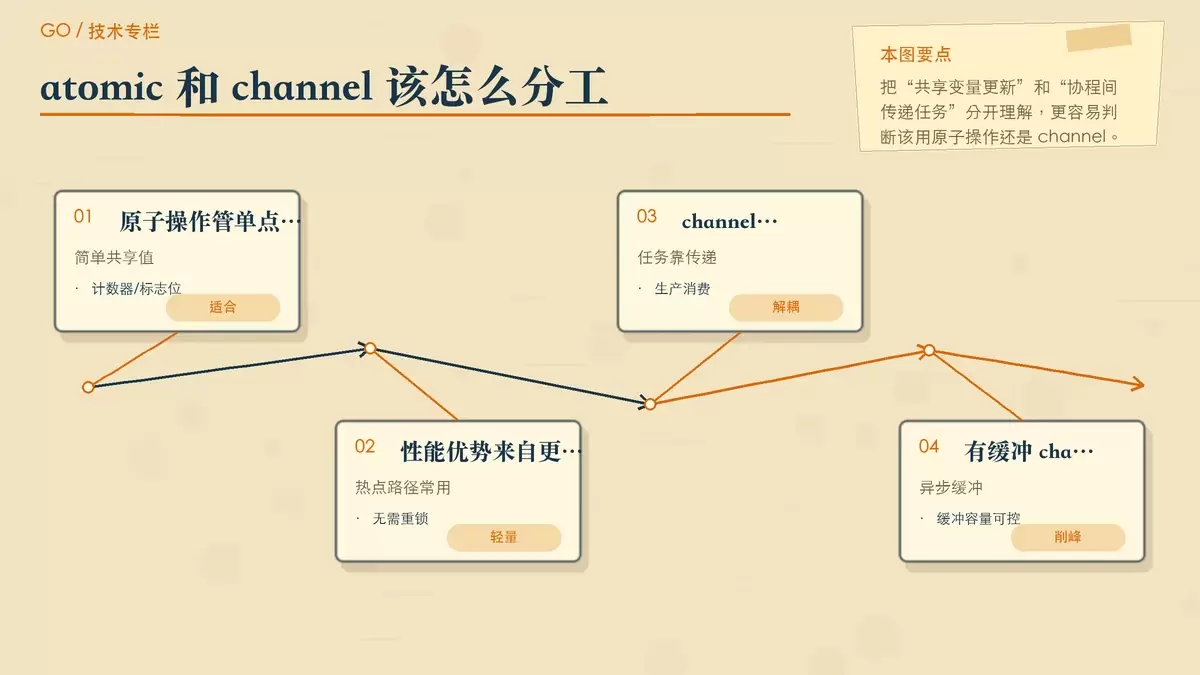
在 Go 的高并发服务里,`sync.Mutex` 很常见,但并不是所有同步问题都该交给锁处理。本文围绕原子操作、`channel`、`sync.Map`、`sync.Pool` 四种方案,拆开讲清它们各自适合解决什么问题、边界在哪里,以及什么时候反而继续用锁更稳妥。
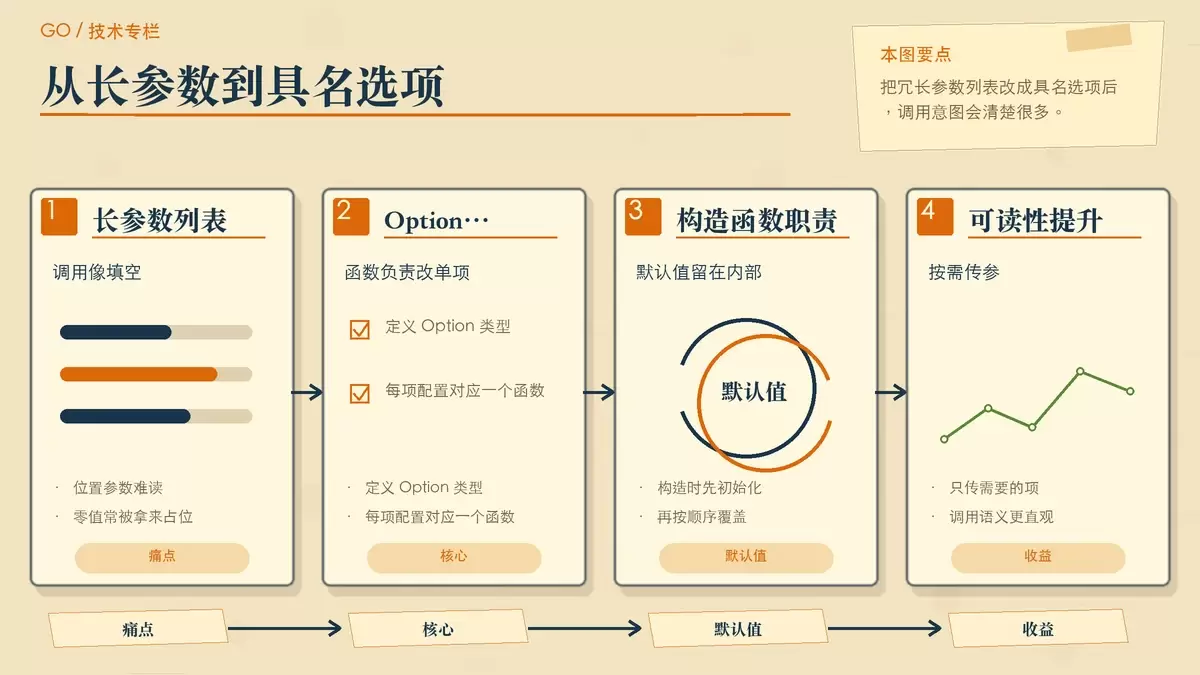
Go 里的函数选项模式,核心是把一长串可选参数改成一组具名配置函数。它适合有默认值、需要长期维护 API 的场景,既能改善调用可读性,也能避免零值歧义,并为后续扩展保留空间。
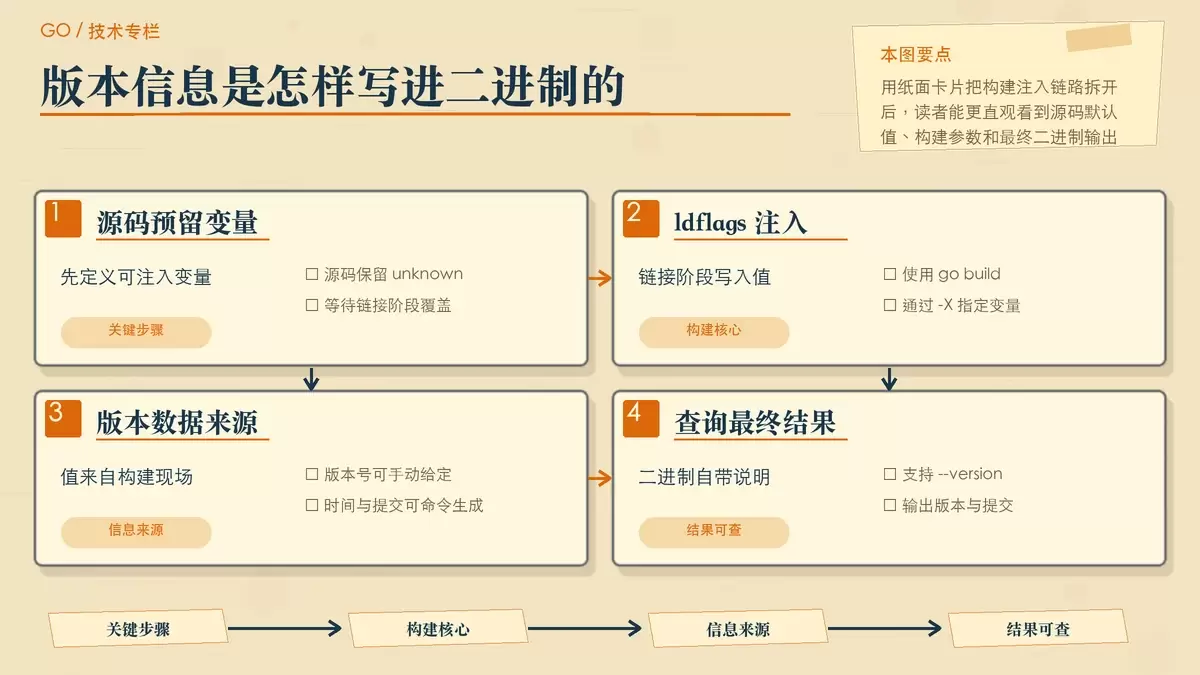
给 Go 程序加上可查询的版本号,不一定要引入第三方库。本文用标准库配合 `go build -ldflags`,演示如何在构建阶段注入版本号、构建时间和 Git 提交,并进一步补上 JSON 输出与 Makefile 自动化构建。 线上排查 Go 程序时,最常见的问题不是服务起不来,而是程序已经在跑,却说不清自己来自哪次构建。
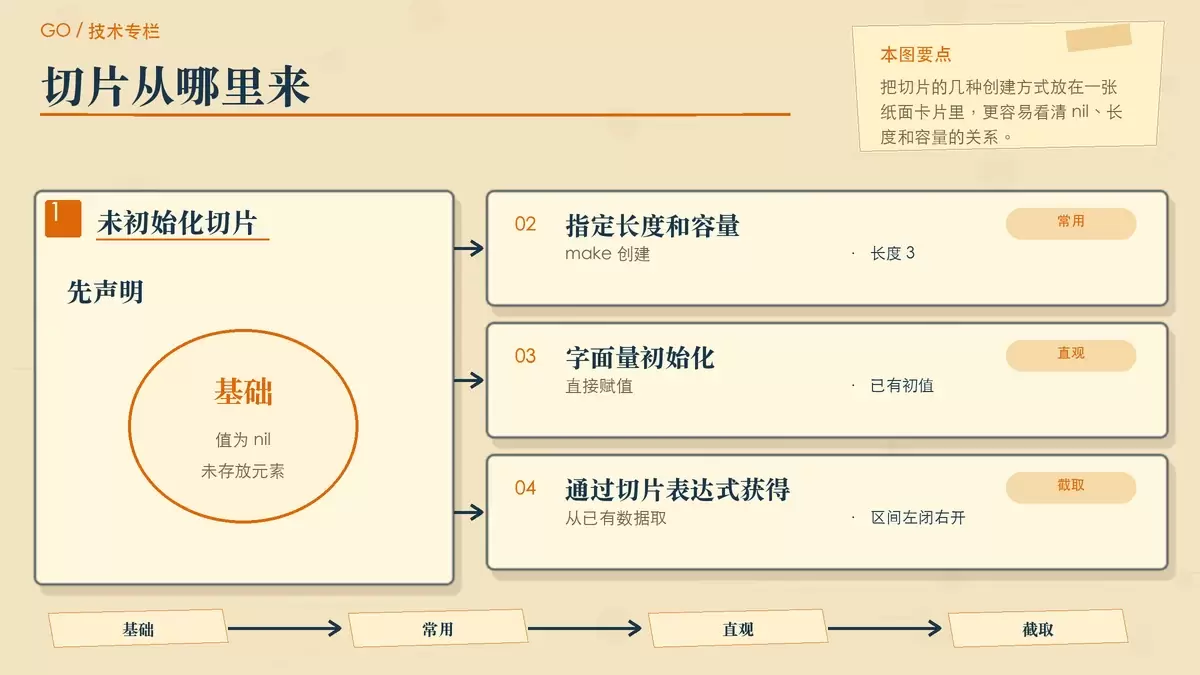
切片是 Go 中最常用的数据结构之一,看起来像数组,却更适合处理长度可变的数据。本文围绕声明、初始化、赋值、追加、再切片和遍历几个高频操作展开,结合代码说明切片怎么创建、何时扩容,以及日常开发里该怎样理解它和数组的区别。
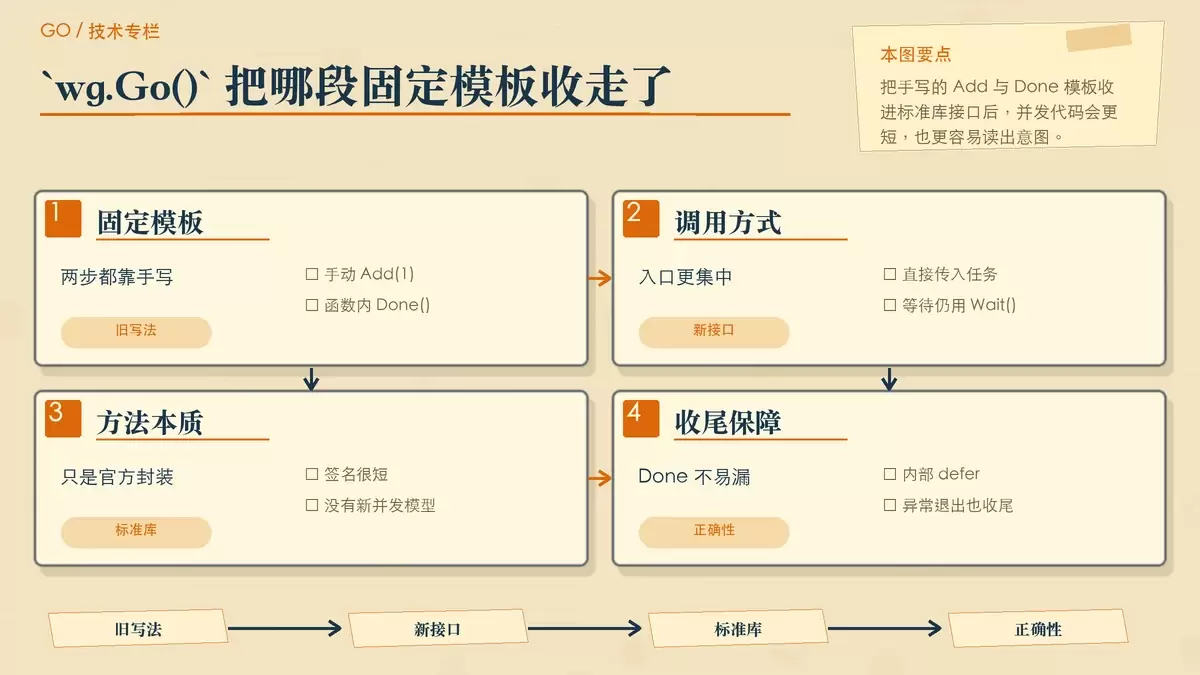
Go 1.25 为 `sync.WaitGroup` 增加了 `Go()` 方法,把常见的 `Add(1)`、`defer Done()` 模板收进标准库。这个改动不大,却直接减少遗漏同步调用的常见错误,也让并发代码的意图更容易被读懂。 在 Go 的并发开发里,`sync.WaitGroup` 很常用,但那段 `Add(1)`、`defer Done()` 的固定模板也几乎人人都写烦过。
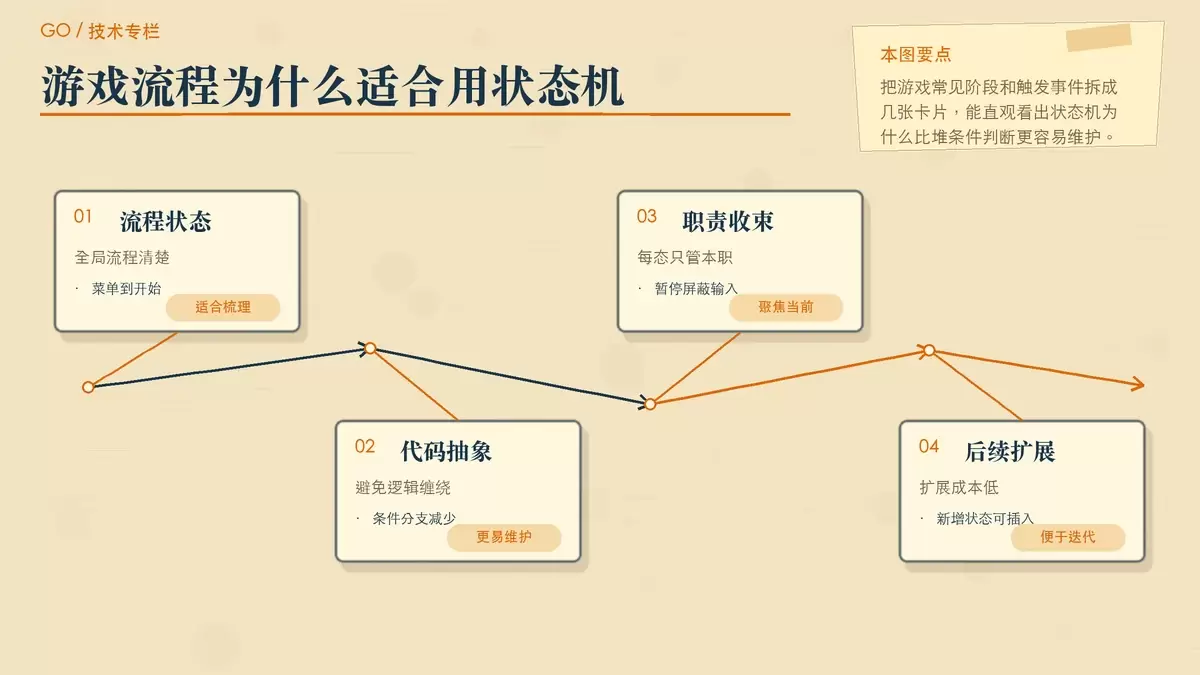
这篇文章围绕 Go 游戏开发里的状态切换问题,梳理了状态机的基本概念、适用场景,以及用 `github.com/looplab/fsm` 落地的方式。重点不在概念堆砌,而在于说明什么时候该上状态机、Go 里通常怎么设计,以及回调机制能帮你把流程控制拆得更清楚。
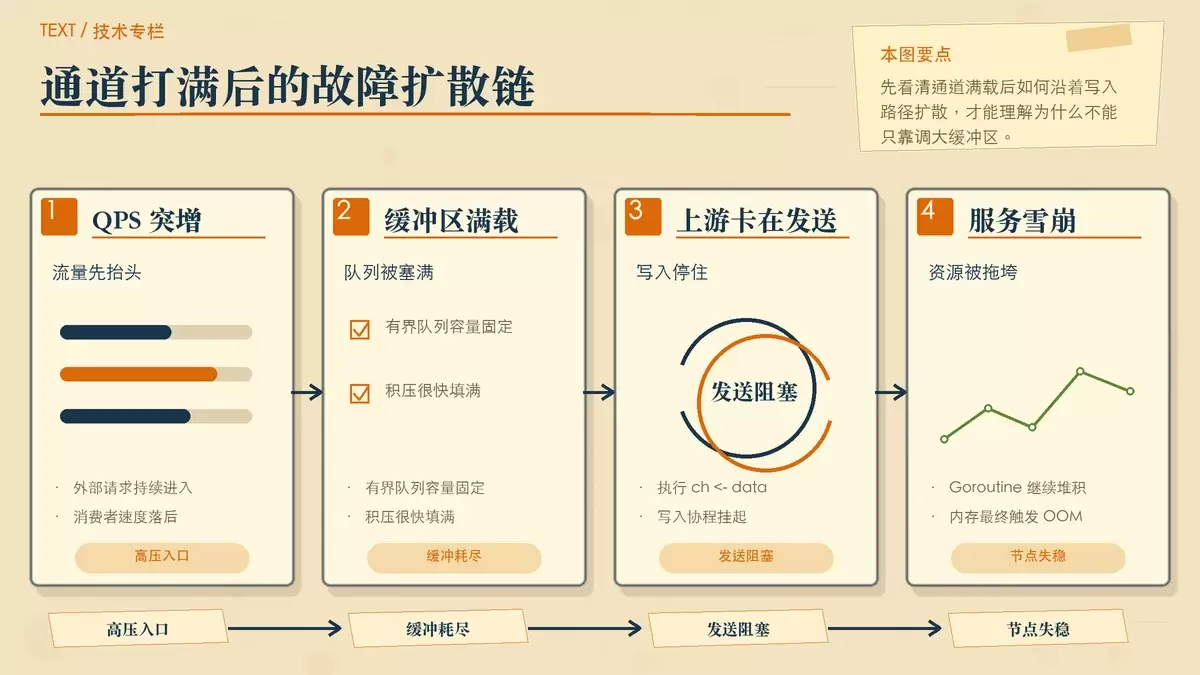
Go 服务里最危险的并发问题之一,不是队列慢,而是有界 Channel 被打满后把写入协程整批卡住。本文从阻塞根因、Go 对非阻塞发送的快速路径优化、业务层封装方式,到失败后的落盘补偿与监控防线,梳理一套更适合线上高并发场景的处理思路。
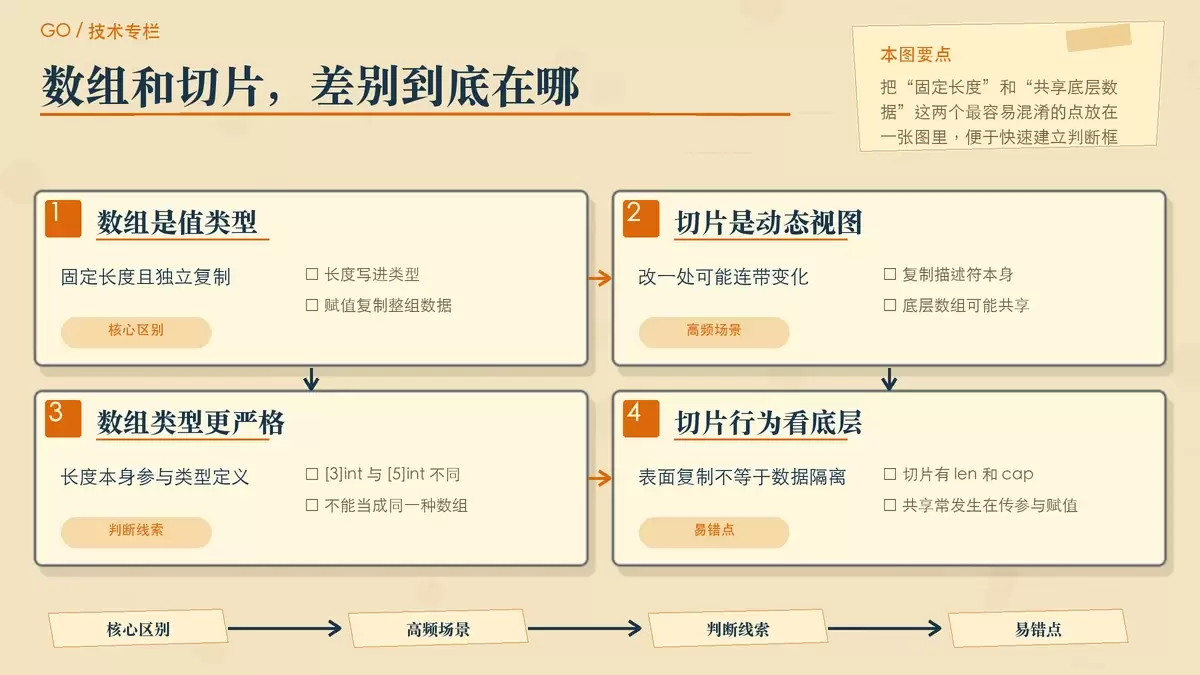
数组和切片都能存放一组同类型数据,但它们在类型定义、传递方式、扩容行为和适用场景上差别很大。理解这些差异后,写 Go 时就能更快判断什么时候该要固定值语义,什么时候该用更灵活的动态结构。