


在百万级 QPS 的微服务场景里,锁往往不是第一个暴露在代码层的问题,却很容易在压测阶段变成吞吐和延迟的隐性瓶颈。Go 标准库已经提供了多种“少锁甚至无锁”的并发工具,关键不在于全部换掉 sync.Mutex,而在于先分清变量同步、协程通信、并发读写和对象复用分别该用什么手段,再用压测结果验证收益。
原子操作:适合简单共享变量,不适合拼复杂流程
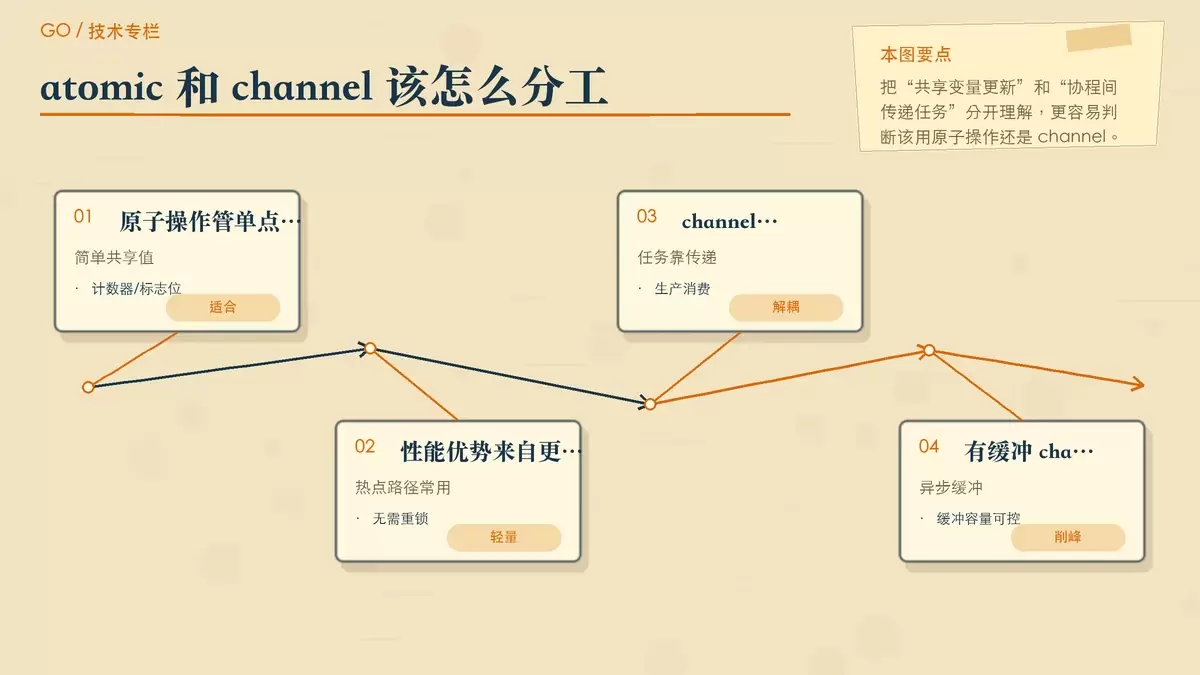
原子操作的优势,在于它直接利用 CPU 指令完成不可中断的更新,不需要像互斥锁那样经历明显的竞争与切换成本。对计数器、状态位、阈值这类简单共享变量来说,它通常是比加锁更轻的同步方式。
Go 通过 sync/atomic 包封装了这类能力,覆盖 int32、int64、uintptr 等基础类型,常见操作包括原子增减、加载、存储,以及比较并交换(CAS)。这类 API 适合做单点更新,写法直接,也更容易在热点路径上控制开销。
// 原子递增计数器(线程安全)
var count int32
atomic.AddInt32(&count, 1)
// 原子读取最新值
current := atomic.LoadInt32(&count)
但它的边界也很明确:原子操作只保证单一步骤本身的原子性,并不自动保证一串逻辑的整体正确。比如“先判断再修改”这类两步以上的流程,如果拆成多个原子调用,仍然可能产生竞态条件。因此,原子操作更适合简单、单一、可独立完成的状态更新,而不是替代所有并发控制。
如果你的场景只是统计请求数、切换标志位、维护一个限流阈值,那么优先考虑原子操作通常是合理的。原文给出的经验数据是,在合适场景下,它相对互斥锁可降低 30% 以上的性能损耗,但这个前提必须是逻辑足够简单。
channel:把同步放进通信模型里
Go 并发模型强调的是 CSP 思路,也就是“通过通信共享内存,而非通过共享内存通信”。这句话落到代码上,最核心的工具就是 channel。它把并发安全和同步机制封装进语言层,开发者不需要围绕共享变量手写加锁逻辑,而是通过消息传递组织协程协作。
这类方式特别适合任务分发、生产者-消费者、结果汇总、协程间通知等场景。和共享一块可变内存相比,channel 的优势不只是“看起来更 Go”,而是能把同步边界写得更清楚,减少因为锁粒度、持锁时间和状态竞争带来的维护成本。
// 有缓冲channel实现任务分发
tasks := make(chan Task, 100)
// 启动消费者协程
go func() {
    for task := range tasks {
        handleTask(task)
    }
}()
在使用上,可以先根据通信模式做区分:无缓冲 channel 更适合“手递手”的同步场景,例如一个协程必须等另一个协程确认完成;有缓冲 channel 更适合削峰和异步解耦,例如高并发请求先进入队列,再由后台消费者处理。
不过,channel 也不是“天然不会出问题”。常见风险是协程泄露:发送方还在写、接收方已经退出,或者消费者永远阻塞等待,最终把资源拖住。文章里给出的建议是结合 close() 或 context.Context 管理生命周期,这一点在服务型程序里尤其重要。
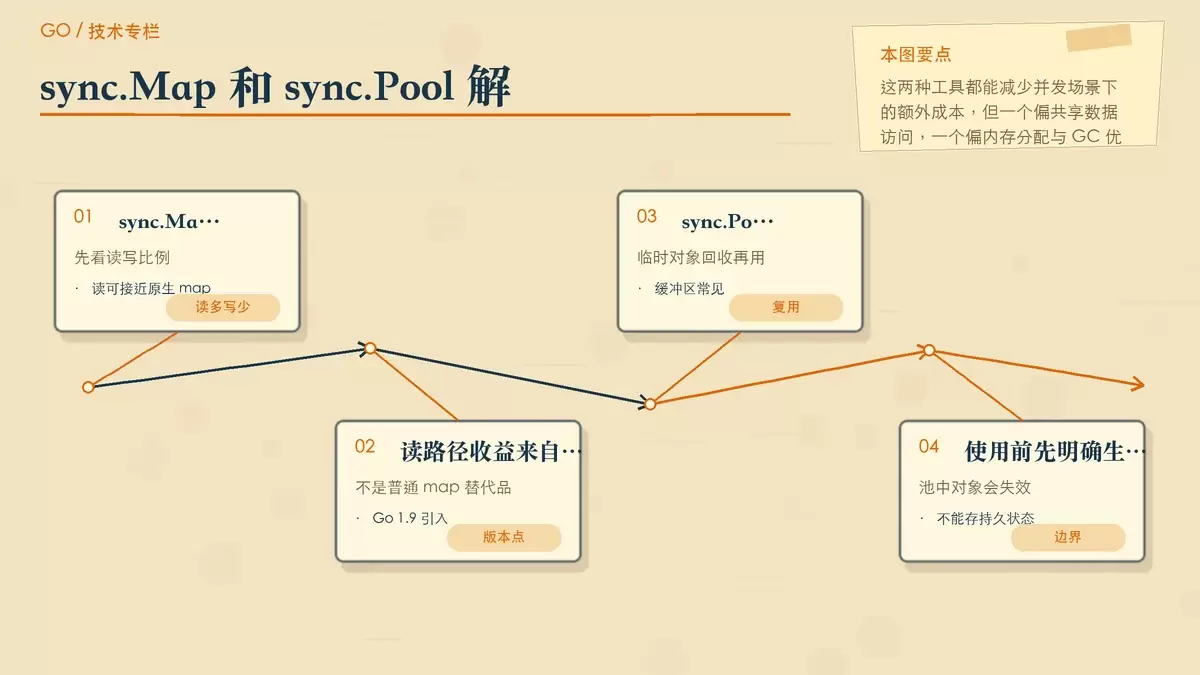
sync.Map:只在读多写少时占优
原生 map 并发读写会直接触发 panic,这是 Go 开发里非常常见的坑。最直接的解决方式当然是外面包一层锁,但如果读请求非常密集、写入只是低频操作,单纯用锁守住整个 map,往往会把读性能也一起拖下来。
sync.Map 正是为这类场景准备的。Go 1.9 引入它之后,标准库给出了一种更偏向“读多写少”的并发映射实现:读操作优先走无锁的 read map,写操作则通过原子机制更新 dirty map。这种读写分离设计,让它在缓存、配置、会话和服务发现这类业务里很有实用价值。
var configMap sync.Map
// 存储配置(低频写)
configMap.Store("db.addr", "127.0.0.1:3306")
// 读取配置(高频读)
if addr, ok := configMap.Load("db.addr"); ok {
    fmt.Println(addr)
}需要注意的是,sync.Map 并不是对原生 map 的全场景升级版。它的收益来自读操作比例高,如果写入本身很频繁,内部协调成本就不一定比 RWMutex + 原生map 更低。原文给出的经验阈值是:当读占比超过 80% 时,可以优先考虑 sync.Map。
另外,遍历时不能像普通 map 一样直接 range,而要通过 Range 方法处理。这样拿到的是基于 read map 的遍历视图,能够避免迭代过程中被并发修改打断,这也是它和原生 map 使用习惯上最需要适应的一点。
sync.Pool:重点不是并发读写,而是减少分配和 GC
很多人第一次接触 sync.Pool 时,会把它理解成一个线程安全容器,但它真正解决的问题,其实是高并发场景下的临时对象创建成本。请求越密集、对象越短命,内存分配和回收越频繁,GC 压力也会越明显,最终表现为延迟抖动和吞吐波动。
sync.Pool 由 Go runtime 提供,用来缓存可复用的临时对象。它会为每个逻辑处理器 P 维护本地池,因此很多访问路径不需要额外加锁,这也是它在高并发下仍然高效的原因。适合放进池里的,通常是字节缓冲区、序列化中间对象、短生命周期上下文等可重复使用的资源。
// 初始化字节缓冲区池
var bufPool = sync.Pool{
    New: func() interface{} {
        return make([]byte, 1024)
    },
}
// 从池获取缓冲区
buf := bufPool.Get().([]byte)这一类优化最容易犯的错误,是把它当成可靠缓存或者状态存储。事实上,sync.Pool 里的对象可能在 GC 时被清掉,所以它只能保存临时对象,不能承载需要持久存在的业务状态。另一个常见问题是对象复用不彻底,比如缓冲区没有重置就再次交给下一次请求使用,导致脏数据串出。
因此,使用 sync.Pool 时至少要守住三条线:只放临时对象;每次取出后先重置状态,例如 buf = buf[:0];用完后及时通过 Put() 放回池中。做到这几点,它对降低分配次数和缓解 GC 压力会很直接。
落地时怎么选:先看问题类型,再看压测结果
无锁编程真正难的地方,不是 API 本身,而是不要把“少锁”理解成一种统一答案。原子操作、channel、sync.Map、sync.Pool 四类工具,分别对应的是简单变量同步、协程通信、读多写少的共享映射,以及临时对象复用。只有问题类型和工具匹配,性能优势才可能兑现。
另一个常被忽略的点,是可维护性。用 channel 做同步,通常会比手写一套复杂自旋逻辑更可读;但如果业务流程本来就跨越多个条件分支,强行改成原子或 CAS 方案,最后很可能让代码更难理解,也更难排查问题。并发优化不能脱离团队维护成本单独讨论。
最后仍然要回到验证环节。文章强调应通过 pprof 和基准测试确认优化是否有效,这一点比“理论上更快”重要得多。尤其在复杂业务里,互斥锁带来的那点损耗,有时未必比一套难维护的无锁实现更贵。判断标准应该是压测数据、热点路径和故障风险,而不是是否彻底摆脱了锁。
归根到底,Go 的无锁编程不是炫技,而是把 CPU 指令、语言通信模型和 runtime 提供的能力用在合适的位置。选对场景、守住边界、用测试兜底,才能真正把并发能力换成稳定的服务性能。









