Python遍历文件目录的三种实现方式详解
本文详细介绍了Python中遍历文件目录的三种常用方法,包括使用os.listdir结合递归、os.path.walk以及os.walk。通过具体代码示例对比了各方法的实现逻辑与输出差异,帮助开发者根据实际需求选择高效的目录遍历方案。
2026-10-13
6

本文详细介绍了Python中遍历文件目录的三种常用方法,包括使用os.listdir结合递归、os.path.walk以及os.walk。通过具体代码示例对比了各方法的实现逻辑与输出差异,帮助开发者根据实际需求选择高效的目录遍历方案。
本文详细介绍Python中实现文件复制的两种常用方法。第一种通过open()打开文件并使用read()和write()手动模拟拷贝过程;第二种利用内置的shutil模块,调用copyfile()实现快速复制。文章提供完整代码示例,帮助开发者掌握不同场景下的文件操作技巧。
本文介绍使用Python将电话簿TeleAddressBook.txt与电子邮件EmailAddressBook.txt合并为AddressBook.txt的方法。通过读取两个源文件,解析姓名、电话及邮箱信息,匹配后写入新文件,实现数据整合。
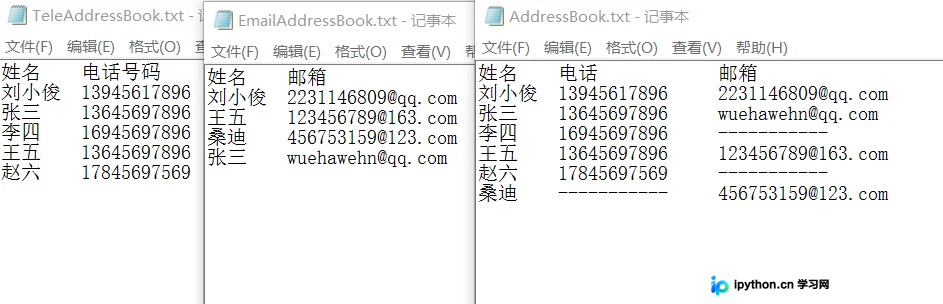
本文介绍利用Python字典结构将两个独立的通讯录文本文件合并为一个完整文件的实例。通过读取电话本和邮箱本文本,利用字典键值对匹配姓名,处理缺失数据并输出合并结果,适用于基础文件操作与数据整合场景。
本文介绍一个使用Python 2.7编写的简易学生管理系统,支持Windows和Linux环境运行。系统通过读写Students.txt文件存储学生姓名、学号及成绩,并实现按分数降序排序功能。代码包含学生类定义、冒泡排序算法及菜单交互逻辑,适合Python语法练习与基础文件操作学习。
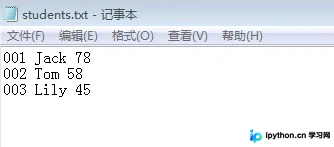
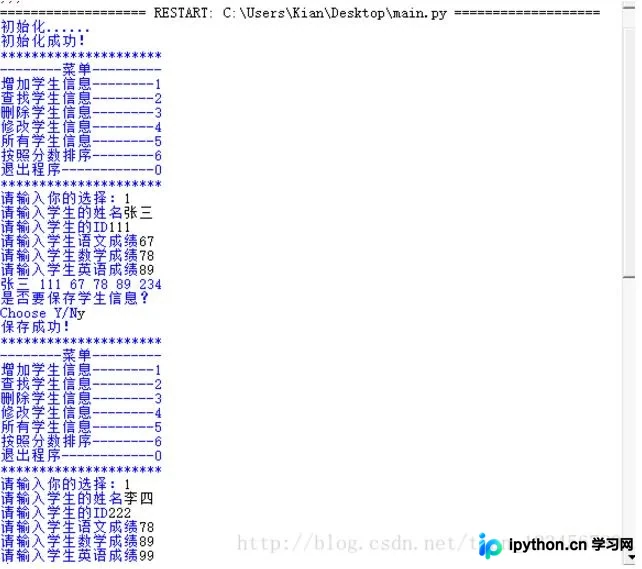
本文详细介绍基于Python的学生成绩管理系统实现。系统涵盖学生信息的录入、存储至students.txt文件、信息打印、按学号修改与删除、成绩排序及查找等功能。重点解析了文件读写初始化逻辑及插入排序算法在成绩管理中的应用,提供完整Python源码供参考学习。
本文介绍在Python中读取CSV文件并剔除指定列后写入新文件的两种实现方式:原生文件IO循环处理与Pandas DataFrame操作。通过对比27万至110万条数据的处理耗时,结果显示Pandas方案在大数据量下效率提升约30%,逻辑更清晰且性能更优。
本文通过Python实例讲解用户登录接口的实现过程。内容涵盖文件读写模式(r/w/a)、with语句的使用,以及利用字典存储用户密码、列表处理黑名单。重点演示如何通过for循环和if判断实现用户名错误5次退出、密码错误3次锁定账户的功能,适合Python初学者理解基础数据结构与逻辑控制。
本文探讨Python中处理大文件解压与读取的常见问题,重点解决因编码格式不一致导致的解压失败。通过引入'ignore'参数规避严格编码检查,并对比不同读取方式的性能,验证了逐行读取处理百万级数据行的可行性与效率,为大数据文件操作提供参考。
本文介绍使用Python定期清理本地目录下创建时间超过一年的文件。首先通过os模块遍历目录手动删除,随后利用shutil模块简化操作。重点讲解如何结合datetime和os.path.getctime判断文件创建时间,实现仅删除过期文件而保留文件夹结构的自动化脚本。
本文整理Python一周快速学习核心笔记,涵盖语法元素、数据类型、函数定义及文件操作。详细解析变量命名、输入输出、分支循环、字符串与元组处理、异常捕获机制及文件读写模式,适合初学者快速掌握Python基础编程技能。